第二十四章 单端口RAM IP核实验
对应《正点原子 ZYNQ FPGA 开发指南》第二十四章(约 P560~P579),本章无外部硬件参与,实验结果通过 ILA 在线调试观察。
本章在讲什么?(先看这个)
前面的实验里,我们存数据用的都是寄存器(reg)。寄存器快,但数量有限——想存几千上万个数据,寄存器资源根本扛不住。FPGA 里专门为此准备了块存储资源 BRAM(Block RAM),是厂商在逻辑资源之外加入的专用 RAM 硬块,速度快、容量大,构成数字电路体系的四大件之一(查找表、寄存器、组合逻辑、静态RAM)。
本章学习 Vivado 里调用 BRAM 的入口:Block Memory Generator IP 核(BMG)。任务是把它配置成一个单端口 RAM(深度 32、位宽 8bit),写模块往里写 0~31 共 32 个数,再读出来比对,仿真确认后用 ILA 上板验证。
本章是存储器三部曲的第一部(单端口 RAM → 伪双端口 RAM → FIFO),BMG 的配置套路学一遍,后面两章就是换选项而已。
核心概念拆解
24.1 RAM 简介
先看存储器的家谱:存储器分随机存储器(RAM)和只读存储器(ROM)。RAM 又分静态 RAM(有电就保数据,不需要刷新)和动态 RAM(需要周期性刷新,典型如 SDRAM/DDR)。本章的 BRAM 属于静态 RAM。
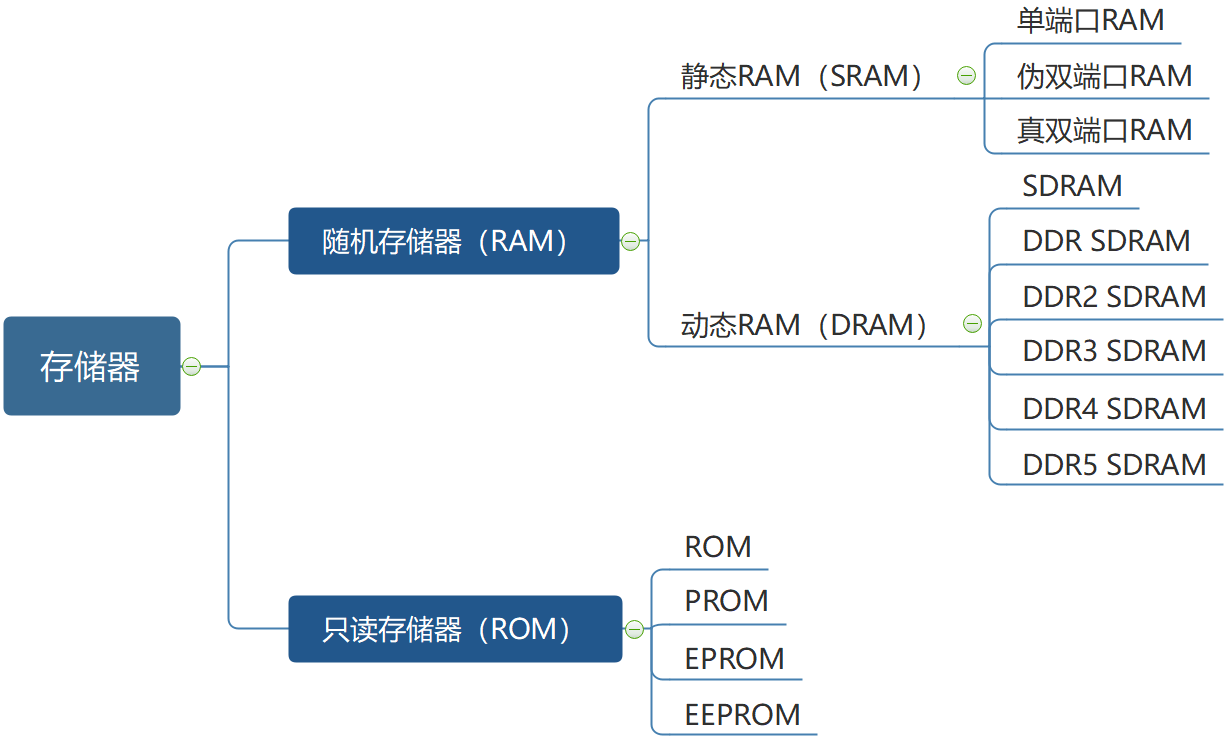
静态 RAM 按端口分三种,这个表格值得背下来:
| RAM类型 | 特性 | 适用场景 |
|---|---|---|
| 单端口 RAM(SP RAM) | 只有一组数据/地址总线,读写共用一个端口 | 上电配置一次的参数表 |
| 伪双端口 RAM(SDP RAM) | A 端口只写、B 端口只读,读写可同时进行 | FIFO |
| 真双端口 RAM(TDP RAM) | A/B 两个端口都能读、都能写 | 需要两个独立写入口的场合(如统计模块) |
有个反直觉的知识点:7 系列器件内部的 BRAM 硬块本身全部是真双端口 RAM,BMG IP 核只是把它"裁剪"配置成单端口或伪双端口来用——下一章我们会看到这一点。
BMG 配置成单端口 RAM 后的接口框图如下。核心信号就六个:写数据 DINA、地址 ADDRA、写使能 WEA(高写低读)、端口使能 ENA、时钟 CLKA、读数据 DOUTA。
24.2 硬件设计
本章只用系统时钟和复位按键,没有新硬件。
24.3 实验任务
将 BMG IP 核配置成单端口 RAM 并读写,仿真观察波形,下载后用 ILA 验证读写结果。
24.4 程序设计
整体模块设计
系统由三部分组成:顶层 ip_1port_ram + RAM IP 核(blk_mem_gen_0)+ 读写控制模块 ram_rw。RAM 是纯内部存储,不需要对外输出引脚,所以顶层只有时钟和复位两个输入。
RAM IP 核配置
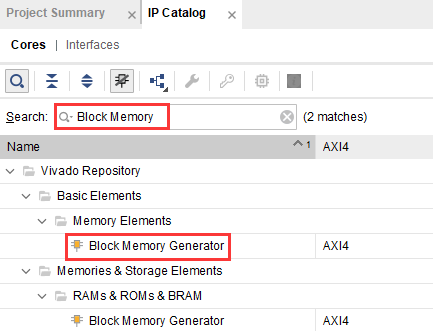
IP Catalog 搜 "Block Memory",双击 Block Memory Generator:
Basic 选项卡:
- Interface Type:选 Native。AXI4 接口一般只在和处理器交互数据时(如 ZYNQ 的 PS/PL 交互)才用;
- Memory Type:选 Single Port RAM(另有伪双端口/真双端口 RAM 和 ROM 可选);
- Write Enable(字节写使能)、Algorithm Options 保持默认。
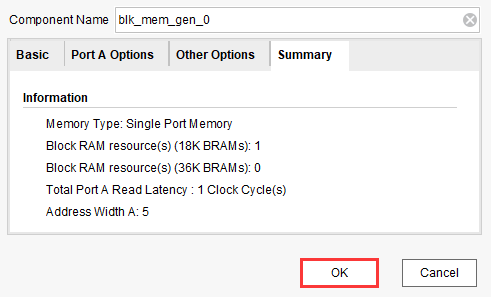
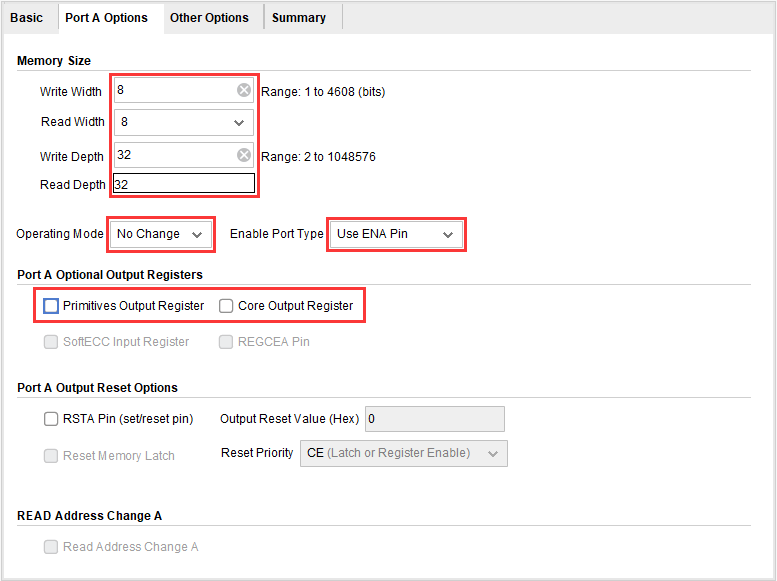
Port A Options 选项卡(重点):
- Write Width = 8、Read Width = 8(读写位宽通常一致;若不同,只支持 1:1、1:2、1:4 等固定倍数比);
- Write Depth = 32,地址范围 0~31(注意位宽×深度不要超过器件 BRAM 总量);
- Operating Mode:选 No Change(不变模式)——三种模式的区别见下文时序图;
- Enable Port Type 保持 Use ENA pin;
- 建议取消勾选 Primitives Output Register(Primitives/Core Output Register 都是给输出加一级寄存器来改善时序的,代价是读数据多延迟一拍;取消后当前周期给地址、下一周期就能读到数据)。
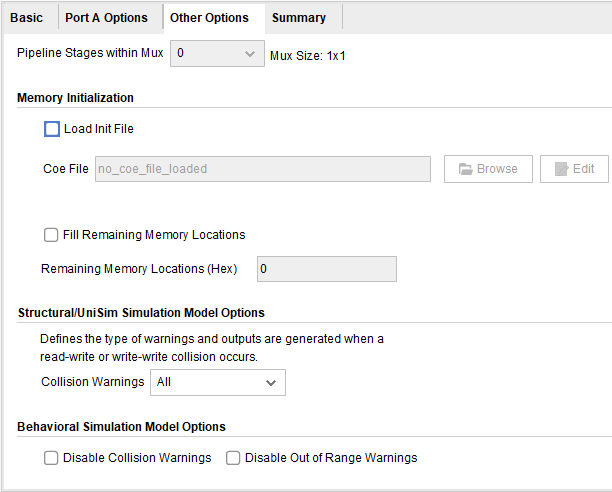
Other Options(初始化 .coe 文件等)和 Summary 保持默认,OK → Generate。之后 Design Runs 里同样能看到 blk_mem_gen_0_synth_1 在做 OOC 独立综合。
三种操作模式的时序图
这是本章最重要的原理知识。WEA=1 时既在写、也涉及读数据线 DOUT 上输出什么,三种模式的答案不同:
写优先(Write First):写入新数据后,把刚写入的数据送到 DOUT 上。即写地址 bb 时,DOUT 输出的就是新写入的 "1111"。
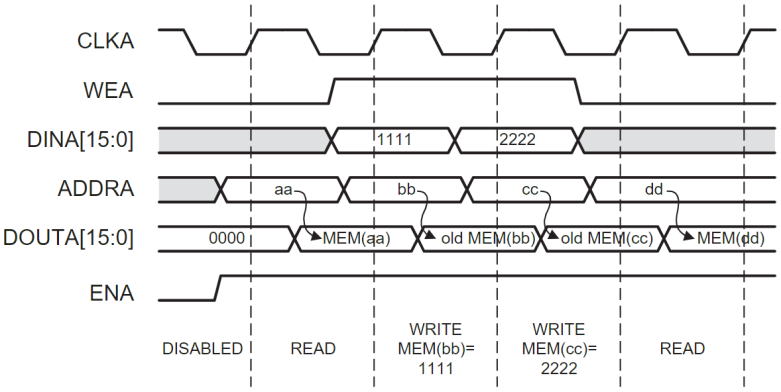
读优先(Read First):写操作时先把该地址的旧数据送到 DOUT,再写入新数据。即写地址 bb 时,DOUT 输出的是写入前的旧值。
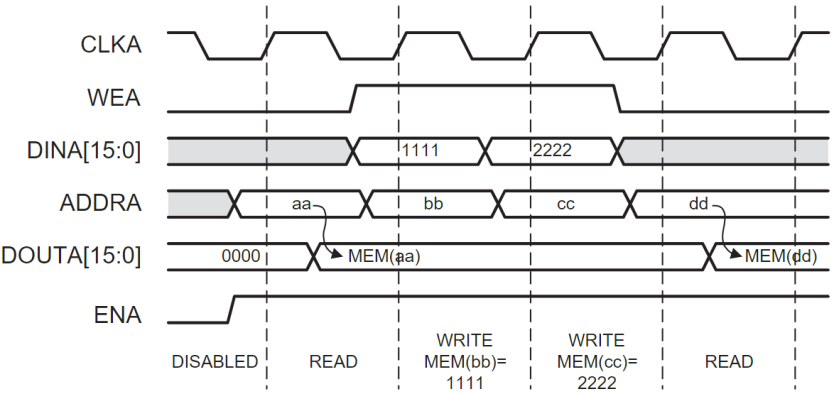
不变(No Change):写操作期间 DOUT 保持不变(维持最后一次读操作的数据),读写彻底分开。
不管哪种模式,读数据都比地址晚一个时钟周期输出——这是同步 RAM 的基本时序,写读出逻辑时时刻要记着。
RAM 读写模块设计
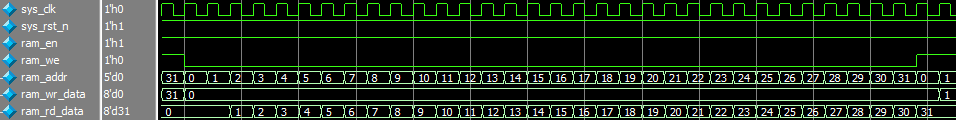
ram_rw 模块负责产生 RAM 需要的全部控制信号。设计思路:计数器 rw_cnt 循环计 0~63,0~31 时拉高 ram_we 写数据(写数据和地址都从 0 累加到 31),32~63 时拉低 ram_we 读数据(地址继续 0~31 循环)。
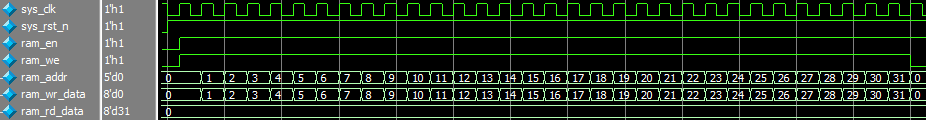
先画波形图确认设计:ram_en 复位后恒为高;读写地址在 0~31 循环;读数据比地址晚一拍出现,读切写的瞬间保持最后一次读出的值。
module ram_rw(
    input               clk         ,  //时钟信号
    input               rst_n       ,  //复位信号,低电平有效

    output  reg         ram_en      ,  //ram 使能信号
    output              ram_we      ,  //ram 读写选择
    output  reg  [4:0]  ram_addr    ,  //ram 读写地址
    output  reg  [7:0]  ram_wr_data ,  //ram 写数据
    input        [7:0]  ram_rd_data    //ram 读数据
);

//reg define
reg    [5:0]  rw_cnt ;                //读写控制计数器

//------------------------------------------------
//rw_cnt 计数范围在0~31,写入数据;32~63 时,读出数据
assign ram_we = (rw_cnt <= 6'd31 && ram_en == 1'b1) ? 1'b1 : 1'b0;

//控制RAM 使能信号
always @(posedge clk or negedge rst_n) begin
    if(rst_n == 1'b0)
        ram_en <= 1'b0;
    else
        ram_en <= 1'b1;
end

//读写控制计数器,计数器范围0~63
always @(posedge clk or negedge rst_n) begin
    if(rst_n == 1'b0)
        rw_cnt <= 6'b0;
    else if(rw_cnt == 6'd63  && ram_en)
        rw_cnt <= 6'b0;
    else if(ram_en)
        rw_cnt <= rw_cnt + 6'd1;
    else
        rw_cnt <= 6'b0;
end

//读写地址信号 范围:0~31
always @(posedge clk or negedge rst_n) begin
    if(rst_n == 1'b0)
        ram_addr <= 5'b0;
    else if(ram_addr == 5'd31 && ram_en)
        ram_addr <= 5'b0;
    else if (ram_en)
        ram_addr <= ram_addr + 5'd1;
    else
        ram_addr <= 5'b0;
end

//在WE 拉高期间产生RAM 写数据,变化范围是0~31
always @(posedge clk or negedge rst_n) begin
    if(rst_n == 1'b0)
        ram_wr_data <= 8'b0;
    else if(ram_wr_data < 8'd31 && ram_we)
        ram_wr_data <= ram_wr_data + 8'd1;
    else
        ram_wr_data <= 8'b0 ;
end

//ILA 在线调试
ila_0 u_ila_0 (
    .clk(clk),             // input wire clk

    .probe0(ram_en),       // input wire [0:0]  probe0
    .probe1(ram_we),       // input wire [0:0]  probe1
    .probe2(ram_addr),     // input wire [4:0]  probe2
    .probe3(ram_wr_data),  // input wire [7:0]  probe3
    .probe4(ram_rd_data)   // input wire [7:0]  probe4
);

endmodule
顶层模块设计
顶层就是把 IP 核和读写模块拉通连线:
module ip_1port_ram(
    input         sys_clk ,  //系统时钟
    input         sys_rst_n  //系统复位,低电平有效
);

//wire define
wire             ram_en      ;  //RAM 使能
wire             ram_we      ;  //RAM 读写使能信号,高电平写入,低电平读出
wire    [4:0]    ram_addr    ;  //RAM 读写地址
wire    [7:0]    ram_wr_data ;  //RAM 写数据
wire    [7:0]    ram_rd_data ;  //RAM 读数据

//------------------------------------------------
//ram 读写模块
ram_rw  u_ram_rw(
    .clk            (sys_clk     ),
    .rst_n          (sys_rst_n   ),
    //RAM
    .ram_en         (ram_en      ),
    .ram_we         (ram_we      ),
    .ram_addr       (ram_addr    ),
    .ram_wr_data    (ram_wr_data ),
    .ram_rd_data    (ram_rd_data )
);

//ram ip 核
blk_mem_gen_0  blk_mem_gen_0 (
    .clka  (sys_clk      ),  // input wire clka
    .ena   (ram_en       ),  // input wire ena
    .wea   (ram_we       ),  // input wire [0 : 0] wea
    .addra (ram_addr     ),  // input wire [4 : 0] addra
    .dina  (ram_wr_data  ),  // input wire [7 : 0] dina
    .douta (ram_rd_data  )   // output wire [7 : 0] douta
);

endmodule
24.5 仿真验证与下载验证
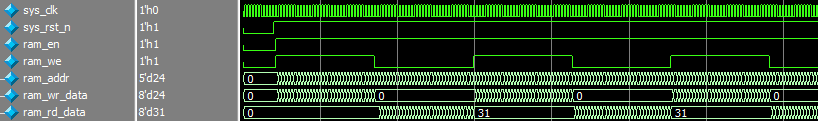
TB 只需时钟和复位两个激励(与流水灯实验相同套路)。仿真波形验证了不变模式的特性:写操作期间读数据线保持不变;写阶段地址和数据同步从 0 累加到 31;读阶段给出地址的下一拍,ram_rd_data 输出 0、1、2……31,与写入值完全一致。
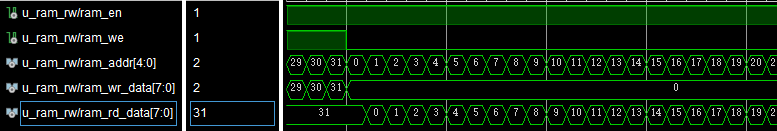
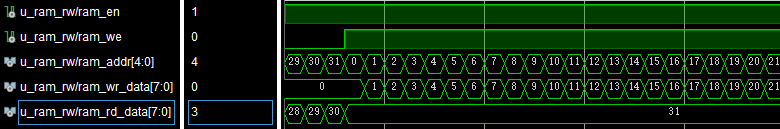
下载验证:本章顶层没有对外输出,引脚只需约束时钟和复位(sys_clk=U18,sys_rst_n=N16,LVCMOS33,外加 create_clock -period 20.000 时序约束)。ILA 已实例化在 ram_rw 模块中,上板后在 Hardware Manager 里触发采集:写操作波形显示地址/数据同步累加,读操作波形显示读出数据滞后地址一拍且数值 0~31 全部正确——与仿真结果一致,实验验证成功。
初学者容易踩的坑
- 读数据晚一拍是常态不是 bug。同步 RAM 给出地址后要等下一个时钟上升沿数据才出现在 DOUT 上。很多人在 ILA 里看到"地址 0 读出的数据是上一个值"就以为 IP 核坏了,其实把波形对齐一拍看就完全正确。
- Output Register 的取舍要想清楚。勾选 Primitives/Core Output Register 能改善时序、提高频率,但读延迟变成两拍。如果你照抄"下一拍出数据"的经验去写状态机,时序就错位了。学习阶段建议不勾。
- Operating Mode 不是随便选的。写优先模式写操作会把新数据冒到读数据线上,读优先模式会把旧数据冒出来——如果你的下游逻辑假设"写的时候读数据不动",就必须选 No Change,否则会读到意外数据。
- 深度和位宽量力而行。Write Depth × Write Width 超过器件 BRAM 总量会直接报错;地址位宽要根据深度算好(深度 32 → 地址 5bit),位宽给小了地址会截断、给大了浪费资源。
- 读写位宽不同时只有固定倍数比可用(1:1、1:2、1:4、1:8、2:1、4:1、8:1、16:1),其它比例 Vivado 不接受。
- RAM 没有输出引脚不代表不用做引脚约束检查。顶层只有时钟和复位两个 IO,XDC 里仍要写 create_clock 时序约束——少了它,时序分析没有基准,综合结果不可信。
小结 & 下一步
本章完成了存储器三部曲的第一部:弄清了静态 RAM 三种端口形态的区别,掌握了 BMG IP 核配置单端口 RAM 的关键选项(Native 接口、Memory Type、位宽/深度、Operating Mode、输出寄存器),并通过仿真和 ILA 验证了"写 0~31 再读出 0~31"的完整流程。ram_rw 这种"计数器切换读写状态"的测试结构还会在后面两章反复出现。
下一步进入第二十五章:伪双端口 RAM 实验——写端口和读端口分开、读写可以同时进行,还会引出读写冲突等重要概念。