 图 1:第 12 章章首插图
这一篇在干嘛?
Linux 能同时读写 Windows 的 NTFS、其他 Unix 的 UFS、网络的 NFS,靠的是内核里的一个抽象层——虚拟文件系统(VFS)。本章讲清 VFS 怎么用超级块、inode、file、dentry 四个对象把千差万别的文件系统抹平成统一的接口,以及挂载、路径查找、open/read/close 和文件锁的底层实现。
VFS 的角色 | 通用文件模型 | 超级块对象 | inode 对象 | file 与 dentry 对象 | 进程与文件 | 文件系统类型与挂载 | 路径名查找 | 系统调用实现与文件锁
VFS 的角色
Linux 成功的秘诀之一是与别的系统舒适共存:你可以透明地挂载 Windows 的磁盘分区、其他 Unix 的文件格式,甚至 Amiga 这种小众系统的盘。做到这一点的就是虚拟文件系统(Virtual Filesystem,也叫 Virtual Filesystem Switch,VFS)——内核中处理所有与标准 Unix 文件系统相关系统调用的软件层,它最大的本事是为多种文件系统提供统一接口。
举个例子,用户执行:
$ cp /floppy/TEST /tmp/test其中 /floppy 是 MS-DOS 软盘的挂载点,/tmp 是普通 Ext2 目录。cp 程序完全不需要知道这两个文件各是什么文件系统——VFS 是应用程序和文件系统实现之间的抽象层(图 2a),cp 只管用谁都熟悉的通用系统调用(见第 1 章),实际执行流如图 2b。
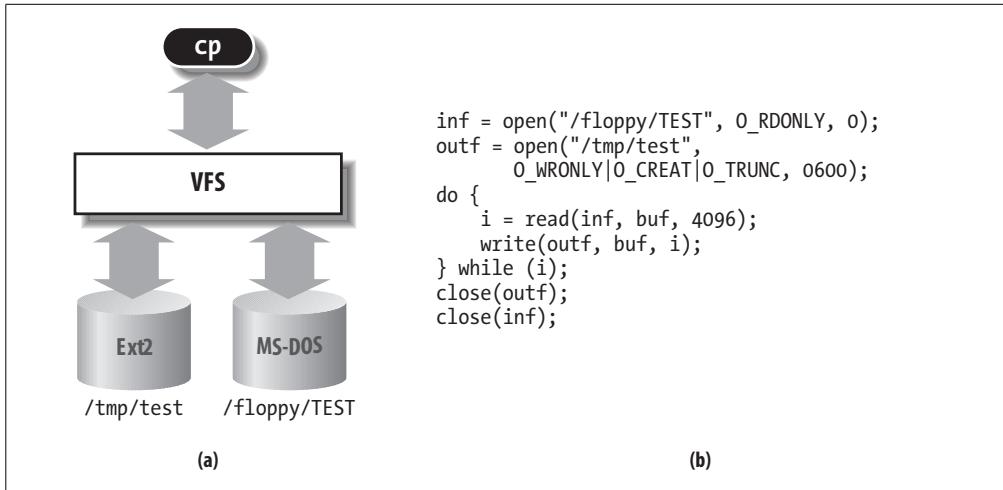 图 2:一次简单文件复制操作中 VFS 的角色(原书图 12-1)
VFS 支持的文件系统分三大类:
- 基于磁盘的文件系统:管理本地磁盘或模拟磁盘的设备(如 U 盘)上的内存空间。包括 Linux 阵营的 Ext2/Ext3/ReiserFS;Unix 变体的 sysv、UFS、MINIX、VxFS;微软的 MS-DOS、VFAT、NTFS;光盘的 ISO9660 和 DVD 的 UDF;其他专有系统如 OS/2 的 HPFS、Mac 的 HFS、Amiga 的 AFFS;以及源自别家的日志文件系统 IBM JFS、SGI XFS。
- 网络文件系统:便捷访问其他联网计算机上的文件,如 NFS、Coda、AFS、CIFS(Windows 用)、NCP(Novell)。
- 特殊文件系统:不管理磁盘空间(本地或远程),典型如 /proc。
Unix 的目录构成一棵以 / 为根的树;根目录在根文件系统里(Linux 通常是 Ext2/Ext3),其他文件系统都可以”挂载”到根文件系统的子目录上。基于磁盘的文件系统通常存在硬盘、软盘、光盘这类块设备上;VFS 还有妙用——支持 /dev/loop0 这类虚拟块设备,把存在普通文件里的文件系统挂上来(比如把加密的私有文件系统藏在一个普通文件里)。
史上第一个 VFS 出现在 1986 年 Sun 的 SunOS 里;此后多数 Unix 都有了 VFS,但 Linux 的 VFS 支持的文件系统种类最广。
VFS 接管的系统调用
表 12-1 列出 VFS 处理的与文件系统、常规文件、目录、符号链接相关的系统调用(另一批涉及设备文件和管道的,如 ioctl()、pipe(),在后面章节讲;socket 系列用于网络):
| 系统调用 | 说明 |
|---|---|
mount() umount() umount2() | 挂载/卸载文件系统 |
sysfs() | 获取文件系统信息 |
statfs() fstatfs() ustat() 等 | 获取文件系统统计信息 |
chroot() pivot_root() | 改变根目录 |
chdir() fchdir() getcwd() | 操作当前目录 |
mkdir() rmdir() | 创建/销毁目录 |
getdents() link() unlink() rename() 等 | 操作目录项 |
readlink() symlink() | 操作软链接 |
chown() fchown() lchown() 等 | 修改文件属主 |
chmod() fchmod() utime() | 修改文件属性 |
stat() fstat() lstat() access() 等 | 读取文件状态 |
open() close() creat() umask() | 打开、关闭、创建文件 |
dup() dup2() fcntl() | 操作文件描述符 |
select() poll() | 等待一组文件描述符上的事件 |
truncate() ftruncate() | 改变文件大小 |
lseek() _llseek() | 改变文件指针 |
read() write() readv() writev() sendfile() 等 | 文件 I/O |
io_setup() io_submit() io_getevents() io_cancel() io_destroy() | 异步 I/O |
pread64() pwrite64() | 定位并访问文件 |
mmap() mmap2() munmap() madvise() mincore() remap_file_pages() | 文件内存映射 |
fdatasync() fsync() sync() 等 | 同步文件/缓冲区 |
VFS 不总是”转发”:有些操作它自己就能完成。比如进程关闭打开的文件,磁盘通常不用动,VFS 直接释放对应的 file 对象即可;lseek() 修改的文件指针是”打开文件与进程交互”的属性,VFS 只改 file 对象、无需碰磁盘。某种意义上,VFS 是一个”通用文件系统”,必要时才依赖具体文件系统。
通用文件模型
VFS 的核心思想:引入一个能表示所有被支持文件系统的通用文件模型。该模型严格照搬传统 Unix 文件系统的模型——这不奇怪,Linux 希望自己的原生文件系统以最小开销运行;而每个具体文件系统的实现都必须把自己的物理组织”翻译”成这个通用模型。
一个典型翻译难题:通用模型里每个目录也是文件(内容是文件和子目录的列表),但 FAT 类文件系统用文件分配表存目录树位置,目录根本不是文件。Linux 的 FAT 实现为了贴合模型,必须在需要时现场构造出”目录文件”——这种文件只作为内核内存中的对象存在。
更本质的要求:内核不能硬编码处理 read()、ioctl() 等操作的函数,必须为每个操作准备一个指针,指向当前被访问文件系统专用的函数。以图 2 的 read() 为例:应用调 read() → 内核调 sys_read() 服务例程 → 打开的文件由内核内存中的 file 数据结构表示,其 f_op 字段装着 MS-DOS 文件专用函数(包括读文件函数)的指针 → sys_read() 找到指针并调用。于是应用的 read() 变成了相当间接的调用:
file->f_op->read(...);write() 同理触发 Ext2 的写函数。一句话:内核负责给每个打开文件的 file 变量装上正确的指针集合,再调用 f_op 指向的、属于该文件系统的专用函数。
可以把通用文件模型理解成面向对象的:对象=数据结构+操作它的方法。出于效率 Linux 没用 C++,对象用普通 C 结构体实现,字段里塞函数指针充当方法。模型由四类对象组成:
- 超级块对象(superblock):存放已挂载文件系统的信息。磁盘文件系统中它对应存放在磁盘上的文件系统控制块。
- inode 对象:存放具体文件的通用信息。磁盘文件系统中对应磁盘上的文件控制块。每个 inode 对象关联一个 inode 号,在文件系统内唯一标识该文件。
- file 对象:存放打开文件与进程之间交互的信息。这种信息只在进程打开文件期间存在于内核内存。
- dentry 对象:存放目录项(即文件的某个特定名字)与对应文件之间链接的信息。每个磁盘文件系统都以自己的方式把信息存在磁盘上。
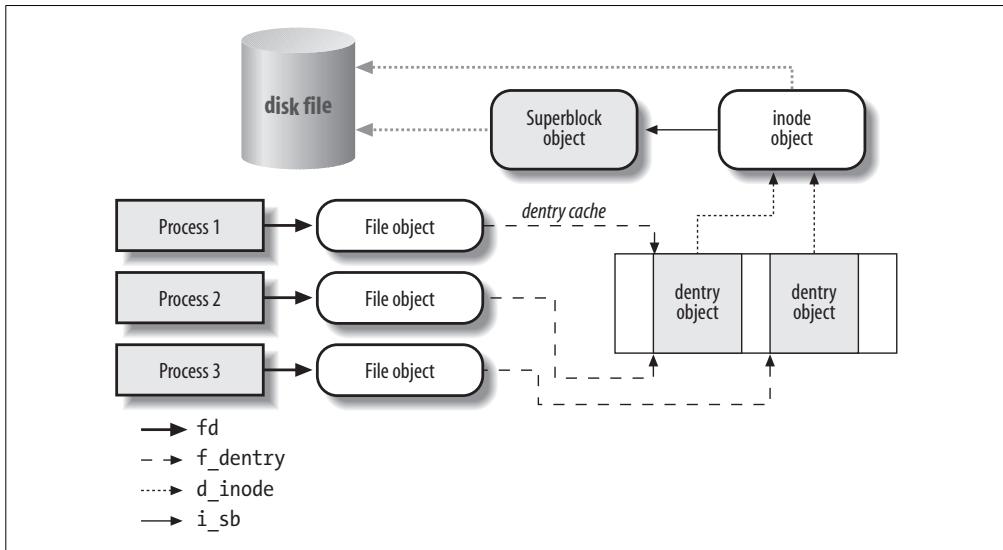 图 3:进程与 VFS 对象的交互(原书图 12-2)
图 3 展示了三进程打开同一个文件、其中两个用同一硬链接的情形:三个进程各用各的 file 对象;dentry 对象只需两个(每个硬链接一个);两个 dentry 都指向同一个 inode 对象——它标识超级块对象,两者合起来定位磁盘上的同一个文件。
VFS 还有第二个重要角色——性能。最近使用的 dentry 对象放在一个叫 dentry 缓存的磁盘缓存里,加速”文件路径名→最后一个路径成分的 inode”的翻译。
这里要分清三种”缓存”:磁盘缓存是软件机制,让内核把通常存在磁盘上的信息保留在 RAM 里,后续访问不必慢速读盘;硬件缓存是加速对较慢动态 RAM 请求的快速静态 RAM(见第 2 章),与磁盘无关;内存缓存是绕过内核内存分配器的软件机制(见第 8 章的 slab 分配器)。除 dentry 缓存和 inode 缓存外,Linux 还有其他磁盘缓存,最重要的是页缓存(见第 15 章)。
超级块对象
超级块对象由 super_block 结构组成,主要字段:
| 类型 | 字段 | 说明 |
|---|---|---|
struct list_head | s_list | 超级块链表指针 |
dev_t | s_dev | 设备标识符 |
unsigned long | s_blocksize | 块大小(字节) |
unsigned char | s_blocksize_bits | 块大小(位的数量) |
unsigned char | s_dirt | 已修改(脏)标志 |
unsigned long long | s_maxbytes | 文件最大尺寸 |
struct file_system_type * | s_type | 文件系统类型 |
struct super_operations * | s_op | 超级块方法 |
struct dquot_operations * | dq_op | 磁盘配额处理方法 |
unsigned long | s_flags | 挂载标志 |
unsigned long | s_magic | 文件系统魔数 |
struct dentry * | s_root | 文件系统根目录的 dentry 对象 |
struct rw_semaphore | s_umount | 卸载用的信号量 |
int | s_count / atomic_t s_active | 引用计数/次引用计数 |
void * | s_fs_info | 指向具体文件系统的超级块信息 |
所有超级块对象串成一个循环双向链表(首元素是 super_blocks 变量),sb_lock 自旋锁保护。
s_fs_info 指向属于具体文件系统的信息——比如 Ext2 文件系统的 superblock 里它指向 ext2_sb_info 结构,含磁盘分配位图等 VFS 通用模型不关心的数据。这些通常是从磁盘复制到内存的信息:磁盘文件系统分配/释放磁盘块时要读写分配位图,VFS 允许它们直接操作内存里的 s_fs_info 而不访问磁盘。
代价是内存超级块可能与磁盘上的失去同步,所以需要 s_dirt 脏标志标明”磁盘数据必须更新”。不同步就是熟悉的场景:突然断电、没来得及干净关机 → 文件系统损坏。Linux 通过定期把所有脏超级块拷回磁盘来缓解(见第 15 章)。
超级块操作
方法表由 s_op 指向。VFS 需要调某个方法时执行 sb->s_op->read_inode(inode); 这样两跳。主要方法:
alloc_inode(sb)/destroy_inode(inode):分配/销毁 inode 对象空间(含文件系统私有数据);read_inode(inode):用磁盘数据填充 inode 对象字段(i_ino 标识要读的磁盘 inode);dirty_inode(inode):inode 被标脏时调用,ReiserFS/Ext3 用它更新磁盘日志;write_inode(inode, flag):用内存 inode 内容更新磁盘 inode,flag 指明 I/O 是否同步;put_inode(inode):inode 引用计数递减(被释放)时的文件系统私有操作;drop_inode(inode):最后一个使用者释放 inode、即将销毁时调用——通常借助 generic_drop_inode():从 VFS 数据结构移除所有引用,若 inode 不再出现在任何目录里就调 delete_inode 从文件系统删除;delete_inode(inode):销毁内存中的 VFS inode 和磁盘上的文件数据与元数据;put_super(super)/write_super(super):释放超级块对象(文件系统被卸载时)/ 用对象内容更新磁盘超级块;sync_fs(sb, wait):刷文件系统时更新磁盘上的文件系统私有数据(日志文件系统用);write_super_lockfs/unlockfs:冻结文件系统(如 LVM 驱动)时阻塞修改并更新超级块 / 解除阻塞;statfs(super, buf):填充 buf 返回文件系统统计信息;remount_fs(super, flags, data):以新选项重新挂载;umount_begin(super):中止挂载操作(仅网络文件系统用);show_options、quota_read、quota_write等。
各文件系统只实现子集,未实现的方法字段置 NULL。注意:方法表里没有读超级块的 get_super 方法——对象还没从磁盘读出来,怎么可能先调它的方法?读超级块的 get_sb 方法在另一个对象里——描述文件系统类型的 file_system_type(见文件系统类型与挂载)。
inode 对象
文件系统处理文件所需的全部信息都在 inode 里。文件名是随意贴的标签、可以改;inode 对文件唯一,文件存在它就存在。内存中的 inode 对象即 inode 结构,主要字段:
| 类型 | 字段 | 说明 |
|---|---|---|
struct hlist_node | i_hash | 哈希链表指针 |
struct list_head | i_list | 描述 inode 当前状态的链表指针 |
struct list_head | i_sb_list | 超级块 inode 链表指针 |
struct list_head | i_dentry | 引用该 inode 的 dentry 对象链表头 |
unsigned long | i_ino | inode 号 |
atomic_t | i_count | 使用计数 |
umode_t | i_mode | 文件类型与访问权限 |
unsigned int | i_nlink | 硬链接数 |
uid_t / gid_t | i_uid / i_gid | 属主/组标识 |
dev_t | i_rdev | 实际设备标识符 |
loff_t | i_size | 文件长度(字节) |
struct timespec | i_atime / i_mtime / i_ctime | 最近访问/写入/inode 变更时间 |
unsigned long | i_blocks | 文件块数 |
struct semaphore | i_sem | inode 信号量 |
inode 对象会复制磁盘 inode 的部分数据(如分配给文件的块数)。i_state 字段为 I_DIRTY_SYNC、I_DIRTY_DATASYNC 或 I_DIRTY_PAGES 时,inode 是脏的(对应磁盘 inode 必须更新)——I_DIRTY 宏可一次查这三个标志。其他值:I_LOCK(正参与 I/O 传输)、I_FREEING(正在释放)、I_CLEAR(内容已无意义)、I_NEW(已分配但还没用磁盘数据填充)。
每个 inode 对象总处在以下循环双向链表之一(i_list 存相邻指针):
- 有效未用 inode 链表:镜像有效磁盘 inode、当前无进程使用——不脏、i_count 为 0,首尾由 inode_unused 变量引用。这个链表充当磁盘缓存;
- 在用 inode 链表:镜像有效磁盘 inode、正被某进程使用——不脏、i_count 为正,首尾由 inode_in_use 变量引用;
- 脏 inode 链表:首尾由对应超级块对象的 s_dirty 字段引用。
此外每个 inode 还挂进:以超级块 s_inodes 字段为头的每文件系统链表(i_sb_list 存指针);以及 inode_hashtable 哈希表——当内核同时知道 inode 号和超级块对象地址时用它加速查找。哈希可能冲突,i_hash 字段把哈希到同一位置的 inode 串成双向链表。
inode 操作
方法表由 i_op 指向(inode_operations),按表序主要有:
create(dir, dentry, mode, nameidata):为某目录下与 dentry 关联的常规文件创建新磁盘 inode;lookup(dir, dentry, nameidata):在目录中查找与 dentry 里文件名对应的 inode;link(old_dentry, dir, new_dentry)/unlink(dir, dentry):创建/删除硬链接;symlink(dir, dentry, symname):为符号链接创建新 inode;mkdir(dir, dentry, mode)/rmdir(dir, dentry):创建/删除目录;mknod(dir, dentry, mode, rdev):为特殊文件创建磁盘 inode(mode、rdev 指明文件类型和设备主次设备号);rename(old_dir, old_dentry, new_dir, new_dentry):把文件从 old_dir 移到 new_dir;readlink(dentry, buffer, buflen):把符号链接对应的路径名拷进用户态内存区;follow_link(inode, nameidata):翻译符号链接(相对路径从第二个参数指定的目录开始查找);put_link(dentry, nameidata):释放 follow_link 分配的临时数据结构;truncate(inode):修改文件大小(调用前需先把 i_size 设为新值);permission(inode, mask, nameidata):检查指定访问模式是否被允许;setattr/getattr:修改/读取 inode 属性;setxattr / getxattr / listxattr / removexattr:操作 inode 的扩展属性(存放在 inode 之外的磁盘块上)。
同样,具体 inode 只实现子集,未实现的置 NULL。
file 与 dentry 对象
file 对象:进程与打开文件的交互
file 对象描述进程如何与它打开的文件交互,打开文件时创建,是 file 结构:
| 类型 | 字段 | 说明 |
|---|---|---|
struct list_head | f_list | 通用 file 对象链表指针 |
struct dentry * | f_dentry | 与文件关联的 dentry 对象 |
struct vfsmount * | f_vfsmnt | 包含该文件的已挂载文件系统 |
struct file_operations * | f_op | 文件操作表指针 |
atomic_t | f_count | 引用计数 |
unsigned int | f_flags | 打开文件时指定的标志 |
mode_t | f_mode | 进程访问模式 |
loff_t | f_pos | 当前文件偏移(文件指针) |
struct fown_struct | f_owner | 通过信号进行 I/O 事件通知的数据 |
unsigned int | f_uid / f_gid | 用户的 UID/GID |
struct file_ra_state | f_ra | 文件预读状态(见第 16 章) |
size_t | f_maxcount | 单次操作可读写的最大字节数(当前 2^31-1) |
void * | private_data | 文件系统或设备驱动的私有数据 |
struct address_space * | f_mapping | 文件的 address_space 对象指针 |
file 对象最关键的信息是文件指针——下一次操作将发生的位置。因为多个进程可能并发访问同一文件,文件指针必须存在 file 对象里而不是 inode 对象里。file 对象没有对应的磁盘映像,所以 file 结构里没有脏标志。
file 对象从名为 filp 的 slab 高速缓存分配(描述符在 filp_cachep 变量)。可分配的 file 对象数量有限:files_stat 变量的 max_files 字段指定上限——即系统同时可访问文件的最大数目。“在用”的 file 对象按所属文件系统分组挂链:每个超级块的 s_files 字段是链表头,f_list 存相邻指针,files_lock 自旋锁保护。
f_count 是引用计数:统计正在使用该 file 对象的进程数(CLONE_FILES 创建的轻量级进程共享打开文件表,因此共用 file 对象);内核自己使用该对象时(比如把对象插进链表、发出 dup() 系统调用)也会加 1。
VFS 替进程打开文件时调 get_empty_filp() 分配新 file 对象并初始化:
memset(f, 0, sizeof(*f));
INIT_LIST_HEAD(&f->f_ep_links);
spin_lock_init(&f->f_ep_lock);
atomic_set(&f->f_count, 1);
f->f_uid = current->fsuid;
f->f_gid = current->fsgid;
f->f_owner.lock = RW_LOCK_UNLOCKED;
INIT_LIST_HEAD(&f->f_list);
f->f_maxcount = INT_MAX;
每个文件系统有自己的文件操作集合:内核把 inode 从磁盘装入内存时,把指向这些操作的 file_operations 结构地址存进 inode 的 i_fop 字段;进程打开文件时,VFS 用这个地址初始化新 file 对象的 f_op,此后文件操作调用都用这套函数。必要时 VFS 之后还可以改 f_op 换一套操作。file_operations 主要方法:
llseek(file, offset, origin):更新文件指针;read(file, buf, count, offset)/write(...):从 *offset 起读/写 count 字节,随后 *offset 增加;aio_read(req, buf, len, pos)/aio_write(...):异步 I/O 读写(支持 io_submit());readdir(dir, dirent, filldir):返回目录的下一个目录项;poll(file, poll_table):检查文件上是否有活动,没事就睡到有事为止;ioctl(inode, file, cmd, arg):向底层硬件设备发命令(仅设备文件);unlocked_ioctl/compat_ioctl:不拿大内核锁的 ioctl 新方法(驱动和文件系统最终都应实现它)/ 64 位内核实现 32 位 ioctl() 的方法;mmap(file, vma):把文件映射进进程地址空间(见第 16 章);open(inode, file):创建新 file 对象并链接到对应 inode;flush(file):关闭对打开文件的一个引用时调用,具体用途因文件系统而异;release(inode, file):释放 file 对象——最后一个引用关闭(f_count 归 0)时调用;fsync(file, dentry, flag):把所有缓存数据写盘刷文件;fasync(fd, file, on):启用/禁用经信号的 I/O 事件通知;readv / writev:分散读/集中写(vector 描述缓冲区数组);sendfile(...)/sendpage(...):在文件间传输数据/把数据传给页缓存的页;get_unmapped_area(...):找一个空闲地址区间来映射文件;check_flags/dir_notify/flock:fcntl() 相关检查(NFS 用)/ 目录变更通知(CIFS 用)/ 定制 flock() 行为(官方文件系统都不用)。
dentry 对象:名字与文件的结合
VFS 把每个目录当成装着文件和子目录列表的文件;目录项一旦读入内存就被 VFS 转换成基于 dentry 结构的 dentry 对象。内核为进程查找的每一个路径名成分都创建 dentry 对象,把成分与其对应 inode 关联起来——比如查找 /tmp/test 时,内核为 / 根目录建一个、为根目录的 tmp 项建一个、为 /tmp 目录的 test 项建一个,共三个 dentry 对象。
dentry 对象同样没有磁盘映像,所以没有脏标志;从 dentry_cache slab 缓存分配销毁。主要字段:
| 类型 | 字段 | 说明 |
|---|---|---|
atomic_t | d_count | 使用计数 |
unsigned int | d_flags | dentry 缓存标志 |
spinlock_t | d_lock | 保护 dentry 对象的自旋锁 |
struct inode * | d_inode | 与文件名关联的 inode |
struct dentry * | d_parent | 父目录的 dentry 对象 |
struct qstr | d_name | 文件名 |
struct list_head | d_lru | 未用 dentry 链表指针 |
struct list_head | d_child | 同一父目录中各目录项的链表指针 |
struct list_head | d_subdirs | 子目录项链表头 |
struct list_head | d_alias | 关联同一 inode 的各 dentry(别名)链表指针 |
struct dentry_operations* | d_op | dentry 方法 |
struct super_block * | d_sb | 文件的超级块对象 |
void * | d_fsdata | 文件系统相关数据 |
struct rcu_head | d_rcu | 回收对象时用的 RCU 描述符(见第 5 章) |
struct hlist_node | d_hash | 哈希表链表指针 |
int | d_mounted | 目录上挂载的文件系统计数 |
unsigned char[] | d_iname | 短文件名空间 |
dentry 对象有四种状态:
- 空闲(free):不含有效信息,未被 VFS 使用,内存归 slab 分配器管;
- 未用(unused):内核当前没用,d_count 为 0,但 d_inode 仍指向关联 inode——信息有效,必要时可丢弃回收内存;
- 在用(in use):d_count 为正,d_inode 指向关联 inode——信息有效且不可丢弃;
- 负(negative):关联的 inode 不存在——或磁盘 inode 已被删除、或该 dentry 是解析一个不存在文件的路径名时创建的。d_inode 为 NULL,但对象仍留在 dentry 缓存里,使后续对同一路径名的查找能快速失败。“负”这名字有点误导——并不涉及任何负数取值。
dentry 操作与 dentry 缓存
dentry 方法表由 d_op 指向(多数文件系统不定义,字段全 NULL,VFS 用默认函数顶替):d_revalidate(用前验证对象仍有效,默认什么都不做,网络文件系统会自定义)、d_hash(文件系统专属哈希函数)、d_compare(比较两个文件名,默认普通字符串匹配——MS-DOS 不区分大小写就靠自定义它)、d_delete(最后一个引用删除时调用)、d_release(对象即将归还 slab 时调用)、d_iput(对象变”负”丢掉 inode 时调用,默认调 iput() 释放 inode)。
为什么要有 dentry 缓存? 从磁盘读目录项再构造 dentry 对象相当耗时,而刚用完的 dentry 往往马上又要用——编辑完文件就编译、或编辑完打印、或复制一份再编辑,都反复访问同一文件。
dentry 缓存由两部分组成:
- 一组处于在用、未用或负状态的 dentry 对象;
- 一个哈希表,由”给定文件名+给定目录”快速定位关联的 dentry 对象;缓存里没有就返回 null。
dentry 缓存还兼任 inode 缓存的控制器:与未用 dentry 关联的内存 inode 不会被丢弃——dentry 缓存还引用着它们,于是 inode 留在 RAM 里,经对应 dentry 即可快速引用。
未用 dentry 全部挂进一条按插入时间排序的 LRU 双向链表:最后释放的排最前,最久未用的总在链表尾;缓存收缩时内核从尾部删除,保住最近使用的。首尾地址在 dentry_unused 变量里,相邻指针在 d_lru 字段。
每个在用 dentry 插进对应 inode 的 i_dentry 字段指定的双向链表(一个 inode 可关联多个硬链接,所以要链表),相邻指针在 d_alias 字段。在用 dentry 的最后一个硬链接被删时会变”负”,此时移进未用 LRU 链表;每次缓存收缩,负 dentry 都向尾部挪,逐渐被释放(见第 17 章)。
哈希表由 dentry_hashtable 数组实现,每项指向哈希到同一值的 dentry 链表;数组大小通常取决于系统 RAM,默认每 MB 内存 256 项。d_hash 字段存同一哈希值链表内的相邻指针。哈希函数同时用”目录的 dentry 对象+文件名”产生值。dcache_lock 自旋锁保护整个缓存;d_lookup() 查表时为避免竞态用 seqlock(见第 5 章),__d_lookup() 假定无竞态所以不用。
进程与文件
每个进程有自己的当前工作目录和根目录(见第 1 章),这只是进程与文件系统交互数据的一部分——完整信息装在 fs_struct 结构里,进程描述符的 fs 字段指向它:
| 类型 | 字段 | 说明 |
|---|---|---|
atomic_t | count | 共享该表的进程数 |
rwlock_t | lock | 保护表字段的读/写自旋锁 |
int | umask | 打开文件设置权限时用的位掩码 |
struct dentry * | root | 根目录的 dentry |
struct dentry * | pwd | 当前工作目录的 dentry |
struct dentry * | altroot | 模拟根目录的 dentry(80×86 恒为 NULL) |
struct vfsmount * | rootmnt / pwdmnt / altrootmnt | 根目录/当前目录/模拟根目录的已挂载文件系统对象 |
第二张表说明进程当前打开了哪些文件,地址在进程描述符的 files 字段,是 files_struct 结构:
| 类型 | 字段 | 说明 |
|---|---|---|
atomic_t | count | 共享该表的进程数 |
rwlock_t | file_lock | 保护表字段的读/写自旋锁 |
int | max_fds | 当前 file 对象最大数 |
int | max_fdset | 当前文件描述符最大数 |
int | next_fd | 曾分配的最大文件描述符 + 1 |
struct file ** | fd | 指向 file 对象指针数组 |
fd_set * | close_on_exec | exec() 时需关闭的文件描述符 |
fd_set * | open_fds | 打开文件的描述符集合 |
fd_set | close_on_exec_init / open_fds_init | 初始集合 |
struct file *[] | fd_array | 初始 file 对象指针数组 |
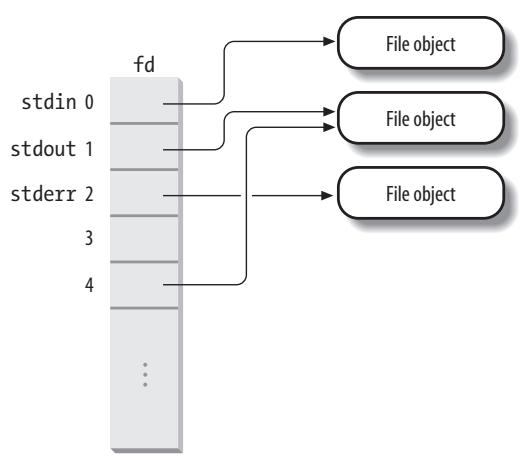 图 4:fd 数组(原书图 12-3)
fd 字段指向 file 对象指针数组,数组大小在 max_fds 里。通常 fd 指向结构内嵌的 fd_array 字段(32 个指针);进程打开超过 32 个文件时,内核分配更大的数组、把地址存进 fd 并更新 max_fds。数组下标就是文件描述符:如图 4 所示,下标 0 通常关联标准输入、1 是标准输出、2 是标准错误。Unix 进程把文件描述符当文件的主标识。得益于 dup()、dup2()、fcntl(),两个文件描述符可以指向同一个 file 对象——shell 里 2>&1 把标准错误重定向到标准输出时你每天都在用这特性。
进程可用的描述符不能超过 NR_OPEN(通常 1,048,576);内核还通过 signal->rlim[RLIMIT_NOFILE] 施加动态上限(通常 1024,root 进程可调高)。open_fds 初始指向 open_fds_init 位图(fd_set 含 1024 位,一般够用),max_fdset 记录位数;必要时内核可像扩 fd 数组一样动态扩位图。
内核提供两个配套函数管理 file 对象引用:fget(fd) 由描述符取 file 对象地址(取自 current->files->fd[fd],没有则 NULL),成功时把 f_count 加 1;fput(file) 用完后减 1——减到 0 时执行收尾:调 release 方法(若有定义)、文件按写打开则递减 inode 的 i_writecount、把对象从超级块链表摘除、归还 slab 分配器、递减关联 dentry 和文件系统描述符的使用计数。fget_light()/fput_light() 是快速版:当内核能确信当前进程已经持有该 file 对象(引用计数已加过,比如系统调用收到的描述符来自先前的 open())时使用。
文件系统类型与挂载
特殊文件系统
网络和磁盘文件系统让用户处理内核之外的信息;特殊文件系统则让系统程序和管理员能方便地操作内核数据结构、实现操作系统特殊功能。常见特殊文件系统:
| 名字 | 挂载点 | 说明 |
|---|---|---|
| bdev | 无 | 块设备(见第 13 章) |
| binfmt_misc | 任意 | 杂项可执行格式(见第 20 章) |
| devpts | /dev/pts | 伪终端支持(Unix98 标准) |
| eventpollfs | 无 | 高效事件轮询机制 |
| futexfs | 无 | futex 快速用户态锁机制 |
| pipefs | 无 | 管道(见第 19 章) |
| proc | /proc | 内核数据结构的通用访问点 |
| rootfs | 无 | 为引导阶段提供空根目录 |
| shm | 无 | IPC 共享内存区 |
| mqueue | 任意 | POSIX 消息队列 |
| sockfs | 无 | 套接字 |
| sysfs | /sys | 系统数据的通用访问点(见第 13 章) |
| tmpfs | 任意 | 临时文件(保存在 RAM,除非被交换) |
| usbfs | /proc/bus/usb | USB 设备 |
注意区分”任意”(无固定挂载点,用户自由挂载使用)和”无”(根本没有挂载点,不面向用户交互,只是内核借 VFS 层的代码复用——比如靠 pipefs,管道可以被当成 FIFO 文件一样处理,见第 19 章)。
特殊文件系统不绑定物理块设备,但内核给每个已挂载的特殊文件系统分配一个虚构块设备:主设备号为 0,次设备号各不相同。set_anon_super() 初始化其超级块(取一个未用的次设备号填 s_dev),kill_anon_super() 移除,unnamed_dev_idr 变量记录在用的次设备号。虽然有的内核设计者不喜欢虚构设备标识,但它让内核用统一的方式处理特殊文件系统和常规文件系统。
文件系统类型注册
文件系统的代码可以编进内核映像,也可以作为模块动态加载(见附录 B)。VFS 必须跟踪当前代码已进入内核的所有文件系统类型——这就是注册。每个注册的文件系统表示为一个 file_system_type 对象:
| 类型 | 字段 | 说明 |
|---|---|---|
const char * | name | 文件系统名 |
int | fs_flags | 文件系统类型标志 |
struct super_block * (*)( ) | get_sb | 读超级块的方法 |
void (*)( ) | kill_sb | 删除超级块的方法 |
struct module * | owner | 实现该文件系统的模块指针 |
struct file_system_type * | next | 文件系统类型链表的下一个元素 |
struct list_head | fs_supers | 同类型已挂载超级块对象链表的头 |
所有 file_system_type 对象串成单链表(file_systems 变量指向第一个),file_systems_lock 读/写自旋锁保护。fs_supers 是该类型所有已挂载文件系统超级块的链表头,链表元素间的链接存在超级块的 s_instances 字段。
get_sb 指向文件系统相关的函数:分配新超级块并初始化(必要时读磁盘);kill_sb 指向销毁超级块的函数。fs_flags 可为:FS_REQUIRES_DEV(该类型文件系统必须位于物理磁盘设备)、FS_BINARY_MOUNTDATA(使用二进制挂载数据)、FS_REVAL_DOT(始终重新验证 dentry 缓存中的”.”和”..”,网络文件系统用)、FS_ODD_RENAME(“重命名”即”移动”,网络文件系统用)。
系统初始化时对编译期指定的每个文件系统调 register_filesystem(),把对应对象插进类型链表;模块加载时同样调它,模块卸载时可调 unregister_filesystem() 注销。get_fs_type(name) 按名字扫链表找对应对象。
挂载
传统 Unix 只有一棵挂载树:根文件系统由内核在引导阶段直接挂载,承载系统初始化脚本和最核心的系统程序;其他文件系统由初始化脚本或用户挂到已挂载文件系统的目录上。挂载目标目录叫挂载点(mount point);被挂的文件系统是挂载点所在文件系统的”孩子”,其根目录会遮住父文件系统挂载点目录的内容及以下的整棵子树。
命名空间(namespace):传统 Unix 全系统只有一棵挂载树;Linux 2.6 更精细——每个进程可以有自己的已挂载文件系统树。多数进程共享同一命名空间(init 进程使用的那棵、根在系统根文件系统的树);clone() 带 CLONE_NEWNS 标志创建的进程得到新命名空间(见第 3 章),之后其后代不加该标志就继承它。进程挂载/卸载文件系统只改自己的命名空间——改动对共享同一命名空间的所有进程可见,且仅对它们可见。进程甚至能用 Linux 特有的 pivot_root() 换掉自己命名空间的根文件系统。命名空间由 namespace 结构表示(进程描述符 namespace 字段指向):count(共享进程数)、root(命名空间根的挂载文件系统描述符)、list(所有已挂载文件系统描述符链表头)、sem(保护结构)。
同一文件系统可以挂多次!多数传统内核每个文件系统只能挂载一次(再次 mount 同一设备会失败);Linux 里同一文件系统挂 n 次,根目录就能通过 n 个挂载点访问,但文件系统本身唯一——无论挂多少次都只有一个超级块对象。已挂载文件系统还能形成层次:A 的挂载点可以是 B 的目录,而 B 又挂在 C 上。同一挂载点上还能堆叠多个挂载:新挂载遮住旧的,但已在使用旧挂载下文件的进程可继续使用;最上层的挂载被移除后,下一层重新可见。
每个挂载操作的信息(挂载点、挂载标志、与其他文件系统的关系)存在 vfsmount 类型的已挂载文件系统描述符里:mnt_parent(父文件系统)、mnt_mountpoint(挂载点目录的 dentry)、mnt_root(本文件系统根目录的 dentry)、mnt_sb(超级块对象)、mnt_mounts/mnt_child(孩子链表)、mnt_count(使用计数,加 1 禁止卸载)、mnt_flags(标志)、mnt_devname(设备文件名)、mnt_namespace(挂载者的命名空间)等。vfsmount 结构挂在三类链表上:mount_hashtable 哈希表(按父描述符地址+挂载点 dentry 地址索引)、每命名空间的全部描述符链表、每文件系统的孩子链表。mnt_flags 可含 MNT_NOSUID(禁止 setuid/setgid)、MNT_NODEV(禁止访问设备文件)、MNT_NOEXEC(禁止执行程序)。辅助函数:alloc_vfsmnt/free_vfsmnt/lookup_mnt。
mount() 系统调用的执行
sys_mount() 参数:含文件系统的设备文件路径名(网络文件系统可为 NULL)、挂载点目录路径名、文件系统类型名(必须已注册)、挂载标志、指向文件系统相关数据结构的指针。它把参数拷进临时内核缓冲、拿大内核锁、调 do_mount(),返回后放锁、释放缓冲。
do_mount() 先把 MS_NOSUID/MS_NODEV/MS_NOEXEC 换算成对应 MNT_ 标志,调 path_lookup() 查挂载点路径(结果存 nameidata 局部变量 nd),再按标志分派:
- MS_REMOUNT:调 do_remount() 改超级块 s_flags 和描述符 mnt_flags;
- MS_BIND:让一个文件或目录在目录树另一处可见(bind mount);
- MS_MOVE:调 do_move_mount() 原子地移动已挂载文件系统的挂载点;
- 其余(最常见)走 do_new_mount():调 do_kern_mount() 干真正的挂载活、返回新描述符地址,再调 do_add_mount()——后者以写方式拿 current 命名空间的 sem 信号量(要改命名空间了);因为 do_kern_mount() 可能让进程睡眠,醒来后必须复查”该挂载点上最后挂载的文件系统是否还属于 current 的命名空间”(别的进程可能抢了同一挂载点、甚至换了根文件系统),不对就放信号量返回错误;目标已挂在该挂载点上或挂载点是符号链接也报错;然后初始化 mnt_flags、调 graft_tree() 把新描述符插进命名空间链表、哈希表和父文件系统的孩子链表、放信号量。
do_kern_mount()
挂载操作的核心。步骤:
get_fs_type()在类型链表中按 fstype 找到 file_system_type 描述符;alloc_vfsmnt()分配新描述符存进局部变量 mnt;- 调
type->get_sb()分配并初始化新超级块; mnt->mnt_sb指向新超级块;mnt->mnt_root指向文件系统根目录的 dentry(并递增其使用计数);mnt_parent 暂指向 mnt 自己(通用文件系统的正确值等 graft_tree() 插链表时再设);mnt_namespace 指向 current 的命名空间;- 释放超级块的 s_umount 读/写信号量,返回 mnt。
get_sb 方法通常是一行函数。Ext2 的实现:
struct super_block * ext2_get_sb(struct file_system_type *type, int flags, const char *dev_name, void *data)
{
    return get_sb_bdev(type, flags, dev_name, data, ext2_fill_super);
}
磁盘文件系统用 get_sb_bdev()(最后一个参数 ext2_fill_super() 负责从磁盘分区读出超级块信息);特殊文件系统另有三个:get_sb_pseudo()(无挂载点,如 pipefs)、get_sb_single()(单一挂载点,如 sysfs)、get_sb_nodev()(可挂多次,如 tmpfs)。
get_sb_bdev() 的主要操作:①open_bdev_excl() 打开设备文件 dev_name;②sget() 在该文件系统类型的超级块链表(type->fs_supers)里找同一块设备的超级块——已存在就直接返回(这就是”同一文件系统挂多次只有一个超级块”的实现),否则分配新超级块、插进类型链表和全局超级块链表;③不是新超级块(文件系统已挂载)直接跳第 6 步;④把 flags 存进 s_flags,按块设备填 s_id、s_old_blocksize、s_blocksize;⑤调文件系统相关函数读磁盘超级块、填其余字段;⑥返回超级块地址。
挂载根文件系统
根文件系统可能在很多地方:硬盘分区、软盘、NFS 远程、甚至 ramdisk(RAM 里的虚构块设备)。挂载分两阶段:
- 内核先挂特殊文件系统 rootfs——只提供一个空目录当初始挂载点;
- 再把真正的根文件系统挂到这个空目录上。
为什么要先挂 rootfs?因为它让内核能方便地更换真正的根文件系统——有些场合内核会接连挂载卸载好几个根文件系统:发行版引导 CD 在 RAM 里装载带最小驱动集的内核、挂 ramdisk 里的最小文件系统当根;其中的程序探测硬件(EIDE 还是 SCSI?)、装载所需内核模块,然后从物理块设备重新挂载根文件系统。
阶段一由 init_rootfs() 和 init_mount_tree() 完成。init_rootfs() 注册 rootfs 类型:
struct file_system_type rootfs_fs_type = {
    .name = "rootfs";
    .get_sb = rootfs_get_sb;
    .kill_sb = kill_litter_super;
};
register_filesystem(&rootfs_fs_type);
init_mount_tree() 调 do_kern_mount() 传 “rootfs”,后者最终调 rootfs_get_sb()——经 get_sb_nodev() 分配超级块(set_anon_super 设虚构设备号;rootfs 没有磁盘超级块,只实现两个超级块操作,ramfs_fill_super() 分配一个 inode 和对应 dentry、填超级块字段);然后为进程 0 分配命名空间对象、把新描述符插进去:
namespace = kmalloc(sizeof(*namespace), GFP_KERNEL);
list_add(&mnt->mnt_list, &namespace->list);
namespace->root = mnt;
mnt->mnt_namespace = init_task.namespace = namespace;
再把系统中所有其他进程的 namespace 字段都指向该命名空间对象(默认全系统共享初始命名空间),并把进程 0 的根目录和当前目录设为根文件系统。
阶段二在系统初始化接近尾声时由 prepare_namespace() 执行:从 “root” 引导参数取设备文件名、设 ROOT_DEV;调 mount_root()——先 sys_mknod() 在 rootfs 里创建 /dev/root 设备文件(主次设备号取自 ROOT_DEV);再扫描文件系统类型名列表(“rootfstype” 引导参数给定,或扫类型链表得来),逐个调 sys_mount() 尝试挂载——因为各文件系统的魔数不同,只有真正匹配根设备的那种 get_sb() 会成功,文件系统被挂到 rootfs 的 /root 目录上;然后 sys_chdir(“/root”) 切过去;最后把挂载点挪到 rootfs 根目录、chroot 进去:
sys_mount(".", "/", NULL, MS_MOVE, NULL);
sys_chroot(".");
注意 rootfs 并没有被卸载——只是被磁盘根文件系统藏到了下面。
卸载
umount() 系统调用(服务例程 sys_umount(),参数为文件名——挂载点目录或块设备文件——加一组标志):
- path_lookup() 查挂载点路径,结果存 nd;
- 结果目录不是某文件系统的挂载点 → -EINVAL(验证方法:nd->mnt->mnt_root 是否包含 nd.dentry 指向的 dentry 地址);
- 该文件系统不在 current 命名空间中 → -EINVAL(check_mnt() 检查;有些特殊文件系统没有挂载点);
- 用户无卸载权限 → -EPERM;
- 调 do_umount(mnt, flags):取超级块 sb;用户要求强制卸载则调 umount_begin 超级块方法中断正在进行的挂载操作;要卸的是根文件系统且用户没要求真正分离 → 调 do_remount_sb() 把根文件系统重新挂成只读然后结束;否则以写方式拿 current 的 namespace->sem、取 vfsmount_lock 自旋锁——若被卸文件系统下没有孩子挂载点、或用户要求强制分离,调 umount_tree() 卸掉它(连同所有孩子文件系统);放锁和信号量;
- 递减根目录 dentry 和挂载描述符的使用计数(path_lookup 加的);
- 返回 retval。
路径名查找
进程要操作文件时,把文件路径名传给某个 VFS 系统调用(open()、mkdir()、rename()、stat()……)。VFS 要做路径名查找(pathname lookup):从路径名推出对应的 inode。
标准流程:把路径名拆成文件名序列(最后一个除外都必须是目录)。首字符是 / 则为绝对路径,从 current->fs->root 标识的进程根目录开始查;否则是相对路径,从 current->fs->pwd 的当前目录开始。拿到初始目录的 dentry(从而得到 inode)后,逐一读目录文件、匹配名字、推出下一个 inode,重复到最后一个名字。dentry 缓存大大加速此过程——最近用过的”目录内文件名→inode”关联都在内存里,多数情况无需从磁盘读中间目录。
但实际查找必须考虑一堆 Unix/VFS 特性:
- 每个目录的访问权限都要检查,确认进程有权读目录内容;
- 文件名可能是符号链接,对应任意路径名——分析必须扩展到该路径名的所有成分;
- 符号链接可能造成循环引用——内核必须识别并无休止循环出现时打断它;
- 文件名可能是挂载点——必须检测出来并跳进新文件系统继续查;
- 查找必须在发起系统调用的进程的命名空间内进行——同一路径名在两个不同命名空间的进程眼里可能是不同文件。
查找由 path_lookup(name, flags, nd) 执行:name 是路径名;flags 是访问方式标志(见表 12-16);nd 是 nameidata 结构地址,存放查找结果:
| 类型 | 字段 | 说明 |
|---|---|---|
struct dentry * | dentry | dentry 对象地址 |
struct vfsmount * | mnt | 已挂载文件系统对象地址 |
struct qstr | last | 路径名的最后一个成分(LOOKUP_PARENT 时用) |
unsigned int | flags | 查找标志 |
int | last_type | 最后一个成分的类型 |
unsigned int | depth | 符号链接嵌套的当前层数(必须小于 6) |
char[] * | saved_names | 嵌套符号链接关联的路径名数组 |
union | intent | 规定文件将被如何访问 |
dentry 和 mnt 描述路径名标识的文件。由于它们是查找结果,path_lookup() 会递增两者的使用计数;调用方用完调 path_release() 释放。
| 宏 | 说明 |
|---|---|
LOOKUP_FOLLOW | 最后成分是符号链接时解释(跟随)它 |
LOOKUP_DIRECTORY | 最后成分必须是目录 |
LOOKUP_CONTINUE | 路径名中还有文件名待检查 |
LOOKUP_PARENT | 查找包含最后一个成分的目录 |
LOOKUP_NOALT | 不考虑模拟根目录(80×86 无用) |
LOOKUP_OPEN | 意图是打开文件 |
LOOKUP_CREATE | 意图是创建文件(若不存在) |
LOOKUP_ACCESS | 意图是检查用户对文件的权限 |
path_lookup() 先初始化 nd(last_type 设为 LAST_ROOT——路径名就是一个或一串斜杠时的默认值;flags 拷贝;depth 置 0),以读方式拿 current->fs->lock,按首字符决定从根目录还是当前目录出发(取对应的 vfsmount 和 dentry 地址、加计数、存进 nd->mnt 和 nd->dentry),放锁,把 current 的 total_link_count 清 0,最后调 link_path_walk(name, nd) 干核心查找的活。
标准路径名查找(LOOKUP_PARENT 未设)
link_path_walk() 的主干是一个把路径名拆解成成分的循环(斜杠当分隔符),每处理一个成分:
-
取上一成分的 inode(nd->dentry->d_inode,首轮即起始目录);
-
检查执行权限——Unix 里目录可执行才能被穿越;有自定义 permission 方法就调它,否则用 exec_permission_lite() 看 i_mode 和进程特权,不允许则返回错误码;
-
对成分名算 32 位哈希值备查 dentry 缓存;
-
成分是”.”(当前目录,无效果)→ 跳过;成分是”..”(爬到父目录)→ 分四种情况:
- 上一目录已是进程根目录 → 不许爬,对上一成分调 follow_mount() 后继续下一个成分;
- 上一目录是 nd->mnt 文件系统的根目录、且该文件系统没叠在别的文件系统上 → 通常已是命名空间根,不可能再爬,同样处理;
- 上一目录是 nd->mnt 的根目录、但该文件系统叠在另一文件系统上 → 需要跨文件系统:把 nd->dentry 设为 nd->mnt->mnt_mountpoint、nd->mnt 设为 nd->mnt->mnt_parent,重做”..”处理(同一挂载点可能叠了多个文件系统);
- 普通目录 → nd->dentry 设为 d_parent 爬到父目录,follow_mount() 一下,继续。
follow_mount() 的作用:检查 dentry 是否是挂载点(d_mounted > 0),是则 lookup_mnt() 找到挂上来的文件系统的根目录 dentry、更新 nd——反复做直到最顶层(同一挂载点可叠多个文件系统)。爬父目录时调它,是因为进程可能从一个被”父目录上叠的文件系统遮住”的文件系统里开始查找;
-
普通名字 → 在 dentry 缓存里查(低层文件系统有自定义 d_hash 就先重算哈希);置 LOOKUP_CONTINUE;调 do_lookup():先 __d_lookup() 查缓存,没有则 real_lookup() 执行 inode 的 lookup 方法从磁盘读目录、创建新 dentry 对象插入缓存、创建新 inode 对象插入 inode 缓存;
-
调 follow_mount() 处理”该成分是挂载点”(更新到最顶层挂载的文件系统);
-
检查符号链接(inode 有自定义 follow_link 方法则需解释,见下);
-
检查该成分是目录(inode 有自定义 lookup 方法),中间成分不是目录则返回 -ENOTDIR;
-
把结果写进 nd,继续下一个成分。
所有成分解析完后处理最后一个:尾随斜杠则强制最后成分当目录名;最后成分是”.”直接成功返回(结果指向前一个成分);是”..”则按上述四种情况爬父目录返回;普通名字则走缓存查找+do_lookup+follow_mount,然后若设置了 LOOKUP_FOLLOW 且是符号链接则解释之;最后把结果填进 nd。若最后 dentry 没有关联 inode(d_inode 为 NULL,通常因为文件不存在)返回 -ENOENT;设了 LOOKUP_DIRECTORY 却不是目录返回 -ENOTDIR;全部成功返回 0。
父路径名查找(LOOKUP_PARENT 置位)
很多查找的真正目标不是最后一个成分,而是倒数第二个:创建文件时最后成分是尚不存在的新文件名,其余路径指定新链接要插入的目录;unlink /foo/bar 实际是要访问 foo 目录来删掉 bar。LOOKUP_PARENT 置位时,查找解析的是”包含最后一个成分的目录”。
此时 link_path_walk() 走到处理最后成分时完全不解释它:把名字存进 nd->last,把 nd->last_type 设为下表之一后返回——于是 nd->dentry/mnt 指向包含最后成分的目录:
| 值 | 说明 |
|---|---|
| LAST_NORM | 普通文件名 |
| LAST_ROOT | ”/“(整个路径名就是”/“) |
| LAST_DOT | ”.” |
| LAST_DOTDOT | ”..” |
| LAST_BIND | 指向特殊文件系统的符号链接 |
符号链接查找
符号链接是存着另一个文件路径名的常规文件,路径名中遇到必须解析。比如 /foo/bar 是指向 ../dir 的符号链接,那么 /foo/bar/file 必须解析成 /dir/file——内核要做两次查找:先解析 /foo/bar 发现 bar 是符号链接、取出内容当路径名;第二次查找从第一段到达的目录开始直到符号链接路径名的最后成分;然后原查找从第二次到达的 dentry 继续。符号链接里还可以嵌符号链接——好在解析代码是递归的,其实很简单。
但野生的递归很危险:符号链接可以指向自己,无休止的递归很快撑爆内核栈。防线有两条:
- 进程描述符的 link_count 字段:每次递归前加 1、结束后减 1,第 6 层嵌套直接报错——符号链接嵌套最多 5 层;
- 进程描述符的 total_link_count 字段:统计原查找中跟随过的符号链接总数(哪怕不嵌套),达到 40 就中止——否则恶意用户能造一条由大量连续符号链接组成的病态路径名,把内核拖进超长查找。
流程:link_path_walk() 拿到某成分的 dentry 后,发现其 inode 有自定义 follow_link 方法 → 调 do_follow_link(dentry, nd):
- 检查 current->link_count < 5,否则返回 -ELOOP;
- 检查 current->total_link_count < 40,否则返回 -ELOOP;
- cond_resched() 按需切换进程;
- link_count、total_link_count、nd->depth 各加 1;
- 更新符号链接 inode 的访问时间;
- 调文件系统相关的 follow_link 方法:取出符号链接 inode 里存的路径名,存进 nd->saved_names 数组的对应表项;
- 调 __vfs_follow_link(nd, 路径名):若符号链接路径以 / 开头(绝对路径),先 path_release() 释放此前查找的结果、把 nd 指到 current 的根目录;然后递归调 link_path_walk() 解析这段路径;返回其值;
- 若定义了 put_link 方法就执行,释放临时结构;
- link_count 和 nd->depth 各减 1,返回。
do_follow_link 结束后,next.dentry 已指向符号链接引用的 dentry,link_path_walk() 从这里继续原查找。
系统调用实现与文件锁
回到本章开头的例子:cp /floppy/TEST /tmp/test 的核心代码是:
inf = open("/floppy/TEST", O_RDONLY, 0);
outf = open("/tmp/test", O_WRONLY | O_CREAT | O_TRUNC, 0600);
do {
    len = read(inf, buf, 4096);
    write(outf, buf, len);
} while (len);
close(outf);
close(inf);
(真实 cp 还要检查每个系统调用的错误码,这里只看”正常”行为。)
open()
服务例程 sys_open(filename, flags, mode):filename 是路径名,flags 是访问模式标志,文件需创建时 mode 是权限位掩码。成功返回文件描述符(即 current->files->fd 数组的下标),失败返回 -1。例中第一次以 O_RDONLY 打开 /floppy/TEST,第二次以 O_WRONLY|O_CREAT|O_TRUNC 打开 /tmp/test——不存在就创建(属主独享读写,八进制 0600),已存在则从零重写。open() 的全部标志:
| 标志 | 说明 |
|---|---|
| O_RDONLY / O_WRONLY / O_RDWR | 为读/写/读写打开 |
| O_CREAT | 文件不存在则创建 |
| O_EXCL | 与 O_CREAT 同用,文件已存在则失败 |
| O_NOCTTY | 绝不把文件当控制终端 |
| O_TRUNC | 截断文件(清除现有内容) |
| O_APPEND | 总是在文件尾写 |
| O_NONBLOCK / O_NDELAY | 该文件上无系统调用会阻塞 |
| O_SYNC | 同步写(阻塞到物理写完成) |
| FASYNC | 经信号的 I/O 事件通知 |
| O_DIRECT | 直接 I/O 传输(不经内核缓冲) |
| O_LARGEFILE | 大文件(大于 2GB) |
| O_DIRECTORY | 文件不是目录则失败 |
| O_NOFOLLOW | 路径名尾部的符号链接不跟随 |
| O_NOATIME | 不更新 inode 的最近访问时间 |
sys_open() 步骤:
getname()从进程地址空间读出文件路径名;get_unused_fd()在 current->files->fd 里找个空槽,下标存进局部变量 fd;filp_open(路径名, 标志, 权限掩码):- 把访问标志编码进 namei_flags(第 0 位=需读权限、第 1 位=需写权限;open() 里不可能”既不读也不写”,但符号链接查找时会用到这种组合);
open_namei()执行查找:未设 O_CREAT 时带 LOOKUP_OPEN(LOOKUP_FOLLOW 视 O_NOFOLLOW,LOOKUP_DIRECTORY 视 O_DIRECTORY);设了 O_CREAT 时加 LOOKUP_PARENT 和 LOOKUP_CREATE——path_lookup() 成功返回后检查文件是否已存在,不存在就调父 inode 的 create 方法分配新磁盘 inode。open_namei() 还做安全检查:inode 真实存在、是常规文件、进程有权按标志访问;按写打开还要确认文件没被别的进程锁住;dentry_open(dentry, vfsmnt, 标志):分配新 file 对象;按标志初始化 f_flags/f_mode;按查找结果初始化 f_dentry/f_vfsmnt;把 inode 的 i_fop 装进 f_op(这一步决定了此后所有文件操作用哪套函数);把 file 对象插进超级块 s_files 指向的已打开文件链表;有 open 方法就调;file_ra_state_init() 初始化预读结构(见第 16 章);O_DIRECT 时检查能否直接 I/O;返回 file 对象地址;
- 把 file 对象地址存进
current->files->fd[fd]; - 返回 fd。
read() 与 write()
两者高度对称,都是三个参数:fd、缓冲区地址 buf、字节数 count;都返回成功传输的字节数或 -1。
返回值小于 count 不代表出错——内核本来就被允许在没传完时就结束系统调用,应用必须检查返回值、必要时重发。返回小值常见于:从管道或终端设备读、读到文件尾之后、系统调用被信号打断。read() 返回 0 即 EOF;这不会与”被信号打断”混淆——read() 在读到数据之前被信号打断时返回的是错误。
读写总发生在 file 对象 f_pos 字段指定的文件偏移处,并随传输字节数更新文件指针。sys_read()/sys_write() 的步骤几乎相同:
fget_light()由 fd 得到 file 对象地址;- f_mode 不允许所请求的访问 → -EBADF;
- 文件对象没有 read()/aio_read()(或 write()/aio_write())操作 → -EINVAL;
access_ok()对 buf、count 做粗检查(见第 10 章);rw_verify_area()检查待访问文件区域有无冲突的强制锁——有则返回错误码;锁是 F_SETLKW 命令请求的则让 current 睡眠;- 调
file->f_op->read或file->f_op->write方法传输数据(未定义则调 aio_read/aio_write);这些方法(见第 16 章)返回实际传输字节数,副作用是正确更新文件指针; fput_light()释放 file 对象;- 返回实际传输的字节数。
close()
循环在 read() 返回 0(/floppy/TEST 全部拷完)时结束,程序关闭文件。sys_close(fd):
- 取 current->files->fd[fd] 里的 file 对象地址,NULL 则返回错误码;
- 把 fd[fd] 置 NULL,清 open_fds 和 close_on_exec 里的相应位,释放描述符;
- 调 filp_close():有 flush 方法就调;释放文件上的全部强制锁(见下);调 fput() 释放 file 对象;
- 返回 0 或错误码(flush 方法可能报错,文件此前的写操作也可能报错)。
文件锁
多个进程访问同一文件就出现同步问题:两个进程同时写同一位置会怎样?一个读另一个正在写的位置呢?传统 Unix 的答案是”结果不可预测”,但同时提供了锁机制让进程锁住文件区域避免并发访问。
POSIX 要求基于 fcntl() 的锁:可锁文件任意区域(哪怕 1 字节)或整个文件(含未来追加的数据);因为可以只锁一部分,进程能同时持有同一文件不同部分的多把锁。这种锁挡不住对锁一无所知的进程——像保护临界区的信号量,只有大家都在访问前检查锁才有用,所以叫劝告锁(advisory lock)。BSD 变体用 flock()(只能锁整个文件);System V 的 lockf() 库函数只是 fcntl() 的接口。更重要的是 System V Release 3 引入了强制锁(mandatory lock):内核检查每一次 open()、read()、write() 是否违反强制锁——即使进程不配合也强制生效。
无论劝告还是强制,锁都分共享读锁和独占写锁:一个区域可以同时有多把读锁,但同一时刻只允许一个进程持写锁;别人持读锁时拿不到写锁,反之亦然。
Linux 全支持:劝告+强制锁、fcntl()+flock()(lockf() 是库函数)。不过 Linux 的 flock() 有个特例——“共享模式强制锁”(share-mode mandatory lock),用于某些专有网络文件系统:置位后任何与锁的访问模式冲突的 open() 都被拒绝;原生 Unix 应用不鼓励用它(源码不可移植)。Linux 还引入了基于 fcntl() 的另一种强制锁——租约锁(lease):进程试图打开受租约保护的文件时照常阻塞,但持锁进程会收到信号;它应当先更新文件使内容一致、再放锁;若在规定时间内(/proc/sys/fs/lease-break_time,通常 45 秒)不这么做,内核自动撤销租约、放行被阻塞的进程。
获取/释放劝告锁两条路:flock(fd, cmd)——锁作用于整个文件,cmd 取 LOCK_SH(共享读锁)/LOCK_EX(独占写锁)/LOCK_UN(释放);配 LOCK_NB 则不阻塞、拿不到就返回错误码。fcntl(fd, cmd, fl)——fl 指向 flock 结构(字段见下),可指定锁的文件区域,因此能持有多个部分锁。flock 结构字段:l_type(F_RDLCK 共享锁/F_WRLCK 独占锁/F_UNLOCK 释放)、l_whence+l_start(锁区起点:相对文件头/当前指针/文件尾)、l_len(锁区长度,0 表示包括文件尾之后的一切未来写入)、l_pid(属主 PID)。
fcntl() 和 flock() 可以同时用在同一文件上,但互不可见——fcntl 锁的文件在 flock 眼里没锁,反之亦然。这是故意的:防止”用 A 类锁的应用依赖一个用 B 类锁的库”造成死锁。
使用强制锁的步骤:①mount 时用 -o mand 选项(设 MS_MANDLOCK 标志,默认禁用);②给文件置 set-group 位(SGID)并清 group-execute 权限位——SGID 在组执行位关闭时本来无意义,内核把这个组合解读为”用强制锁而非劝告锁”的提示;③用 fcntl() 加/解锁。租约锁简单得多:fcntl() 用 F_SETLEASE/F_GETLEASE 命令即可,F_SETSIG 可改通知信号类型。
除 read()/write() 里的检查外,内核在所有可能修改文件内容的系统调用里都考虑强制锁——比如带 O_TRUNC 的 open() 在文件有任何强制锁时失败。
锁的数据结构:所有锁统一用 file_lock 结构:fl_next(同 inode 锁链表的下一个)、fl_link(活动/阻塞链表指针)、fl_block(等待者链表指针)、fl_owner/fl_pid(属主的 files_struct 和 PID)、fl_wait(被阻塞进程的等待队列)、fl_file(file 对象)、fl_flags/fl_type(锁标志/类型)、fl_start/fl_end(锁区起止偏移)、fl_fasync(租约破裂通知用)、fl_break_time(租约剩余时间)、fl_ops/fl_mops(锁操作/锁管理操作)、fl_u(文件系统私有信息)。
同盘文件的所有 file_lock 挂在一条单链表上(inode 的 i_flock 字段指向首元素,fl_next 串联)。进程请求独占锁但同文件已有共享锁时,请求无法立即满足、进程被挂进被阻塞锁的 fl_wait 等待队列。为区分”已满足”(活动锁)和”无法立即满足”(阻塞锁)的请求,用两条全局链表:活动锁全在 file_lock_list 指向的”全局文件锁链表”,阻塞锁全在 blocked_list 指向的”阻塞链表”,fl_link 用于入链。最后,内核还要记录每把活动锁(blocker)关联的所有阻塞锁(waiter):blocker 的 fl_block 是这个等待者链表的哑头,waiter 们的 fl_block 存相邻指针。
FL_FLOCK 锁:总与 file 对象关联,属于打开文件的进程(或共享同一打开文件的 clone 进程)。进程改变已持有的锁(读锁换写锁或反之)时,内核用新锁替换它在同一 file 对象上的所有旧锁;file 对象被 fput() 释放时其 FL_FLOCK 锁全部销毁——但其他进程对同一文件(inode)设的 FL_FLOCK 读锁不受影响。sys_flock() 流程:验证 fd、检查读写权限;分配并初始化新 file_lock(fl_type 按 cmd、fl_file 按 filp、fl_flags 为 FL_FLOCK、fl_pid 为 current->tgid、fl_end 置 -1 表示锁整个文件);cmd 含 LOCK_NB 则不加 FL_SLEEP;文件有 flock 文件操作就调它(多数没有),否则调 flock_lock_file_wait()。后者的循环:先 flock_lock_file()——在 inode 锁链表里找同 file 对象的 FL_FLOCK 锁:类型相同则无事可做;进程要解锁(LOCK_UN)则结束;是”换锁”则先 cond_resched() 给高优先级进程(尤其此前阻塞在旧锁上的进程)机会;再次扫链表验证无冲突(请求写锁时链表里必须完全没有 FL_FLOCK 锁,否则至少不能有写锁);无冲突则插入 inode 链表和全局链表返回 0;有冲突且 FL_SLEEP 置位则把新锁(waiter)挂进 blocker 的等待链和全局阻塞链表,返回 -EAGAIN。flock_lock_file_wait() 拿到 -EAGAIN:FL_SLEEP 未置位 → 释放锁描述符返回 -EAGAIN;置位 → wait_event_interruptible() 把 current 插进锁的 fl_wait 队列睡眠,醒来(blocker 已释放)后从头重试。
FL_POSIX 锁:与进程和 inode关联。进程死亡或关闭文件描述符时自动释放——即使进程打开同一文件两次或复制过描述符;FL_POSIX 锁不跨 fork() 继承。fcntl() 锁命令:F_GETLK(查询 flock 描述的锁是否与别的进程的 FL_POSIX 锁冲突,冲突则用现有锁的信息覆盖 flock 结构)、F_SETLK(设锁,拿不到返回错误码)、F_SETLKW(设锁,拿不到就睡眠等待)、以及用 flock64 结构的 F_GETLK64/F_SETLK64/F_SETLKW64。
fcntl_setlk() 流程:读入用户 flock 结构;若应为强制锁而文件已有共享内存映射(见第 16 章)→ 拒绝并返回 -EAGAIN(文件正被别的进程访问);按 flock 结构和 inode 里的文件大小初始化新 file_lock;F_SETLKW 则置 FL_SLEEP;F_RDLCK 查读权限、F_WRLCK 查写权限;文件操作有 lock 方法就调(磁盘文件系统通常没定义);调 __posix_lock_file(inode, file_lock):
- 对 inode 锁链表中每个 FL_POSIX 锁调 posix_locks_conflict() 检查冲突:同区域不能有别人的写锁;请求写锁时同区域不能有任何锁;同一进程自己的锁永不冲突——这让进程能修改自己已持有的锁的特性;
- 发现冲突:F_SETLKW 则先 posix_locks_deadlock() 检查等待锁的进程之间没有形成死锁,再把新锁挂进冲突锁的 blocker 链和全局阻塞链表,返回错误码;F_SETLK 直接返回错误码;
- 链表里无冲突锁后,检查当前进程所有与本区域重叠的锁,按需合并与拆分相邻区域——比如进程在较宽的读锁区域内请求写锁时,旧读锁被拆成两段盖住不重叠的部分,中间段由新写锁保护;重叠时新锁总是替换旧锁;
- 新 file_lock 插进全局文件锁链表和 inode 链表,返回 0。
拿到错误码后与 flock 同样的三岔口:无冲突成功返回;有冲突且 FL_SLEEP 未置位释放后返回 -EAGAIN;可睡眠则 wait_event_interruptible() 入队睡眠、醒来重试。
常见坑:把 inode 和文件名绑死
文件名只是贴在 inode 上的”临时标签”:改名(rename)、另建硬链接(link)都不影响 inode;删除名字(unlink)也只是减 i_nlink,inode 要等所有硬链接都删掉才真正从磁盘消失。反过来,两个”同名”路径(不同目录下)可能是完全不同的文件——唯一标识文件的是”文件系统+inode 号”,不是名字。
常见坑:混淆三种"缓存"
dentry 缓存是磁盘缓存(把磁盘上的目录项信息留在 RAM);硬件缓存(第 2 章)是加速 DRAM 访问的 SRAM,与磁盘无关;内存缓存(slab 分配器,第 8 章)是绕过内核内存分配器的软件机制。三者名字像、层次完全不同,讨论性能问题时别张冠李戴。
通关标准
能不看书画出 VFS 四对象的关系图(多个 file 对象 → 少量 dentry → 一个 inode → 一个 superblock),说清 read() 如何经 f_op 分发到具体文件系统的函数、路径名查找如何处理”.” ”..”、挂载点、符号链接和嵌套上限,以及 fcntl 劝告锁与 flock 锁的区别——达标。
为什么 VFS 必须为每种操作用函数指针而不是硬编码函数?
因为 VFS 要同时支持文件模型千差万别的文件系统:FAT 类文件系统里目录甚至不是文件,NTFS、NFS、Ext2 的读写实现毫无共同之处。用 f_op、s_op、i_op 这类函数指针表,内核在打开文件时按所属文件系统装上对应的函数集合,之后调用 file->f_op->read(…) 自动落到正确的实现——这正是”通用接口+插件式实现”的做法。
dentry 对象的"负"状态是什么?它为什么还要留在缓存里?
负 dentry 指其 d_inode 为 NULL——对应的磁盘 inode 已被删除,或这个 dentry 本来就是解析”不存在的文件的路径名”时创建的。留在缓存里是为了让后续对同一路径名的查找能快速失败(直接确认文件不存在),不必每次都去读磁盘目录。名字里的”负”只是表示”没有 inode”,与取负值无关。
路径名查找时遇到"..",什么情况下不允许爬到父目录?
三种情形:①已经处在进程的根目录(chroot 的效果就是把它变成本进程的天花板);②已处在 nd->mnt 文件系统的根目录、且该文件系统没有叠在别的文件系统上(这就是命名空间的根了);③处在挂载点的目录里但该目录被上层文件系统遮住时,要先顺着挂载链跳到最顶层再继续。核心原则:进程根目录和文件系统根目录都是”向上穿越”的边界。
符号链接的解析为什么要有两层计数保护?各自的限制值是多少?
因为符号链接可以指向自己或互相循环,裸递归会撑爆内核栈、病态长链会冻结内核。link_count 限制嵌套层数(递归解析中同时展开的深度),上限 5 层,超过返回 -ELOOP;total_link_count 限制总数(一次查找中跟随过的符号链接累计数,哪怕不嵌套),上限 40,超过中止查找。
fcntl() 的锁和 flock() 的锁有什么本质区别?为什么两者互不可见?
flock(FL_FLOCK)锁关联 file 对象,作用于整个文件,file 对象释放时锁消失;fcntl(FL_POSIX)锁关联进程和 inode,可锁定任意区域,进程死亡或关闭任一描述符时自动释放,且不跨 fork 继承。两者互不可见是刻意设计:如果应用用 A 类锁而它依赖的库用 B 类锁并假设锁已生效,就会死锁;让两套锁各管各的,反而逼使用者明确选择其中一套。