这一篇在干嘛?
会”学习”的滤波器:LMS/NLMS/符号 LMS、变换域 LMS、RLS 与卡尔曼算法,以及 PCA/ICA 等现代信号处理技术。 原书代码为 VHDL,本篇所有代码已改写为 Verilog。
- 第8章
- 自适应系统
- 8.1 自适应系统的应用
- 8.2 最优估计技术
-
- 信号的性质
-
- 成本函数的定义
- 最优维纳估计
- 例 8.1 二抽头 FIR 滤波器干扰的消除
- 8.3 Widrow-Hoff 最小二乘法算法
- 算法 8.2 Widrow-Hoff LMS 算法
- 例8.3 步长的边界
- 例8.4 标准化LMS
- 8.4 变换域 LMS 算法
- 8.5 LMS算法的实现
- 例 8.5 2 抽头自适应 LMS FIR 滤波器
-
- 采用 FFT 的模块变换
-
- 延迟的 LMS 算法
-
- 先行 DLMS 算法
- 例 8.6 2 抽头流水线自适应 LMS FIR 滤波器
- 例8.7 Signum LMS滤波器中的误差底线
- 8.6 递归最小二乘法算法
- 算法8.8 RLS算法
- 例8.9 RLS学习曲线
- 算法8.10 快速卡尔曼RLS算法
- 8.7 LMS 和 RLS 的参数比较
- 8.8 主成分分析(PCA)
- 例8.11 ECG数据降维
- (1) 直接方法
- (3) 神经网络学习方法
- 例8.12
- 例 8.14 基于 Sanger GHA 的 PCA 设计
- 8.9 独立成分分析(ICA)
- 例8.15 采用EASI算法的ICA设计
- 8.10 语音和音频信号编码
- 例8.16 A律设计
- 例8.17 ADPCM设计
- 8.11 练习
- (e) 对于三阶系统重复(a)~(d)。
- 8.7 假定期望信号如下:
- 8.8 假定期望信号如下:
自测一下
LMS 算法的更新公式里 μ 起什么作用?
μ 是步长:太大会发散(超过输入功率倒数的 2 倍),太小收敛慢。NLMS 用输入功率归一化 μ,对输入幅度不敏感,实际设计首选。
符号-LMS(SLMS)省在哪?
把误差或数据的乘法换成”取符号后加减”,乘法器变成加减器。代价是收敛略慢、稳态误差稍大,适合资源紧张且精度要求不高的场景。
RLS 与 LMS 的本质差别?
RLS 用逆相关矩阵递推,每步都精确最小化最小二乘代价,收敛快一个数量级且对特征值扩散不敏感;代价是 O(N^2) 运算量与数值稳定性问题。
变换域 LMS 为什么能加速收敛?
对输入做正交变换(如 DFT)把各频带去相关,等效把大的特征值扩散度压平,再用归一化步长——各模式可独立用大步长,收敛显著加快。
自适应系统:让滤波器自己”学会”工作
到目前为止,我们遇到的滤波器都有一个共同点:系数一旦设计好就固定不变。这在很多场合是够用的,但现实中的信号往往没那么”听话”——语音处理、通信、雷达、声呐、地震勘探、生物医学等领域的信号,其统计特性会随时间缓慢变化。如果还用固定系数的滤波器,性能就会逐渐变差。解决办法就是自适应数字滤波器(Adaptive Digital Filter, ADF):它能根据输入信号实时调整自己的系数,让滤波器始终”逼近”当前条件下的最优解。前提是参数变化相对采样频率足够慢,这样我们才有时间不断计算”更好的”系数估计值并加以调整。
从结构上看,任何前面学过的滤波器结构(FIR 或 IIR)原则上都可以当自适应滤波器用,但选择时要注意:
- FIR 滤波器:图3-1 的直接形式最有利,因为所有系数可以同时、并行地更新,而自适应算法恰恰需要每一拍都更新全部系数。
- IIR 滤波器:图4-12 的网格(lattice)结构是较好的选择,因为它的定点舍入误差灵敏度低,而且系数稳定性控制简单。
不过实践表明,FIR 滤波器在实际应用中远比 IIR 成功(IIR 的极点会带来稳定性隐患),所以本章主要讨论自适应 FIR 滤波器的高效实现。理论上,FIR 自适应算法应收敛于由维纳-霍夫方程给出的最优非递归估计器;我们还会顺带提到最优递归估计器(卡尔曼滤波器),并从计算复杂度、算法稳定性、初始收敛速度、收敛一致性以及对附加噪声的鲁棒性等角度比较不同方案。本章最后还会介绍更高级的话题:用主成分分析(PCA)和独立成分分析(ICA)做多通道信号的盲源分离(BSS),以及从 ADPCM 到 MP3 的语音处理。
自适应系统如今已是成熟的 DSP 分支,早在 20 世纪 80 年代中期就有专著出版[268273],更新的结果见教科书[274276];期刊(如 IEEE Transactions on Signal Processing)则持续关注 LMS 稳定性及其各种变体等基础问题。
8.1 自适应系统的应用
自适应滤波器的应用五花八门,但仔细一看,几乎全都能归入下面 4 种配置之一:
- 干扰消除:把噪声”减掉”
- 预测:用过去猜现在
- 反演模拟:求一个未知系统的”逆”
- 辨识:求一个未知系统的”拷贝”
为了讲清这些配置,统一使用如下记号:
- = 自适应系统的输入
- = 自适应系统的输出
- = (自适应系统的)期望响应
- = 估计误差
8.1.1 干扰消除
这是应用最广的一类。输入信号里既混着有用信息,也掺杂干扰——比如随机白噪声,或者 50/60 Hz 的电力线交流噪声。图 8-1 给出了配置:传感器收到的信号 (信号+干扰)与自适应滤波器对基准信号 的响应 相减,得到误差信号 ,它同时就是整个系统的输出。关键在于:收敛之后, 会变成干扰的”加性逆”(大小相等、符号相反),于是干扰就从输入中被抵消了,而有用信号基本不动。
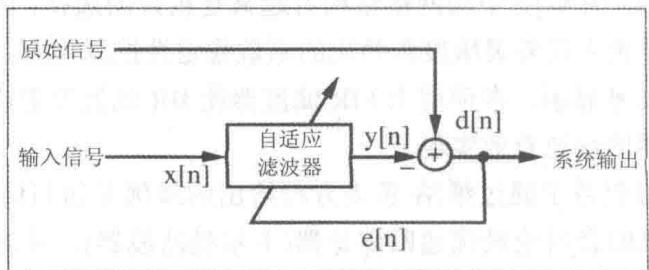
图 8-1 用于干扰消除的基本配置
后面我们会用一个电力线交流噪声的完整例子详细研究这一配置。另一个常见应用是电话系统中的自适应回声消除;干扰消除还被用于天线阵列(即所谓波束形成器),可以自适应地抑制来自未知方向的噪声干扰。
8.1.2 预测
预测的任务是给出随机信号当前值的最佳估计(通常在最小均方误差意义下)。显然,只有当输入信号与白噪声”长得不一样”(即有相关性可利用)时,预测才可能成功。图 8-2 说明其原理:期望信号 经一个延迟后作为自适应滤波器的输入,同一信号 本身还充当期望响应来计算误差 。换句话说,滤波器在用”过去”预测”现在”。
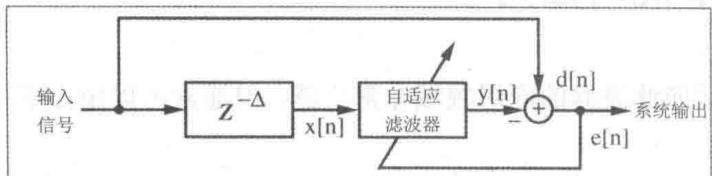
图 8-2 用于预测的框图
预测编码已成功用于图像和语音处理:不直接对信号编码,只编码预测误差,因为误差通常小得多、更省存储和带宽。其他应用包括功率谱建模、数据压缩、谱增强与事件检测[269]。
8.1.3 反演模拟
反演模拟的任务是构造未知时变被控对象(plant)的逆模型。典型例子是通信均衡:信道(多径传播)把信号”搅乱”了,自适应滤波器学习去近似这个信道的反演,把信号”复原”。图 8-3 的配置是:输入 先进入未知被控对象,其输出 作为自适应滤波器的输入;延迟后的原输入 用作期望响应来计算误差 并调整系数。收敛后,自适应滤波器的传递函数就近似等于未知被控对象传递函数的倒数。
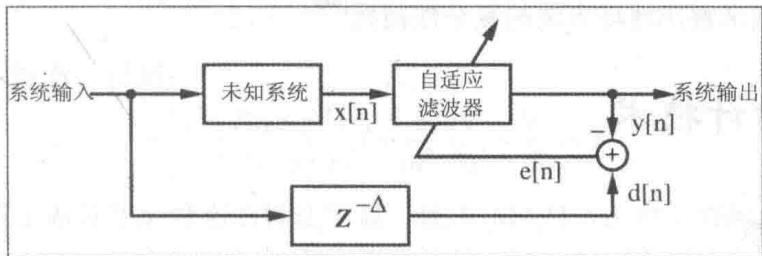
图 8-3 阐述反演系统建模的示意图
除了通信均衡,反演模拟还用于提高被窄带噪声污染系统的信噪比(S/N)、自适应控制系统,以及语音分析中的去卷积和数字滤波器设计[269]。
8.1.4 系统辨识
系统辨识与反演模拟正好相反:目标是让自适应滤波器直接复制未知系统。结构如图 8-4:同一时间序列 同时送入自适应滤波器和未知被控对象,未知对象的输出 作为期望响应。收敛后 以最小均方意义逼近 。如果自适应滤波器的阶数与未知对象匹配,且输入 是广义稳态(WSS)的,则自适应滤波器的系数将收敛到与未知对象相同的值。实际中未知对象的输出往往带观测噪声、结构也不完全匹配,性能会偏离理想,但这不妨碍它成为评估自适应算法性能的”标准实验台”——后面对比 LMS 与 RLS 时就用这个配置。
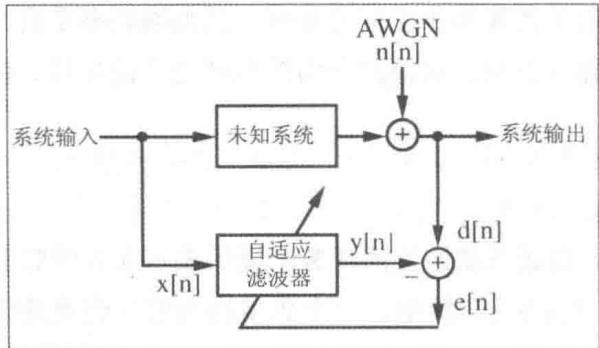
图 8-4 系统辨识的基本配置
系统辨识还用于生物学建模、社会与商业系统仿真、自适应控制、滤波器设计和地球物理学[269];在地震勘探中用于建立分层地球模型,解释地表信号的复杂性[268]。
8.2 最优估计技术
信号的性质:算法能工作的前提
任何自适应算法都有收敛条件,而条件是建立在对输入信号统计特性的假设上的。从概率角度看,输入信号可视为随机变量向量。两个基本假设:
(1)各态历经性(ergodicity):用一段信号算出的统计量,应等于”所有可能信号”的统计平均。也就是说,时间平均可以代替集合平均,例如均值
和方差
(2)广义稳态(WSS):均值、方差不随时间变化,且自相关函数
只依赖于时间差 。特别地:
即 就是 WSS 过程的平均功率,后面确定步长边界时会反复用到它。
一些高级算法还需要更高阶的统计量,最常用的是四阶统计”峰态”(kurtosis)。这里采用 MATLAB 的定义(不做 -3 标准化):
这个定义有个好性质:对信号做直流偏移或比例缩放都不改变峰态值,即
展开计算一个例子:求 上均匀分布信号的峰态。其概率密度函数(PDF)在区间内恒为 ,均值为 。先算四阶矩和二阶矩:
于是峰态:
注意 在计算中约掉了——这正是式(8-3)所说的”比例缩放不影响峰态”。
峰态是区分信号”形状”的利器。以 MATLAB 标准,高斯分布的峰态是 3。峰态高于 3、分布带尖峰脉冲特性的信号叫超高斯信号:例如长度为 、只含 个非零脉冲的信号,其 ,脉冲越稀疏峰态越大。峰态低于 3 的叫次高斯信号,如正弦、余弦、三角波和二进制 ±1 “掷硬币”信号。表 8-1 汇总了典型分布的三个统计量。
表 8-1 典型分布的均值、方差和峰态
| 分布 | 均值 | 方差 | 峰态 |
| 掷硬币分布±1 | 0.0 | 1.0 | 1.0 |
| 正弦/余弦,周期>8 | 0.0 | 0.5 | 1.5 |
| 三角分布[0,10] | 5.0 | 35.0 | 1.8 |
| 均匀分布[-0.5,0.5] | 0.0 | 1/12 | 1.8 |
| 0、1、-1、0、1、-1、... | 0.0 | 0.5 | 2.0 |
| 高斯/标准分布 | 0.0 | 1.0 | 3.0 |
| 瑞利噪声 | 1.25 | 0.43 | 3.3 |
| 拉普拉斯噪声 | 0.0 | 2.0 | 5.8 |
| 长笛 | 0.0 | 1.0 | 3.59 |
| 钢琴 | 0.0 | 1.0 | 3.94 |
| 男声 | 0.0 | 1.0 | 16.4 |
| 女声 | 0.0 | 1.0 | 46.1 |
| I脉冲/长度L | 0.0 | 1.0 | L/I |
可以看到真实信号(男声 16.4、女声 46.1)峰态极大——它们是很”尖”的超高斯信号,这一性质在后面盲源分离章节会直接利用。
成本函数的定义:给误差”打分”
所有自适应算法的核心问题都是:误差 该怎么”加权”成一个人人比得高低的目标?定义
其中 是待估计的随机变量, 是自适应滤波器给出的估计值。最常用的成本函数是最小均方(Least-Mean-Square, LMS)型:
但这不是唯一选择。图 8-5 给出了三种误差成本函数:除了二次函数外,还有绝对值误差和非线性阈值型。如果某个误差水平以内都”可以接受”,用阈值型函数可以显著降低算法计算量——有趣的是,Widrow 最初提出的自适应算法用的恰恰就是阈值函数处理误差。
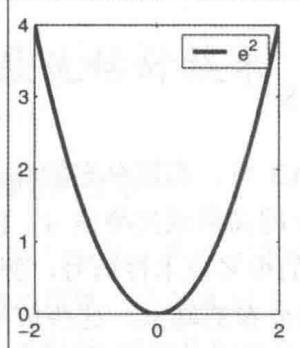
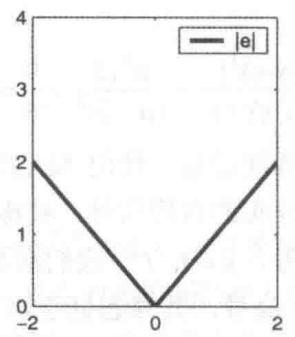
图 8-5 3 种可能的误差成本函数
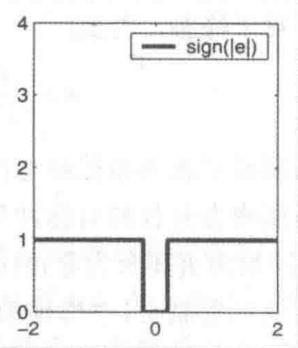
不过,二次误差函数有一个决定性优势:它是系数的光滑二次函数,可以借助连续信号领域早已成熟的维纳-霍夫关系构造随机梯度算法。下一小节回顾维纳估计,它直接引出 Widrow 等人提出、至今应用最广的 LMS 算法[277, 278]。
最优维纳估计:理论上的”满分答案”
自适应 FIR 滤波器的输出是一个卷积和:
我们的目标是调整系数 使成本函数 最小。用向量记号写卷积更方便:
其中 , 都是 向量, 表示转置(复数情形为厄米共轭转置)。对矩阵 ,转置沿主对角线”镜像”:。
把式(8-8)代入误差定义:
于是均方误差展开为:
注意 是系数的二次函数——把它画出来是一个永远非负的”凹超抛物面”,两个系数的情形如图 8-6 所示。自适应的过程,就是沿着这个碗状曲面”往下走”,走到碗底。为此对 微分并令梯度为零:
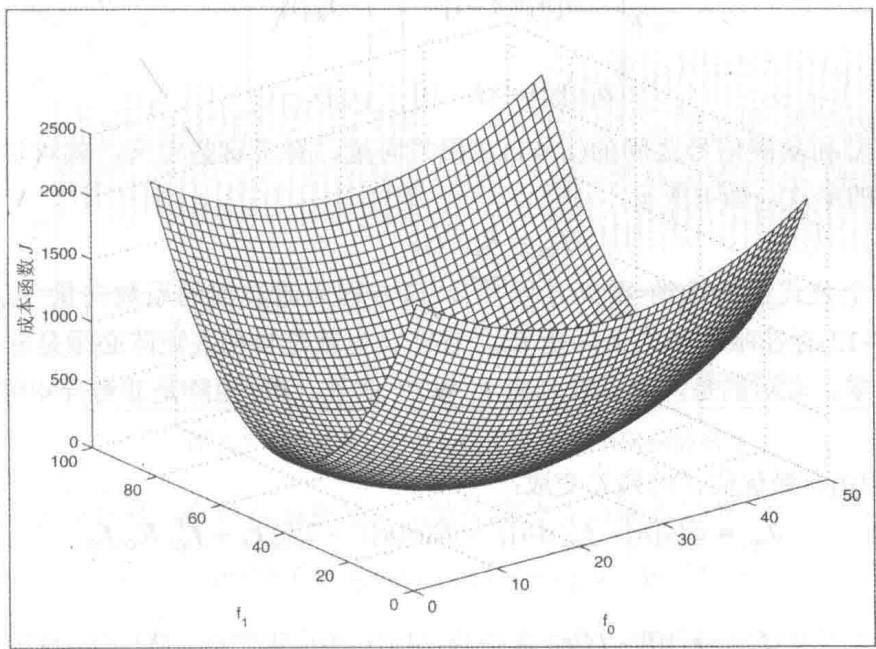
图 8-6 两个分量情况下的误差成本函数,成本函数的最小值在 和 处
假定滤波器权重向量 与信号向量 统计独立(不相关),就得到:
即最优系数向量:
为书写简洁,定义两个统计量。一是输入的 自相关矩阵:
它沿对角线对称,具有托普利兹(每条对角线上元素相等)结构。二是期望信号与基准信号之间的 互相关向量:
于是维纳解可以写成极简形式:
这就是著名的维纳-霍夫方程[267]。式(8-12)有唯一解的条件是 存在,即自相关矩阵非奇异(行列式非零);幸运的是,对 WSS 信号可以证明 必非奇异[268]。最优估计处的”碗底”残差为:
其中 是 的方差。