这一篇在干嘛?
在 FPGA 里造 CPU:指令集设计、Nios 软核、自定义指令,以及 T-RISC/LISA/PDSP 三个微处理器案例。 原书代码为 VHDL,本篇所有代码已改写为 Verilog。
- 第9章 微处理器设计
- 9.1 微处理器设计概述
- 9.2 微处理器的发展史
- 9.3 指令集设计
-
- 隐式寻址
-
- 直接寻址
-
- 寄存器寻址
-
- 存储器寻址
-
- PDSP 专用寻址模式
-
- 栈机:零地址 CPU
-
- 累加器机:单地址 CPU
-
- 二地址 CPU
-
- 三地址 CPU
-
- 零地址、单地址、二地址和三地址 CPU 的比较
- 例9.3 RISC寄存器文件
-
- ALU 指令
-
- 数据移动指令
-
- 程序流指令
- 9.4 软件工具
- 9.5 FPGA 微处理器内核
-
- Xilinx PowerPC
-
- Altera 的 ARM
- 例9.4 Thumb指令编码
-
- Xilinx 与 Altera 器件上的 ARM Cortex-A9
-
- 8位处理器:Xilinx PicoBlaze
-
- 16 位处理器:Altera Nios
-
- 32位处理器:Xilinx MicroBlaze
- 例 9.7 MicroBlaze 缓存配置
- 9.6 案例研究
- 例9.8 栈机
-
- LISA 18 位指令字 RISC 处理器
-
- LISA 可编程数字信号处理器
-
- LISA 真向量处理器
-
- LISA 处理器设计的比较
-
- 自定义逻辑模块的创建和集成
-
- 软件实现
-
- Altera 自定义逻辑模块的实例化
-
- 新的 CI 设计
-
- Nios 位反向性能结果
- 9.7 练习
- 9.2 按练习 9.1 所给分类方式对以下各项进行分类:
自测一下
软核与硬核处理器各适合什么?
硬核(ARM 硬核)性能高、时序确定,适合重计算应用;软核(Nios II/MicroBlaze)可按需裁剪、数量随意,适合控制逻辑粘合。
设计一个简单 RISC 要哪几步?
定义指令集(寻址模式/操作码)→ 设计数据通路(取指/译码/执行三级)→ 写寄存器堆与 ALU → 控制状态机 → 工具链(汇编器)。T-RISC 案例完整走了一遍。
什么是"自定义指令"?
在软核 CPU 的 ALU 旁挂一个自己设计的硬件单元,用宏指令调用——把软件里最耗时的内循环(如 FFT 蝶形)变成一条硬件指令,加速 10~100 倍。
PDSP 与 FPGA 各自的强项?
PDSP(如 54xx)内部有专用 MAC 与强寻址硬件,滤波类算法效率高;FPGA 胜在并行度可自定义,多通道/特殊结构(如多相滤波器组)能做出远超 PDSP 的吞吐。
第9章 微处理器设计
9.1 微处理器设计概述
提到”微处理器”(μP),很多人第一反应是拥有数亿晶体管的 Intel Itanium 这类高端 CPU。那么用 FPGA 能设计出这样的微处理器吗?坦率地说:单片 FPGA 做不出这种级别的高端处理器,但在低功耗、面向特定应用的微处理器方面,FPGA 大有可为。这里的关键在于一个取舍——微处理器用”硬布线方案的性能”换取了”门效率”:同样的算法,用软件跑(或让一个通用状态机去执行指令)速度往往较慢,但占用的硬件资源更少。所以用 FPGA 搭出来的微处理器,气质上更接近”微控制器”,而不是功能完整的 Pentium 或 VLIW 结构的 PDSP。
那为什么还要在 FPGA 里做微处理器呢?本章后续会讨论一个 DWT(离散小波变换)实现控制器的典型应用。有人会问:这种控制用 FSM(有限状态机)不就够了吗?没错——从根本上说,FPGA 微处理器就可以理解为”一个由程序存储器内容定义的 FSM”:FSM 的行为不再是硬布线写死的,而是由存储器中的指令决定,如图 9-1 所示。这样一来,改算法只需改程序,不必重改硬件。早期的 Xilinx PicoBlaze 处理器就叫 KCPSM(Ken Chapman 可编程状态机),名字里就带着这层”状态机血统”。
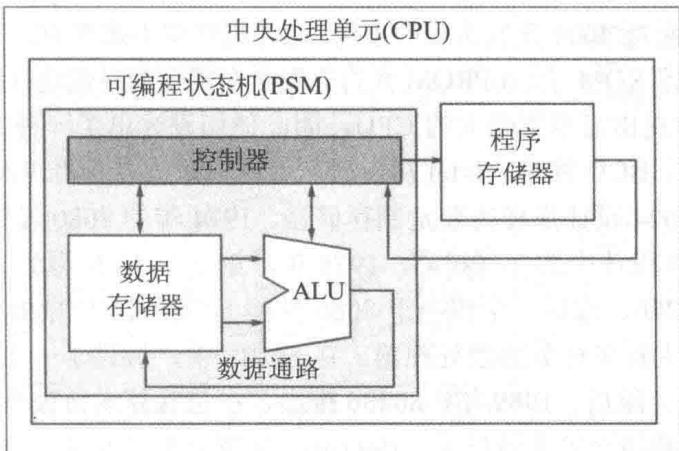
图 9-1 Xilinx KCPSM,也称作 PicoBlaze
完整的微处理器设计通常包含多个步骤:体系结构探索、指令集设计、开发工具等,本章将逐一展开。建议读者配合一些计算机体系结构教材(参考文献 [336-342])一起学习。在正式动手之前,先回顾一下微处理器是怎么一路发展过来的。
9.2 微处理器的发展史
微处理器通常分为三大类:多功能(CISC)处理器、精简指令集处理器(RISC)和可编程数字信号处理器(PDSP)。了解这三类的历史,有助于理解它们各自的指令集为什么长成那个样子。
9.2.1 多功能微处理器简史
1968 年,一个典型的多功能小型计算机是 16 位体系结构,单片电路板上要用大约 200 个 MSI 芯片(每个约 100 个晶体管)。当时的工程师提出了一个问题 [343]:能不能只用 150、80 甚至 25 个芯片造出一个完整的 CPU?
与此同时,Robert Noyce 和 Gordon Moore 离开 Fairchild 创办了一家以存储芯片为主的公司,先叫 NM 电子,后来更名为 Intel。1969 年,日本计算器厂商 Busicom 请 Intel 为其可编程计算器设计一套芯片。由于优秀 IC 设计人员稀缺,Intel 没有足够人力做 12 种不同的专用芯片,工程师 Ted Hoff 于是提议:做一种更通用的 4 芯片方案,指令从存储芯片中读取——带存储器的可编程状态机(PSM)就此诞生,也就是今天所说的微处理器。9 个月后,在 F. Faggin 协助下,Hoff 团队发布了 Intel 4004:一款用于 Busicom 计算器、可做 BCD 算术的 4 位 CPU。它采用 12 位程序地址、8 位指令,执行一条指令需要 5 个时钟周期。一个最小工作系统只需两块芯片:一个 4004 CPU 加一个程序 ROM。1 MHz 时钟下,每个数字以 80 ns 的速度完成多位 BCD 加法 [344]。
这里不妨算一笔账:一条指令 5 个周期、时钟 1 MHz,即每秒最多执行 20 万条指令。以今天的眼光看慢得可怜,但它把”一台计算机”塞进了两块芯片——这正是微处理器的意义所在。
Hoff 梦想把 4004 的应用从计算器扩展到数字仪表、出租车计价器、汽油泵、电梯控制、医疗设备、自动贩卖机等领域,于是说服 Intel 从 Busicom 手中买下芯片的知识产权。1971 年 5 月,Intel 以价格让步换来了向计算器以外市场销售 4004 的权利。另一个关键配角是 Intel 工程师 Dov Frohman-Bentchkovsky 发明的 EPROM:有了它,开发者可以随时编程、擦除重写,不必再依赖 IC 工厂耗时制造一次性 ROM,4004 开发系统的市场由此打开。
Intel 的客户需要更强的 CPU,于是有了能处理 4 位 BCD 算术之上运算的 8 位 CPU。8008 支持标准 RAM 和 ROM 器件,不再像 4004 那样需要定制存储器;1974 年的 8080 约 4500 个晶体管,修复了 8008 的若干缺陷;1978 年第一个 16 位微处理器 8086 问世;1982 年的 80286 性能约为 8086 的 6 倍;1985 年的 80386 是第一个支持多任务的微处理器,80387 加入算术协处理器加速浮点运算;1989 年的 80486 在包含协处理器的同时引入了指令缓存和流水线;1993 年奔腾系列诞生,拥有两条执行流水线(超标量体系结构);1997 年的奔腾 II 加入 MMX 指令,最多可并行执行 4 个类似 MAC 的向量操作;奔腾 3、奔腾 4 则引入超线程和 SSE 等加速音视频处理的技术;2006 年的 Itanium 已达双核、5.92 亿晶体管、9 MB 独立 L3 缓存。整个系列见表 9-1。
表 9-1 Intel 系列微处理器 [345](IA = 指令集体系结构)
| 名称 | 发布年份 | MHz | IA | 处理技术 | 晶体管数量 |
|---|---|---|---|---|---|
| 4004 | 1971 | 0.108 | 4 | 10μ | 2300 |
| 8008 | 1972 | 0.2 | 8 | 10μ | 3500 |
| 8080 | 1974 | 2 | 8 | 6μ | 4500 |
| 8086 | 1978 | 5~10 | 16 | 3μ | 29K |
| 80286 | 1982 | 6~12.5 | 16 | 1.5μ | 134K |
| 80386 | 1985 | 16~33 | 32 | 1μ | 275K |
| 80486 | 1989 | 25~50 | 32 | 0.8μ | 1.2M |
| 奔腾 | 1993 | 60~66 | 32 | 0.8μ | 3.1M |
| 奔腾II | 1997 | 200~300 | 32 | 0.25μ | 7.5M |
| 奔腾3 | 1999 | 650~1400 | 32 | 0.25μ | 9.5M |
| 奔腾4 | 2000 | 1300~3800 | 32 | 0.18μ | 42M |
| Xeon | 2003 | 1400~3600 | 64 | 0.09μ | 178M |
| Itanium 2 | 2004 | 1000~1600 | 64 | 0.13μ | 592M |
从这张表能直观看到”摩尔定律”的轨迹:时钟从 0.1 MHz 涨到数 GHz,晶体管从 2300 个涨到近 6 亿。从图 9-2 的各半导体公司收入对比也可以发现一个有趣的事实:Intel 仅凭微处理器这一个产品线,多年来稳居业界榜首;同样以微处理器为主业的 TI、Motorola/Freescale、AMD 收入低了很多;以存储器为主的三星、东芝虽然常年领先,也难以企及 Intel 的业绩。
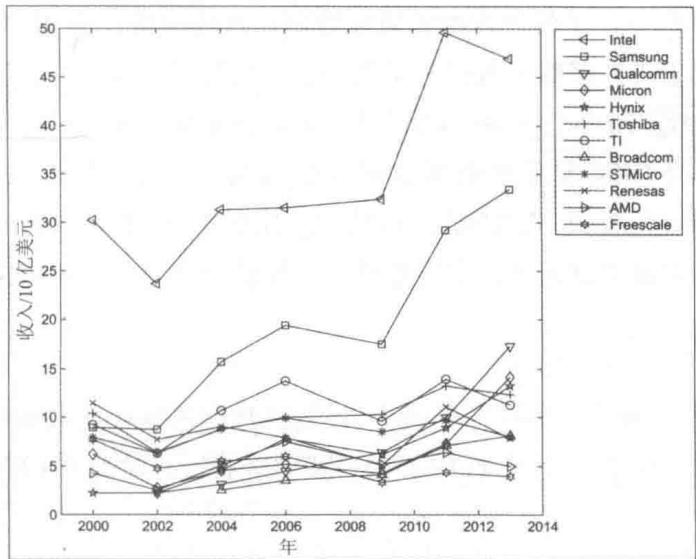
图 9-2 顶级半导体公司的收入
9.2.2 RISC 微处理器简史
Intel 体系结构也常被称为复杂指令集计算机(CISC)。从最早的 CPU 开始,后续设计一直背负”兼容”包袱——要能运行老程序。摩尔定律允许 CISC 不断叠加新特性(数字协处理器、缓存、MMX、SSE 及支持它们的指令),但随着数据和程序字节宽度增加,兼容性是以牺牲性能为代价的。Intel 处理器指令繁多、寻址模式多样,手册动辄 700 页以上。
1980 年前后,加州大学伯克利分校的 Patterson 教授、IBM(后来的 PowerPC)以及斯坦福大学的 Hennessy 教授(后来研究 MIPS——无互锁流水线级微处理器)等人分析后得出结论:从性能角度看,CISC 存在诸多问题。伯克利的新一代处理器被命名为 RISC-1 和 RISC-2,因为它们最重要的特征就是指令和寻址模式数量有限,故称精简指令集计算机(RISC)。早期 RISC 与 CISC 的典型差异如下:
- CISC 有丰富的指令集,RISC 通常支持少于 100 条指令。
- RISC 指令字长固定(通常 32 位),CISC 字长可变——Intel 指令长度在 1 到 15 字节之间。
- CISC 支持丰富的寻址模式,典型 RISC 只支持直接寻址和基于寄存器的寻址。
- CISC 的 ALU 操作数可以来自指令字、寄存器或存储器;RISC 没有直接的存储器操作数,只允许在寄存器与存储器之间加载/存储,因此 RISC 又称”加载/存储体系结构”。
- CISC 通过栈在子程序间传递参数和数据;RISC 有大量寄存器,用寄存器完成这种链接。
值得注意的是,到 20 世纪 90 年代初,两种体系结构都偏离了”纯理论形态”:如今的 CISC 也大量利用寄存器和深流水线;而 RISC(如 MIPS、PowerPC、SUN Sparc、DEC Alpha)已有几百条指令、有些还需多重循环,早已名不副实。
9.2.3 PDSP 简史
1980 年,Intel 发布了 2930——一种面向控制系统的模拟信号处理器,片内含 ADC 和 DAC,以类似 DSP 的方式实现算法,如图 9-3 所示。
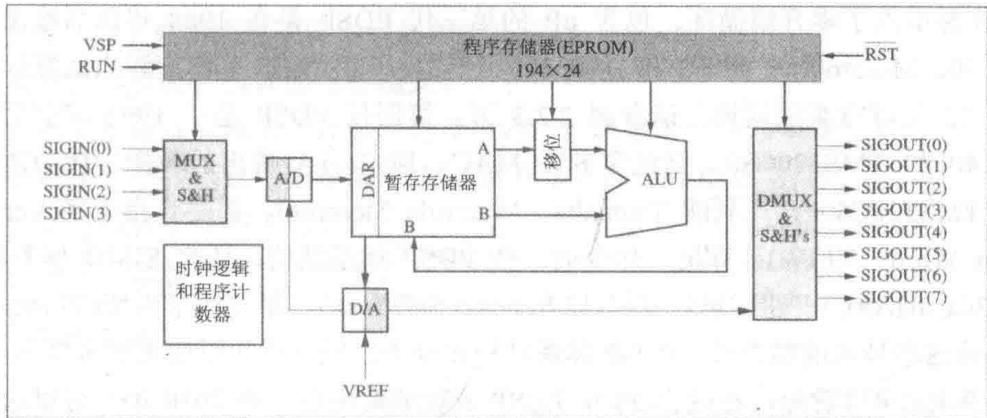
图 9-3 2920 功能模块原理图 [346]
2920 具有 40×25 位的暂存存储器、192 字的程序 EPROM、移位器和 ALU,乘法靠一系列移位加减完成。
例 9.1:用 2920 计算乘法。 先用 CSD 编码表示常数 ,得到 (其中 表示 −1),然后执行下列指令(原书汇编指令,非 HDL,照录如下):
ADD Y, X, L01;
SUB Y, X, R03;
ADD Y, X, R07;
SUB Y, X, R10;
其中最后的操作数 Rxx(Lxx)表示在加/减之前,把第二个操作数右(左)移 xx 位。逐条展开这个例子:把 拆成 ,于是
即左移 1 位加 (得 ),再减去右移 3 位的 ,加上右移 7 位的 ,减去右移 10 位的 ——四次移位加减就完成了一次与常数 的乘法,完全不需要硬件乘法器。
一些常用宏函数在 2920 中的开销见表 9-2。
表 9-2 可用在 2920 中的部分宏模块
| 功能 | 指令 |
|---|---|
| 常数相乘 | 1~5 |
| 变量相乘 | 10~26 |
| 三角波发生器 | 6~10 |
| 阈值检测器 | 2~4 |
| 正弦波发生器 | 8~12 |
| 单一实极点 | 2~6 |
可以看到变量相乘要 10~26 条指令——没有硬件乘法器的代价一目了然。虽然还不能把 2920 称为 PDSP,但它具备了 PDSP 的许多重要特征,并发展成 20 世纪 80 年代初的第一代 PDSP(TI 的 TMS320C10、NEC 的 μPD7720),其标志是哈佛体系结构(程序和数据分存于独立存储器)和占用大量芯片面积的硬布线乘法器,可在一个时钟周期内完成单次乘法。第二代 PDSP(约 1985 年,TMS320C25、MC56000、DSP16)实现单周期 MAC 并引入零开销循环。含 μP 特性的第三代(1988 年后,TMS320C30、96002、DSP32C)支持 IEEE 单精度浮点的单周期 32 位浮点乘法。第四代(约 1992 年,TMS320C40、C80)包含多核 MAC。1997 年后的最新一代(TMS320C60x、飞利浦 Trimedia、Motorola Starcore)是长指令字(VLIW)计算机。如今的 PDSP 还有 SIMD(ADSP-2126x SHARC)、超标量(Renesas SH77xxx)、矩阵数学引擎(Intrinsity、FastMath)或它们的混合——PDSP 体系结构已变得高度多样化。
从图 9-4(a) 可见,过去 20 年 PDSP 表现出色,2010 年已可达每秒 3 万亿条指令 [347];从图 9-4(b) 的市场份额看,TI 长期占据大头(Agere 是从前的 Lucent/AT&T,Freescale 是从前的 Motorola)。最近一些 PDSP 内核已可做 FPGA 设计,如 Cast 公司(www.cast.com)的 TI TMS32025 和 Motorola/Freescale 的 56000 内核。不过 PDSP 中的许多 I/O 单元(计时器、DMA、UART 等)通常不在 FPGA 内核中实现。
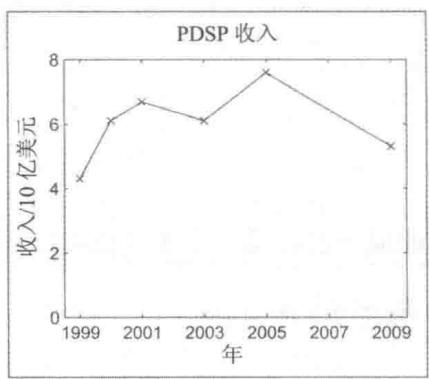
图 9-4(a) PDSP 处理器收入
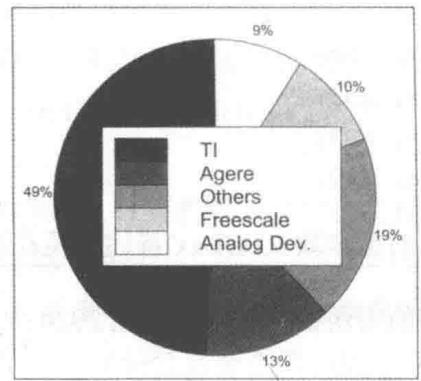
图 9-4(b) PDSP 市场份额
9.3 指令集设计
指令集描述了微处理器可执行的行为集合。设计者的第一个问题是:“我的应用需要哪些算法操作?“例如 DSP 应用,重点往往是对快速加法和乘法的支持——用一串小移位加法来算乘法对繁重的 DSP 处理来说并不是好选择。除 ALU 操作外,还需要数据移动指令和程序流指令(如 branch 或 goto)。
指令集设计还依赖于底层体系结构,脱离硬件组件很难完整定义指令集。这项工作很复杂,最好分解成多个步骤,依次回答以下问题:
- 微处理器支持什么样的寻址模式?
- 基础数据流体系结构是什么,即一条指令包含几个操作数?
- 在哪里可以找到这些操作数(寄存器、存储器还是端口)?
- 可以支持什么类型的运算?
- 在哪里可以找到下一条指令?
9.3.1 寻址模式
寻址模式回答的是”如何定位运算的操作数”。CISC 可能支持十几种模式,而面向性能的设计(RISC、PDSP)会把模式限制在最常用的几种。下面逐一介绍。
1. 隐式寻址
隐式寻址中,操作数的位置不由指令显式给出,而是约定俗成,如图 9-5 所示。例如不带操作数的 ADD 用的是栈机——栈机所有算术运算都作用于栈顶前两个单元;又如 TMS320 PDSP 中的 ZAC 指令用于清空累加器。表 9-3 列出了一些典型例子。
表 9-3 不同微处理器的隐式寻址模式
| 指令 | 说明 | μP |
|---|---|---|
| ZAT | 清空累加器和 T 寄存器 | TMS320C50 |
| APAC | 将 P 寄存器的内容加到累加器并替换累加器的值 | TMS320C50 |
| RET | 将 ra 寄存器的值加载到 PC 中 | Nios II |
| BRET | 将 b 状态复制到状态寄存器并将 ba 寄存器的值加载到 PC 中 | Nios II |
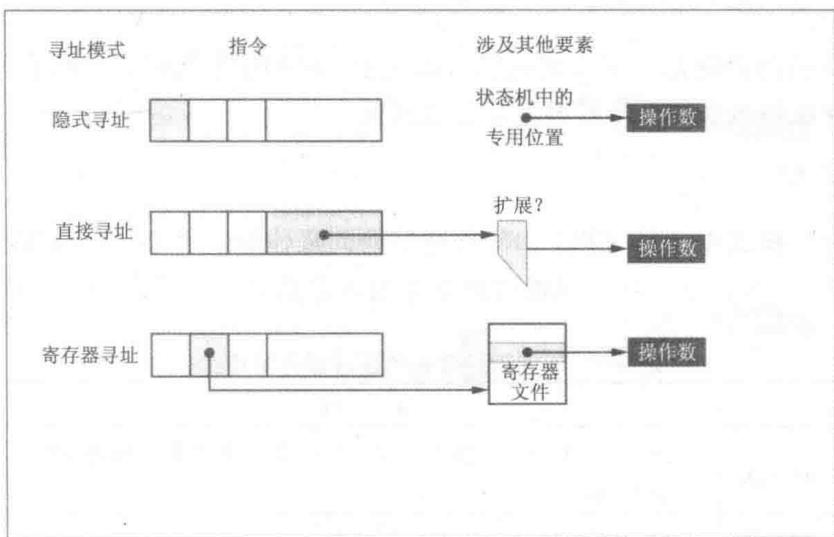
图 9-5 隐式寻址、直接寻址和寄存器寻址
2. 直接寻址
直接寻址中,操作数(如常数)就包含在指令里。问题是指令字通常比完整数据字短几位,塞不下全长常数。常用解决办法有四种:
(a) 符号扩展。程序中的大部分常数(增量、循环计数)都很小,用不到全长;扩展时复制 MSB 而不是补零,这样 −1 的扩展才是正确的(见下面的 MPY-5 示例)。
(b) 分两次加载。用两条指令分别加载常数的低位和高位部分,再拼接成完整字长(见 LPH DAT0)。
(c) 双长度指令。用第二个字扩展默认长度,即可装下全精度常数(见 RPT 1111h)。
(d) 筒形移位分配。将常数按所需形式移位后对齐(见 ADD 11h, 2)。
表 9-4 列出了不同微处理器上的直接寻址示例。
表 9-4 不同微处理器的直接寻址模式
| 指令 | 说明 | μP |
|---|---|---|
| CNTR=10; | 把循环计数设置为 10 | ADSP |
| MPY-5 | 将 13 位常数符号扩展到 16 位,与 TREG0 寄存器相乘,结果存入 P 寄存器 | TMS320C50 |
| LPH DAT0 | 把存储器地址 DAT0 中的数据加载到 32 位乘积寄存器的上半部分 | TMS320C50 |
| RPT 1111h | 重复下一条指令 次。这是双字指令,常数为 16 位 | TMS320C50 |
| ADD 11h,2 | 将 11h 移位 2 位后加到累加器中 | TMS320C50 |
为避免两次访问存储器,可以把方法 (a) 与 (b) 结合:只要保证高位加载发生在低位指令符号扩展之后即可。
3. 寄存器寻址
操作数从 CPU 内部寄存器取得,不做外部存储访问,如图 9-5 所示。表 9-5 给出了一些示例。
表 9-5 不同微处理器的寄存器寻址模式
| 指令 | 说明 | μP |
|---|---|---|
| MR=MX0*MY0(RND) | 将 MX0 与 MY0 寄存器中的数相乘(带舍入)并存入 MR 寄存器 | ADSP |
| SUB sA,sB | 将 sA 减去 sB 并存回 sA | PicoBlaze |
| XOR r6,r7,r8 | 计算 r7 与 r8 的 XOR,结果存入 r6 | Nios II |
| LAR AR3,#05h | 用值 5 加载辅助寄存器 AR3 | TMS320C50 |
| OR %i1,%i2 | 对 i1、i2 做 OR,结果替换 i1 | Nios |
| SWAP %g2 | 交换 32 位寄存器 g2 中的 16 位半字并放回 g2 | Nios |
寄存器访问比内存访问更快、功耗更低,因此 RISC 计算机大量使用寄存器寻址:所有算术操作基本只在 CPU 寄存器内完成,对存储器的访问仅通过单独的加载/存储指令。
4. 存储器寻址
对存储器的直接、间接或混合访问是最常用的模式。直接存储器寻址中,指令字的一部分给出要访问的地址,如图 9-6 及 FETCH 示例所示。与直接常数寻址同样的问题再次出现:指令字里能放的地址位数不足以表达完整地址。解决办法是借助辅助寄存器:若把辅助寄存器加到直接地址上,称为基址寻址(如 LDBU 示例);若辅助寄存器只提供缺失的高位 MSB,称为分页寻址(如 AND 示例,访问页外数据需先更新页指针);由于基址寄存器代表完整地址,也可以完全不给出直接地址、只用寄存器访问,这就是间接寻址(如 PM(I6,M6))。
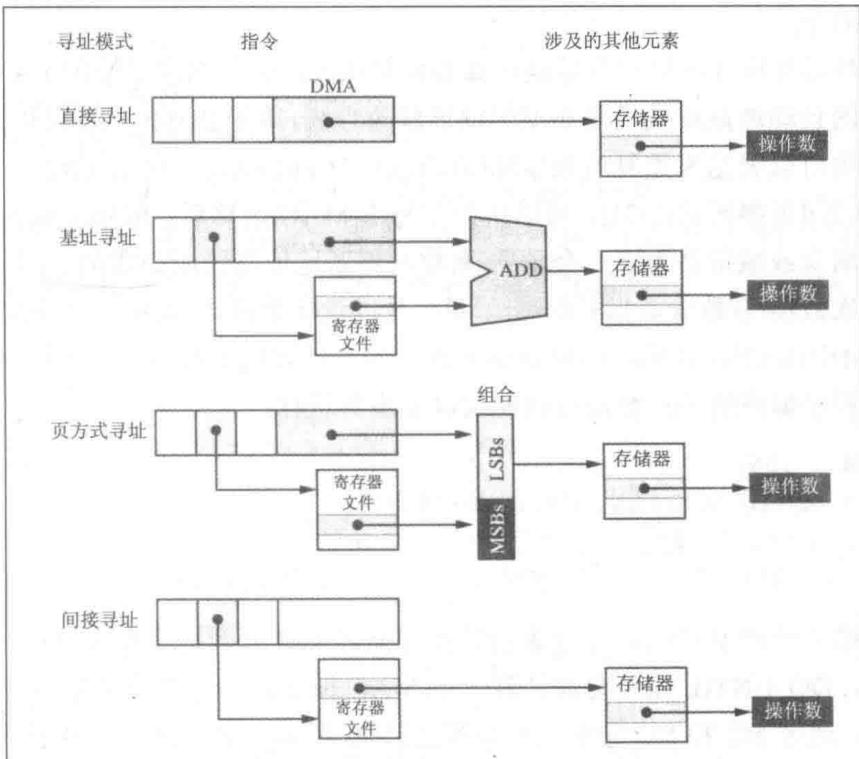
图 9-6 存储器寻址:直接、基址、页方式和间接寻址
表 9-6 列出了四种典型存储器寻址示例。
表 9-6 不同微处理器的存储器寻址模式
| 指令 | 说明 | μP |
|---|---|---|
| FETCH sX,ss | 将临时 RAM 位置 ss 读取到寄存器 sX 中 | PicoBlaze |
| LDBU r6,100(r5) | 计算 100 与 r5 的和,并从这一地址把数据加载到 r6 | Nios II |
| AND DAT16 | 设 9 位数据页寄存器指向第 4 页,则从内存位置 访问数据字并在累加器中做 AND | TMS320C50 |
| PM(I6,M6)=AR | 以 I6 为地址把 AR 存入程序存储器;访问后按修正寄存器 M6 的值更新 I6 | ADSP |
间接寻址只需要少量变址寄存器,可显著缩短指令字,因此是 PDSP 中最常用的方式;而 RISC 更偏爱基址寻址——用”基址+偏移”可以方便地访问阵列元素(如上面的 LDBU)。
5. PDSP 专用寻址模式
PDSP 之所以处理 DSP 算法比标准 GPP/RISC 更高效,关键在于三种专用寻址模式:
- 自动增/减量寻址
- 循环寻址
- 位倒序寻址
前两种服务于卷积和相关运算,位倒序寻址用于 FFT。
(1)自动增/减量寻址。 卷积和相关本质上是重复的乘累加(MAC)运算,即两个向量的内积(参见式 (3-2))。每次 MAC 之后,必须更新数据/系数指针指向下一对操作数。PDSP 在每次存储器访问后自动执行指针增/减量——地址更新不占 CPU,由单独的地址寄存器文件完成,如图 9-7 所示,从而实现单循环 MAC。用 ADSP 汇编编写的 FIR滤波(原书汇编,照录):
CNTR = 256;
MR = 0, MX0 = DM(I0, M1), MY0(I4, M5)
DO FIR UNTIL CE;
FIR: MR= MR+MX0*MY0(SS), MX0=DM(I0, M1), MY0=PM(I4, M5)
初始化循环计数器 CNTR 以及来自数据存储器 DM 的 x 指针和来自程序存储器 PM 的 y 指针后,DO UNTIL 循环在一个时钟周期内完成一条 MAC 并同时加载两个数据,随后用 M1、M5 分别更新指针 I0、I4。注意这里的另一个 PDSP 特性——零开销循环:循环计数器的更新与判断在循环尾部自动完成,不需要额外周期,这与 GPP/RISC 需要专门指令处理循环不同。
(2)循环寻址。 先看 FIR 计算中数据排列的演化。计算第一个输出 时,数据 与系数 按如下方式对齐(同一列相乘后累加):
计算 时需要的数据是:
一种做法是每次 MAC 后移动每个数据字——TMS320 系列为此提供了 MACD 指令(MAC 加数据移动)[349],N 次 MACD 后整个向量 x 移动一个位置。另一种更聪明的观察是:其实系数不用动,把新样本 写到最旧样本 的位置即可:
| x[L] | x[1] | x[2] | … | x[L-2] | x[L-1] |
数据指针从 x[1] 开始照常工作,只有走到缓冲区结尾 x[L-1] 时才需要把指针绕回开头。设缓冲区由 4 个参数描述: = 缓冲器长度, = 当前地址, = 修改值(有符号数), = 缓冲器基址,则所需地址计算为:
这就是循环寻址:每次地址修改后都核对结果是否仍落在有效范围内。图 9-7 给出了 ADSP PDSP 按式 (9-1) 实现的地址生成器。
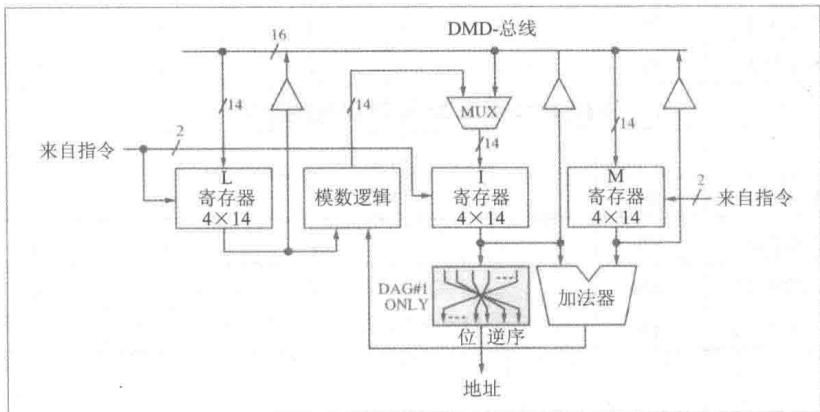
图 9-7 ADSP 可编程数字信号处理器中地址的生成
(3)位倒序寻址。 第 6 章讲过,基 2 FFT 的输入/输出呈位倒序次序(图 6-14)。用软件计算位倒序变址通常要很多时钟周期,因为每一位都要重排。PDSP 通过专用寻址模式硬件化了这个过程。
例 9.2: ADSP [350] 和 TMS320C50 [349] 都支持位倒序寻址。TMS320 系列的汇编示例(原书汇编,照录):
先把当前辅助寄存器减去 INDX 寄存器的内容,再对地址值执行位倒序以定位操作数;取回的数据字移位 8 位后加到累加器中。
表 9-7 总结了 PDSP 及其支持的寻址模式:所有 PDSP 都支持自动增/减量,大多数也支持循环缓冲器和位倒序寻址。
表 9-7 在卷积中有用的 PDSP 属性(© Springer 出版社文献 [5])
| 供应商 | 类型 | 累加位 | 超级哈佛结构 | Modulo 地址 | 位倒序 | 硬件循环 | MAC 速度(MHz) |
|---|---|---|---|---|---|---|---|
| PDSP 16 位×16 位整型数乘法器 | |||||||
| Analog Device | ADSP-2187 | 40 | √ | √ | √ | √ | 52 |
| Analog Device | ADSP-21csp01 | 40 | √ | √ | — | — | 50 |
| Lucent | DSP1620 | 36 | √ | — | √ | √ | 120 |
| Motorola | DP56166 | 36 | √ | √ | √ | √ | 60 |
| NEC | μPD77015 | 40 | √ | √ | √ | √ | 33 |
| TI | TMS320F206 | 32 | √ | — | √ | √ | 80 |
| TI | TMS320C51 | 32 | √ | √ | √ | √ | 100 |
| TI | TMS320C549 | 40 | √ | √ | √ | √ | 200 |
| TI | TMS320C601 | 40 | 2 MAC | √ | √ | √ | 500 |
| TI | TMS320C80 | 32 | 2 MAC | √ | √ | √ | 50 |
| PDSP 24 位×24 位整型数乘法器 | |||||||
| Motorola | DSP56011 | 56 | √ | √ | √ | √ | 80 |
| Motorola | DSP56305 | 56 | √ | √ | √ | √ | 100 |
| PDSP 24 位×24 位浮点数乘法器 | |||||||
| Analog Device | SHARC 21061 | 80 | √ | √ | √ | √ | 40 |
| Motorola | DSP96002 | 96 | √ | √ | √ | √ | 60 |
| TI | TMS320C31 | 40 | √ | √ | √ | √ | 60 |
| TI | TMS320C40 | 40 | √ | √ | √ | √ | 60 |
9.3.2 数据流:零地址、单地址、二地址和三地址设计
指令的典型汇编编码是”操作码 + 操作数”。一个 ALU 运算通常需要两个操作数,可能还要指明结果的存放位置。对程序员最自然的方式是一条指令含一个操作码加三个操作数,但这需要很长的指令字。算一笔账:假设 FPGA 嵌入式存储器有 1K 字,不考虑操作码的寻址方式至少需要 30 位;现代 CPU 直接寻址 4GB 需要 32 位地址,三操作数直接寻址的指令字至少要 96 位。所以,限制操作数数量可以缩短指令字、节约资源——零地址的栈机在这方面做到极致;另一种方式是用寄存器文件代替直接存储器访问,RISC 就是只允许加载/存储单个存储器操作数:对于 8 个寄存器的 CPU,只需 9 位就能规定三个(寄存器)操作数,代价是需要额外的指令在存储器和寄存器文件之间搬数据。
下面依次讨论零到三操作数设计。作为统一的对照,四种机器都要计算同一个表达式:
1. 栈机:零地址 CPU
零地址计算机怎么工作?回顾 9.3.1 节:操作数可以隐式给出。与 TI PDSP 把所有乘积固定放入乘积寄存器 P 类似,栈机的所有二操作数算术指令都作用于栈顶的两个元素 [351]。栈是后入先出(LIFO)结构:PUSH 放入的元素在 POP 时最先出来。式 (9-2) 的栈机计算过程见表 9-8,左侧是指令,右侧是各步执行后栈的内容(栈顶在左)。
表 9-8 栈运算指令
| 指令 | 栈顶 | 2 | 3 | 4 |
|---|---|---|---|---|
| PUSH 5 | 5 | — | — | — |
| PUSH a | A | 5 | — | — |
| SUB | 5 - a | — | — | — |
| PUSH b | B | 5 - a | — | — |
| PUSH c | C | b | 5 - a | — |
| MUL | c × b | 5 - a | — | — |
| ADD | c × b + 5 - a | — | — | — |
| POP d | — | — | — | — |
所有算术运算(ADD、SUB、MUL)都用隐式的栈顶和次栈顶,这就是”零地址”;但存储器操作 PUSH 和 POP 仍需要一个操作数。
由于操作数先于运算出现,栈机代码称为后缀表示法(逆波兰表示法)。式 (9-2) 的中缀与后缀写法对照如下:
一些读者可能记得,HP41C 袖珍计算器用的正是后缀表示法,它也使用 4 个值的栈。图 9-8(a) 给出了这种体系结构。
2. 累加器机:单地址 CPU
给 CPU 加一个累加器,让它固定充当一个操作数的来源和结果的去处,算术运算形式为:
其中 □ 代表一种 ALU 运算(ADD、MUL、AND 等)。TI TMS320 系列的底层体系结构就是这种类型,如图 9-8(b) 所示。式 (9-2) 在 TMS320C50 [349] 上的汇编代码见表 9-9。
表 9-9 TMS320C50 的汇编程序代码
| 指令 | 说明 |
|---|---|
| ZAP | 清空 accu 和 P 寄存器 |
| ADD 5h | 加 5 到 accu |
| SUB DAT1 | 从 accu 减 DAT1 |
| LT DAT2 | 在 T 寄存器中加载 DAT2 |
| MPY DAT3 | 将 T 寄存器与 DAT3 相乘,结果存入 P 寄存器 |
| APAC | 将 P 寄存器内容加到 accu |
| SACL DAT4 | 将 accu 存储到地址 DAT4 |
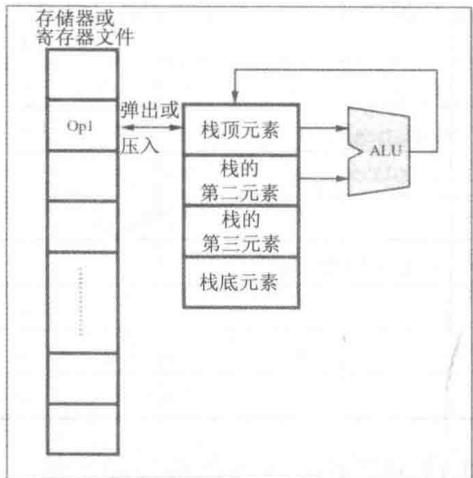
图 9-8(a) 栈 CPU 体系结构
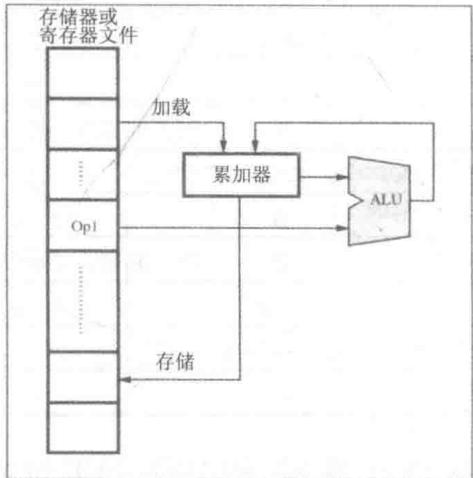
图 9-8(b) 累加器机体系结构
这一示例假定变量 ad 已映射到数据存储器 DAT1DAT4。比较栈机和累加器机可以得到两个结论:
- 指令字的规模没有减小——栈机同样需要带操作数的 PUSH/POP。
- 编码表达式的指令条数没有明显减少(累加器机 7 条,栈机 8 条)。
要显著减少指令条数,就得指望二操作数机了。
3. 二地址 CPU
二地址机允许规定两个独立操作数,目的操作数兼作第一个操作数,运算形式为:
其中 □ 代表一种 ALU 运算(SUB、DIV、NAND 等)。Xilinx PicoBlaze [335,352] 和 Altera 的 Nios 处理器 [353] 采用这种数据流,如图 9-9(a) 所示。受二操作数限制,这些机器使用 16 位指令字格式。式 (9-2) 在 PicoBlaze 上的汇编代码见表 9-10。
表 9-10 PicoBlaze 的汇编程序代码
| 指令 | 说明 |
|---|---|
| LOAD sD, sB; | 将寄存器 B 存入寄存器 D |
| MUL sD, sC; | 将 D 与寄存器 C 相乘 |
| ADD sD, 5; | 加 5 到 D |
| SUB sD, sA; | 从 D 中减 A |
注意运算顺序被重排了:先算 (对应 的顺序),以避免产生乘积的中间结果。另外要说明:PicoBlaze 实际没有单独的 MUL 运算,这段代码仅用于说明二操作数的编码法则。PicoBlaze 有 16 个 8 位寄存器;两个操作数(各 4 位)加 8 位常数,正好能把操作码和操作数放进一个 16 位指令字。可以看到,与栈机和累加器机相比,二操作数编码显著减少了运算条数。
4. 三地址 CPU
三地址机最灵活:两个源操作数和目的操作数可以各不相同,运算形式为:
大多数现代 RISC 计算机(PowerPC、MicroBlaze、Nios II)都采用这种编码 [354~356],但操作数通常是寄存器操作数,或至多一个操作数来自数据存储器。数据流如图 9-9(b) 所示。
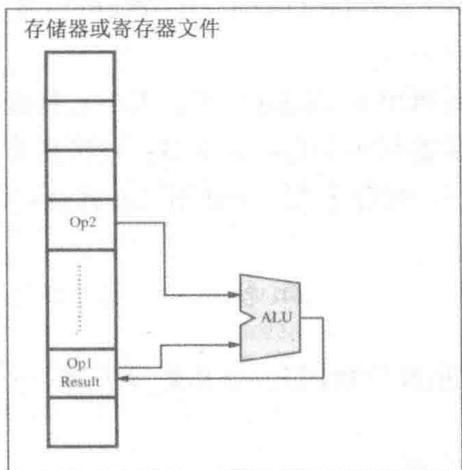
图 9-9(a) 二地址 CPU 体系结构
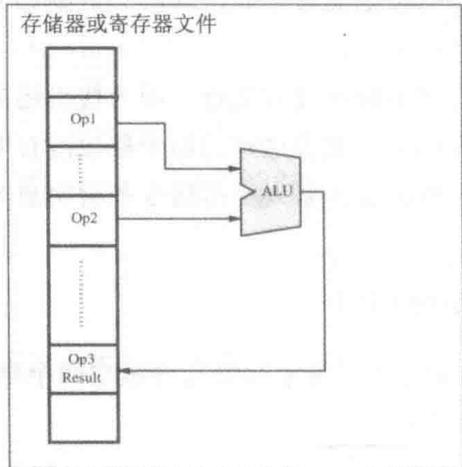
图 9-9(b) 三地址机体系结构
三地址机的汇编编程简单直接。式 (9-2) 按 Nios II 指令编码见表 9-11。
表 9-11 式(9-2)中的算术示例用到的指令
| 指令 | 说明 |
|---|---|
| SUBI r4,r1,5; | 从 r1 中减 5,结果存入 r4 |
| MUL r5,r2,r3; | 将 r2 与 r3 相乘,结果存入 r5 |
| ADD r4,r4,r5; | 将 r4 与 r5 相加,结果存入 r4 |
这里假定寄存器 r1r4 保存变量 ad 的值。这是四种机器中最短的代码——只有 3 条指令,代价是指令字更长。就硬件实现而言,二地址机与三地址机没有明显差别,因为寄存器文件都需要相同的多路复用器和信号分离器。
5. 四种 CPU 的比较
对本节加以总结:
- 栈机程序最长,但单条指令最短。
- 即使栈机也需要带地址的单地址指令访问存储器。
- 三地址机代码最短,但每条指令所需位数最大。
- 用寄存器代替直接存储器地址可以缩短指令字。三地址机通常用两个寄存器加一个存储器操作数。
- 加载/存储机只允许数据在存储器和寄存器之间移动,所有 ALU 运算都通过寄存器文件完成。
- 大多数设计假设寄存器访问比存储器访问快——这对使用外部存储器的 CBIC 或 FPGA 成立。在 FPGA 中,寄存器文件内访问与嵌入式存储器访问的时间在同一量级,因此也可以选择用嵌入式(三端)存储器实现寄存器文件。
看起来没有”完美答案”,实践中各种寻址方式都在使用。为什么没有一种最佳数据流类型?因为这取决于设计目标。表 9-12 从多个维度做了对比。
表 9-12 0 至 3 操作数 CPU 的不同设计目标的比较
| 设计目标 | 0 操作数 | 1 | 2 | 3 操作数 |
|---|---|---|---|---|
| 汇编程序容易程度 | 最差 | … | … | 最佳 |
| 简单 C 编译器 | 最佳 | … | … | 最差 |
| 代码字数量 | 最差 | … | … | 最佳 |
| 指令长度 | 最佳 | … | … | 最差 |
| 直接范围 | 最差 | … | … | 最佳 |
| 快速操作数存取和解码 | 最佳 | … | … | 最差 |
| 硬件规模 | 最佳 | … | … | 最差 |
具体展开说:三地址汇编代码比栈机的大量 PUSH/POP 更易读易写,所以”汇编容易程度”三地址最佳;而栈机最适合简单 C 编译器——中缀表达式转后缀很机械,解析简单,但高效管理寄存器文件对编译器是艰巨任务。中间结果可以留在寄存器里,所以操作数越多”代码字数量”越少。指令长度与操作数数量成正比;指令字越短,能嵌入的常数也越短,就需要多次加载或双字指令(参见图 9-6 存储器寻址)。操作数越少,提取和解码越快——栈机总用栈的前两个元素,没有寄存器文件长 MUX/DEMUX 的延迟。硬件规模主要取决于寄存器文件:三操作数机要求最高,栈机最低,而 ALU 和控制单元的规模彼此接近。
总之,每种体系结构都有强项和弱项,必须与设计者的工具、技能、设计目标(规模/速度/功耗)以及开发工具(指令集仿真器、C 编译器)相匹配。
9.3.3 寄存器文件和存储器体系结构
计算机发展早期存储器非常昂贵,冯·诺依曼提出了著名的创新:把数据和程序放进同一存储器,如图 9-10(a) 所示——那个年代程序通常硬布线在 FSM 里,只有数据用 RAM。如今情况反转:存储器便宜了,但典型 RISC 计算机的主存访问远慢于 CPU 寄存器。于是三地址机面临取舍:三个操作数全部来自主存?还是只有部分来自主存?是否所有 ALU 运算都该由 CPU 寄存器执行(加载/存储体系结构的立场)?VAX PDP-11 是这方面的”冠军”,允许多个存储器和多个寄存器运算。
对 FPGA 设计还有一条额外约束:指令字数量通常以千计,若程序和数据混在同一存储器(冯·诺依曼方式),复用数据和程序字会浪费时间,因此 FPGA 微处理器应使用独立的程序存储器和数据存储器——这就是哈佛体系结构,如图 9-10(b) 所示。对 PDSP 来说还可以更进一步:系数和数据来自两个不同的数据存储器 x 和 y,累加结果保存在 CPU 寄存器中(回忆 FIR 滤波器的用法),程序放在第三个存储器——由于 DSP 算法往往很短,一些 PDSP(如 ADSP)用小规模缓存替代第三条总线:第一遍循环后指令已存入缓存,程序存储器可当第二个数据存储器用。这种三总线结构如图 9-10(c) 所示,称为”超级哈佛体系结构”。
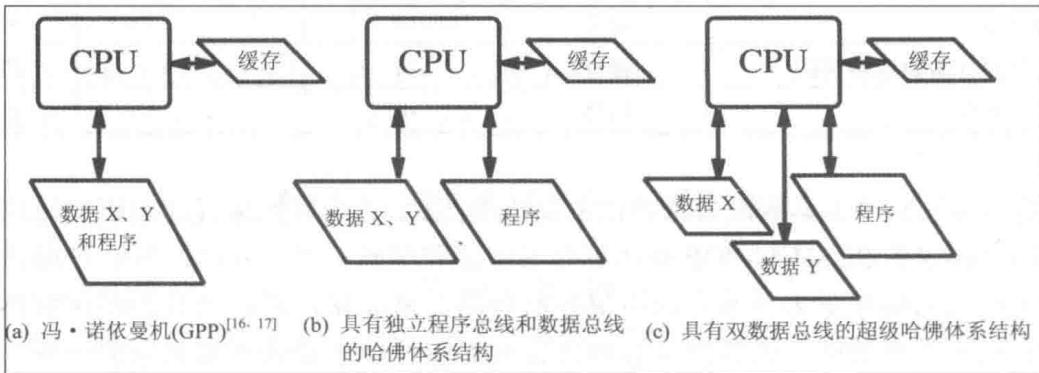
图 9-10 存储器体系结构
GPP(如 Intel 奔腾)和 RISC 计算机通常采用存储器分层结构(寄存器 → L1/L2 缓存 → 主存 DRAM → CD-ROM/磁带等外部介质),为 CPU 提供连续数据流的同时使用较便宜的大容量存储器。这种存储系统的设计远比 FPGA 内部能实现的复杂。
从硬件角度看,CPU 可以拆成三个主要部分:
- 控制路径,即有限状态机
- ALU
- 寄存器文件
三部分中寄存器文件的设计不难,但用 LE 实现时成本最高。因此要在”更多寄存器带来的好用性”与”寄存器文件的高实现成本”之间权衡(例如 32 个寄存器)。下面的例子给出典型 RISC 寄存器文件的编码。
例 9.3 RISC 寄存器文件
设计 RISC 寄存器文件时经常实现大量寄存器。为避免额外的清零指令或寄存器移动指令,通常把第一个寄存器永久置零。这看似浪费了一个寄存器,却实实在在简化了汇编编码,见表 9-13。
表 9-13 简化的指令
| 指令 | 说明 |
|---|---|
| ADD r3,r0,r0; | 将寄存器 r3 置零 |
| ADD r4,r2,r0; | 将寄存器 r2 移到寄存器 r4 |
| LDBU r5,100(r0); | 计算 100 与 r0=0 的和,并从这一地址把数据加载到 r5 |
请注意,这些伪指令只有在第一个寄存器 r0 恒为零的假设下才成立。
原书 VHDL 改写为 Verilog——下面是一个 W 位宽、N+1 个寄存器的通用寄存器文件(第一个寄存器恒为零):
// W x L bit register file, first register is hardwired to zero.
module reg_file #(
    parameter W = 7,   // 位宽-1(即数据 8 位)
    parameter N = 15   // 寄存器个数-1(即 16 个寄存器)
)(
    input  wire         clk,      // 系统时钟
    input  wire         reset,    // 异步复位
    input  wire         reg_ena,  // 写使能,高有效
    input  wire [W:0]   data,     // 写入数据
    input  wire [3:0]   rd,       // 写地址
    input  wire [3:0]   rs,       // 读地址 1
    input  wire [3:0]   rt,       // 读地址 2
    output wire [W:0]   s,        // 读出数据 1
    output wire [W:0]   t         // 读出数据 2
);

    reg [W:0] r [0:N];   // 寄存器堆
    integer k;

    // 写端口:同步写,异步清零;寄存器 0 不允许被改写
    always @(posedge clk or posedge reset) begin
        if (reset) begin
            for (k = 0; k <= N; k = k + 1)
                r[k] <= {(W+1){1'b0}};
        end else if (reg_ena && rd > 0) begin
            r[rd] <= data;
        end
    end

    // 两个组合读端口(读寄存器 0 时返回 0)
    assign s = (rs > 0) ? r[rs] : {(W+1){1'b0}};
    assign t = (rt > 0) ? r[rt] : {(W+1){1'b0}};

endmodule
时钟进程负责把输入 data 写入寄存器堆,注意 rd 为 0 时禁止写入,因为寄存器 0 永远为零;两个连续赋值语句对应原书第二个进程中的两个解码器,为 ALU 读出两个源操作数,读地址为 0 时直接给出 0。该设计用 226 个 LE,不使用嵌入式乘法器和 M9K;由于寄存器到寄存器之间没有路径,无法测量时序性能 Fmax。
对照图 9-11 的仿真结果理解行为:输入 data(配合写地址 rd)被连续写入寄存器堆;输出 s 由 rs 设为寄存器 2,输出 t 由 rt 设为寄存器 3。可以观察到寄存器写使能在 600 ns 到 800 ns 之间无效,因此寄存器 2 没有被值 12 覆盖;而使能在 800 ns 时再次变高,新值 14 写入了寄存器 3——这从 t 信号的跳变可以看到。信号图最后显示的是寄存器堆的内部变量 r。
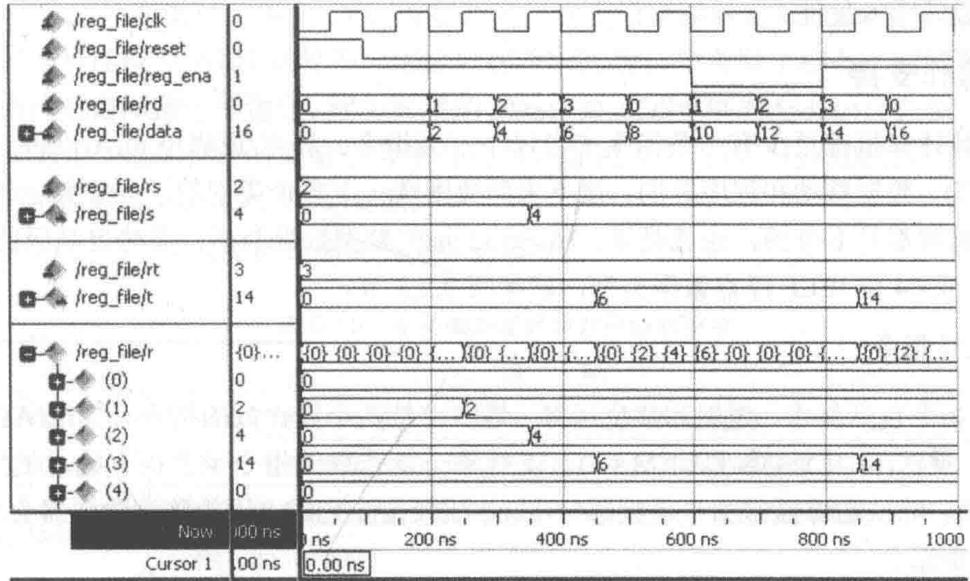
图 9-11 寄存器文件的仿真结果
图 9-12 显示了寄存器个数从 4~32、位宽为 8/16/24/32 时各种配置的 LE 消耗,可以据此为容量和成本做折中。
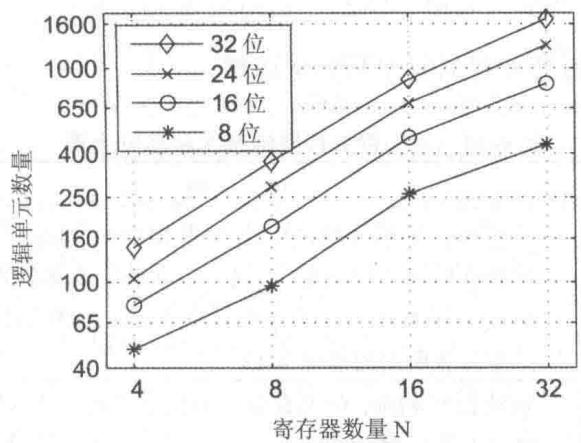
图 9-12 不同寄存器文件配置的 LE
Xilinx 的 FPGA 还可以把 LE 用作双端存储器(参见第 1 章图 1-11)。而对 Altera 的 FPGA,唯一的省 LE 途径是把寄存器文件放进嵌入式存储器:可用一个三端存储器或两个嵌入式双端存储器模块——两个存储器写入相同的数据,从各自端口分别读出两个源操作数。Nios 微处理器就利用这一原则大幅降低了 LE 数量:只用较低的第 015(或 031)个寄存器,或者像 Nios 那样给寄存器开”窗口”。窗口可以移动,例如调用子例程时不必在栈或存储器中保存寄存器现场,直接切换到新窗口即可。
不过从时序角度还有一个问题:BlockRAM 是同步存储器,不能在同一个时钟沿上同时完成”取当前地址的数据供解码用”和”按当前信号写入新值”——也就是不能用同一时钟沿既读旧值又写新值。解决办法是:用上升沿提供要读取的操作数地址,再用下降沿存储新值并设置写使能,一拍拆成两个半拍使用。
9.3.4 操作支持
大多数计算机的指令至少属于以下三类之一:算术/逻辑单元(ALU)操作、数据移动和程序控制。这里只需简要记住分类即可。基本数据类型通常是多位整型(8、16、32 位);某些更高级的处理器还使用 32 位或 64 位 IEEE 浮点数据类型(参见 2.2.3 节)。