第48章:以太网ICMP测试实验
上一章的 ARP 解决了"找到对方"的问题,这一章更进一步:让电脑能 ping 通开发板。这背后靠的是 ICMP 协议,以及它脚下的 IP 协议——这是以太网实战里协议栈最"厚"的一章。
本章在讲什么?(先看这个)
实验任务一句话概括:电脑发 ping 命令 → FPGA 解析 ICMP 请求 → 原样回一个 ICMP 应答。
要实现它,新增的知识点有三个:
- IP 协议:ICMP 报文的"运输车",重点掌握 IP 首部格式和首部校验和算法;
- ICMP 协议:回显请求(ping 请求)与回显应答(ping 应答)的报文格式;
- 协议切换架构:ARP 和 ICMP 共用一条 GMII 发送总线,需要一个控制模块做"二选一"。
核心概念拆解
48.1 ICMP:网络的"体检报告"
ICMP(Internet Control Message Protocol,互联网控制报文协议)不传输用户数据,专门传递"网络本身的消息":通不通、可达吗、路由还行吗。我们天天用的 ping 和 tracert 命令,底层都是 ICMP。
以太网传输 ICMP 数据的封装关系是三层套娃:
MAC帧 [ 数据段 = IP数据报 [ 数据段 = ICMP报文 [ 数据段 = 用户数据 ] ] ]
48.2 IP 数据报格式:20 字节首部逐字段过一遍
| 字段 | 位数 | 要点 |
|---|---|---|
| 版本 | 4 | IPv4 填 0100 |
| 首部长度 IHL | 4 | 无可选字段时为 5(5×4=20 字节) |
| 服务类型 TOS | 8 | 一般填 0 |
| 总长度 | 16 | 首部+数据,最大 65535 字节 |
| 标识 | 16 | 每发一份报文加 1 |
| 标志+片偏移 | 3+13 | 本实验设"不分片"(010) |
| 生存时间 TTL | 8 | 防止包无限循环,常填 64/128 |
| 协议 | 8 | ICMP=1,TCP=6,UDP=17 |
| 首部校验和 | 16 | 只校验首部,不含数据 |
| 源/目的 IP | 32+32 | 192.168.1.102 / 192.168.1.10 |
重点:IP 首部校验和的手算方法。以总长 60 字节的包为例:
第1步:把校验和字段置0,首部按16位分组逐一反码累加
0x4500+0x003C+0x0000+0x4000+0x4001+0x0000+0xc0a8+0x010a+0xc0a8+0x0166 = 0x248FD
第2步:把高16位折叠加到低16位(可能要折多次)
0x0002+0x48FD = 0x48FF
第3步:按位取反
check_sum = ~0x48FF = 0xb700
记住"分组累加 → 折叠进位 → 取反"三步曲,后面代码里会原样出现。
48.3 ICMP 报文格式:ping 的前后半场
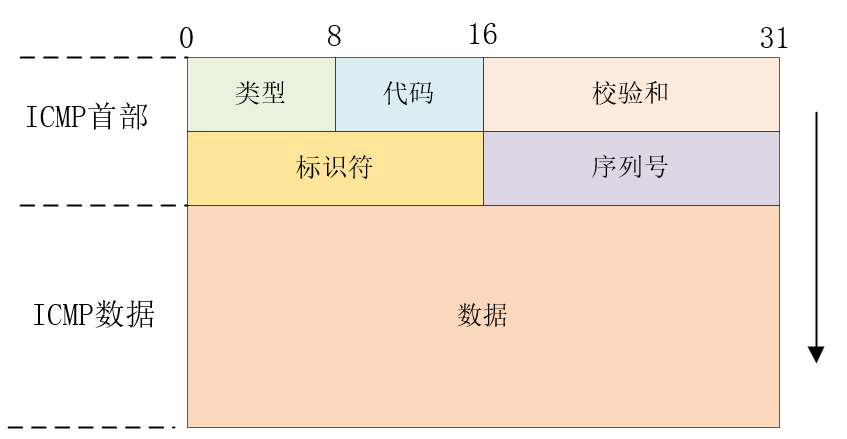
ICMP 首部 8 字节:
| 字段 | 位数 | 说明 |
|---|---|---|
| 类型 Type | 8 | 8=回显请求,0=回显应答(ping 的核心) |
| 代码 Code | 8 | 请求/应答场景固定为 0 |
| 校验和 | 16 | 算法与 IP 首部校验和一致 |
| 标识符 | 16 | 标识每次 ping 进程 |
| 序列号 | 16 | 每发一个包加 1,用于配对 |
一对请求/应答靠什么确认是"一组"?标识符和序列号一致,Type 从 8 变成 0。另外,Windows 的 ping 会携带 32 字节测试数据(就是输出里的 abcdefghijklmnopqrstuvwabcdefghi)。
48.4 程序设计:ARP + ICMP 双协议架构
总体架构
相比 ARP 实验,本次只替换/新增了四个模块:
- ICMP 模块(icmp_rx + icmp_tx + crc32_d8):解析 ICMP 请求、组包应答;
- 以太网控制模块 eth_ctrl:ARP 应答和 ICMP 应答共用 GMII 发送口,靠它做协议切换;
- 同步 FIFO:缓存接收到的 ping 数据,等发送时再读出(收发同源时钟,所以同步 FIFO 就够)。
数据流转的完整链条:收到包 → ARP 和 ICMP 模块同时解析 → 是 ARP 请求就回 ARP 应答,是 ICMP 请求就把数据存进 FIFO 并回 ICMP 应答(数据从 FIFO 原样取出发回去)。
ICMP 接收模块:五层状态机
接收顺序:前导码 → 以太网帧头 → IP 首部 → ICMP 首部 → 有效数据。与 ARP 实验相同的设计决策:中间状态出错跳 st_rx_end 而不是 st_idle,等本包接收完(gmii_rx_dv=0)再复位,避免"半包数据"被误认成新前导码。
最有意思的是校验和数据部分的旁路累加——接收数据的同时就把校验和算出来了:
st_rx_data : begin
    if(gmii_rx_dv) begin
        rec_data <= gmii_rxd;
        rec_en   <= 1'b1;
        //判断接收到数据的奇偶个数
        if(icmp_rx_cnt == icmp_data_length - 16'd1) begin
            rec_pkt_done <= 1'b1;
            rec_byte_num <= icmp_data_length;
            if(icmp_data_length[0])          //奇数个数据
                reply_checksum_add <= {gmii_rxd,8'd0} + reply_checksum_add;
            else
                reply_checksum_add <= {icmp_rx_data_d0,gmii_rxd} + reply_checksum_add;
        end
        else if(icmp_rx_cnt < icmp_data_length) begin
            icmp_rx_data_d0 <= gmii_rxd;
            if(icmp_rx_cnt[0] == 1'b1)       //两个8位拼一个16位再累加
                reply_checksum_add <= {icmp_rx_data_d0,gmii_rxd} + reply_checksum_add;
        end
    end
end
校验和按 16 位一组累加,所以相邻两个 8 位数据要拼接后再加;数据个数为奇数时最后一个字节高位补零。收包完成时校验和也同时就绪,发送模块直接拿来复用——这是很巧妙的数据复用设计。
ICMP 发送模块:新增两个校验状态
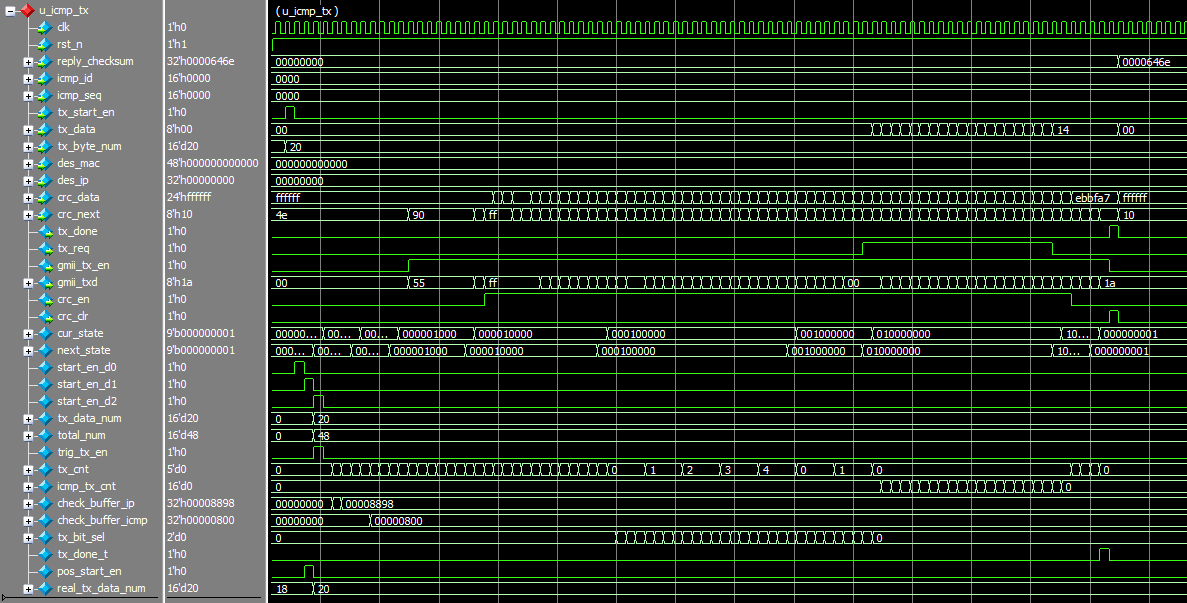
发送状态机在 ARP 版本的基础上多了两个状态:
- st_check_icmp:计算 ICMP 首部+数据的校验和;
- st_check_sum:计算 IP 首部校验和。
IP 首部用 5 个 32 位数组存放,发送前按本次包的实际参数重新初始化:
if(trig_tx_en) begin
    //对IP头部数组进行初始化
    ip_head[0]        <= {8'h45,8'h00,total_num};   //版本号:4 首部长度:5
    ip_head[1][31:16] <= ip_head[1][31:16] + 16'd1; //16位标识递增
    ip_head[1][15:0]  <= 16'h4000;                  //010表示不分片
    ip_head[2]        <= {8'h80,8'd01,16'h0000};    //TTL=128,协议=1(ICMP),校验和暂0
    ip_head[3]        <= BOARD_IP;                  //源IP地址
    if(des_ip != 32'd0)
        ip_head[4] <= des_ip;                       //目的IP地址
    //对ICMP头部数组进行初始化
    icmp_head[0] <= {ECHO_REPLY,8'h00,16'h0000};    //类型0=回显应答
    icmp_head[1] <= {icmp_id,icmp_seq};             //标识符/序列号原样返回
end
注意三个"原样返回":标识符、序列号、数据内容都直接回给电脑,这样电脑才能把 reply 和 request 配对。唯一变的是 Type:8 → 0。
ICMP 校验和的计算完全复刻手算三步曲:
st_check_icmp: begin
    if(tx_cnt == 5'd0) begin
        check_buffer_icmp <= icmp_head[0][31:16] + icmp_head[0][15:0] +
                             icmp_head[1][31:16] + icmp_head[1][15:0] +
                             reply_checksum;             //分组累加(含接收时算好的数据校验)
    end
    else if(tx_cnt == 5'd1)                              //折叠进位
        check_buffer_icmp <= check_buffer_icmp[31:16] + check_buffer_icmp[15:0];
    else if(tx_cnt == 5'd2)                              //可能再次进位,再折一次
        check_buffer_icmp <= check_buffer_icmp[31:16] + check_buffer_icmp[15:0];
    else if(tx_cnt == 5'd3) begin                        //按位取反
        icmp_head[0][15:0] <= ~check_buffer_icmp[15:0];
    end
end
以太网控制模块:一个寄存器搞定协议切换
核心就是一个 protocol_sw 开关信号:
assign gmii_tx_en = protocol_sw ? icmp_gmii_tx_en : arp_gmii_tx_en;
assign gmii_txd   = protocol_sw ? icmp_gmii_txd   : arp_gmii_txd;

if(icmp_tx_start_en)
    protocol_sw <= 1'b1;                              //ICMP优先
else if(arp_rx_flag && (icmp_tx_busy == 1'b0)) begin
    protocol_sw <= 1'b0;                              //ICMP空闲时才响应ARP
    arp_tx_en   <= 1'b1;
end
注意优先级设计:ICMP 请求先来就先处理;ARP 请求必须等 ICMP 发送完毕(icmp_tx_busy=0)才能切换。ARP 发送类型固定为应答(arp_tx_type=1'b1),因为本设计只回应别人的请求、不主动发请求。
顶层连线与仿真
顶层有两个"直通"连接值得品味:
assign tx_start_en = rec_pkt_done;  //收完一包ICMP请求,立刻启动发送应答
assign tx_byte_num = rec_byte_num;  //收多少字节,回多少字节
一个完整的 ping 应答,本质是"镜像":收到什么,原样发回去。仿真 TB 里依旧用环回法(gmii_rxd = gmii_txd),并把报文类型 defparam 改成 8'h08 模拟请求包,分别测了 20 字节和 28 字节两种数据长度。
48.5 下载验证
管脚分配与 ARP 实验完全相同。验证步骤充满仪式感:
- 电脑 IP 设为 192.168.1.102,网线接 GE_PL 网口,下载程序;
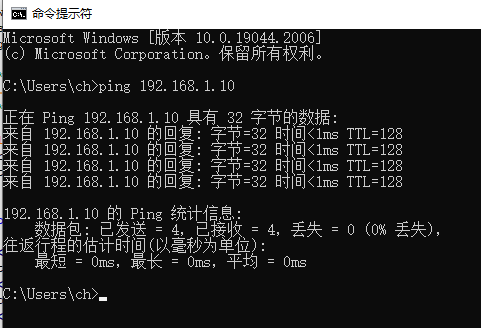
- 命令行执行
ping 192.168.1.10,看到回复即成功;
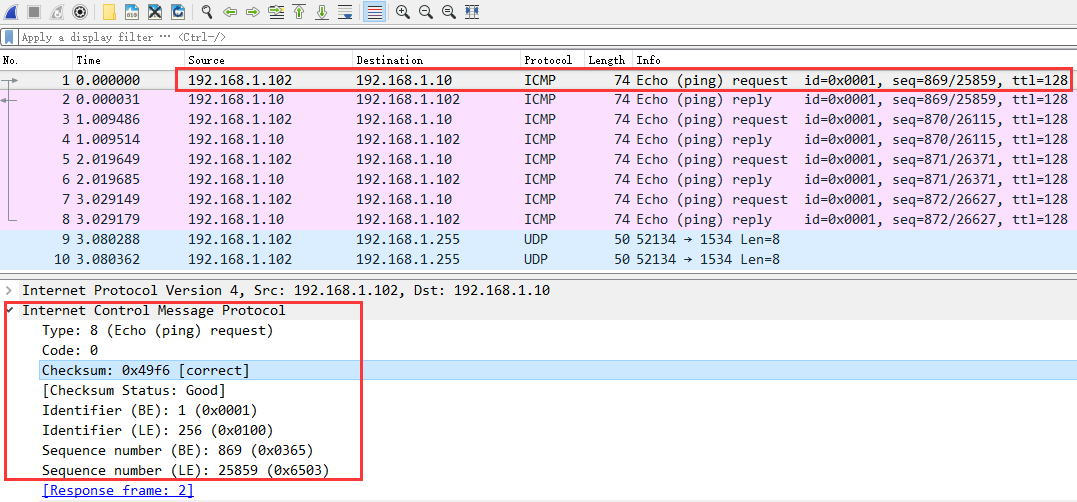
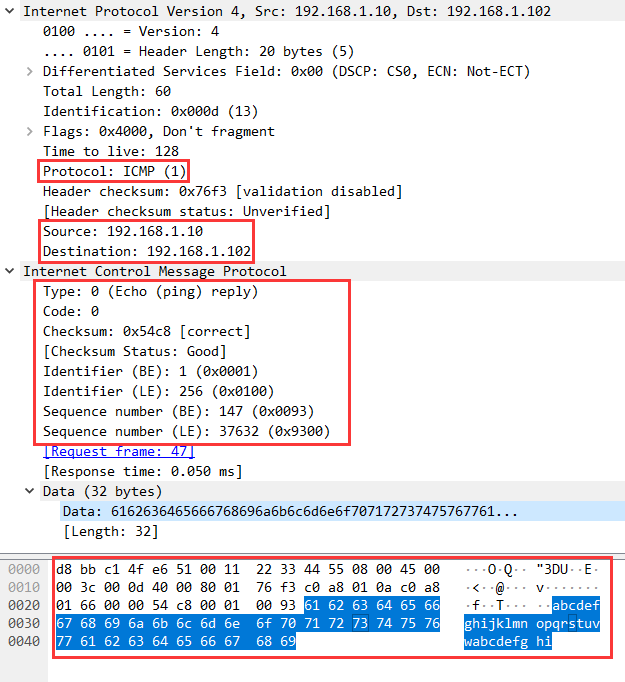
- 进阶玩法——用 Wireshark 抓包:第 47 行是电脑发的 ICMP 请求,第 48 行是开发板回的应答;点开应答包能看到源 IP 192.168.1.10、目的 IP 192.168.1.102,数据段正是那串 "abcdefghijklm nopqrstuvwabcdefghi"。
初学者容易踩的坑
- 校验和覆盖顺序:先算校验和(此时字段置 0),算完再填入首部数组,顺序反了结果必错。
- 奇数长度数据:校验和按 16 位累加,数据长度为奇数时最后一个字节要高位补零拼接,漏了这一步 ping 会"请求超时"。
- TTL/协议字段写死错值:协议字段必须是 1(ICMP),写成 17(UDP)电脑会当 UDP 包丢弃。
- 协议切换死锁:ARP 应答触发条件里没有判断
icmp_tx_busy的话,两个模块会同时往 GMII 总线送数据,发出垃圾包。 - Type 值不切换:应答包 Type 必须是 0,如果原样返回 8,电脑会认为这是又一个请求而不是应答。
- FIFO 时钟选择:虽然本实验收发同钟,但要清楚这是"侥幸"——换成千兆/百兆混合场景就必须用异步 FIFO。
小结 & 下一步
本章是以太网协议栈的重要一跃:
- 掌握 IP 首部 20 字节逐字段含义,以及"分组累加→折叠进位→取反"的校验和算法;
- 理解 ICMP 回显请求/应答的配对机制(标识符+序列号+镜像数据);
- 学会双协议共存的系统架构:协议解析并行、发送总线串行复用;
- 收包的同时旁路计算校验和,发送时直接复用,省去二次遍历。
至此开发板已经会"回答"了,但都是被动应答。下一章 UDP 测试实验,我们将实现主动、大批量的用户数据收发——这才是真正应用级通信的开端。