这一章在干嘛?
MATLAB = Matrix Laboratory,本章讲的就是它的灵魂:怎么创建向量(Vector)和矩阵(Matrix)、怎么访问和修改元素、怎么翻转变形,以及矩阵乘法与逐元素运算的区别。这一章学扎实,你就能理解为什么 MATLAB 写矩阵运算比 C 语言简洁十倍——后面所有章节都建立在它之上。
2.1 向量与矩阵:创建与索引
2.1.0 一切皆矩阵
MATLAB 里所有数据都按矩阵组织。一个 的矩阵就是 行 列的数值表;它还包涵几个特例:
- 标量(scalar):单个数,
- 列向量(column vector):,竖着排
- 行向量(row vector):,横着排
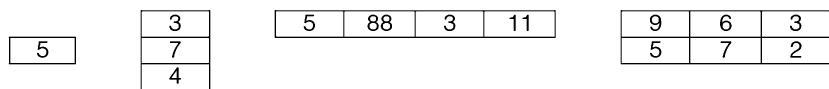 图 2.1:从左到右依次是标量(1×1)、列向量(3×1)、行向量(1×4)和矩阵(2×3)——标量和向量本质上都是矩阵的特例
所以严格说,MATLAB 里没有「单独的向量类型」,向量和标量只是特殊的矩阵。C 语言里的一维数组对应这里的向量,二维数组对应矩阵。矩阵里存的每个值叫元素(element)。
2.1.1 创建行向量
最直接的方法:把值放进方括号,用空格或逗号分隔:
>> v = [1 2 3 4]      % 空格分隔
v =
     1     2     3     4
>> v = [1,2,3,4] % 逗号分隔,结果完全一样但最常用的武器是冒号运算符(colon operator)——生成等差数列:
>> vec = 2:6          % 从 2 到 6,步长默认 1
vec =
     2     3     4     5     6
>> nv = 1:2:9         % 起始:步长:结束
nv =
1 3 5 7 9注意两个细节:步长超了上限就停(1:2:6 得 [1 3 5]);步长可以是负数,生成递减序列:9:-2:1 得 [9 7 5 3 1]。冒号运算符造出的向量用得极多,尤其是后面画函数图时:x = 0:0.1:2*pi; y = sin(x); 两行就画出一条正弦曲线——这在 C 里是一个完整的循环加一条绘图库调用。
练一练:只用冒号运算符,写出创建下列向量的表达式。
| 目标向量 | 答案 |
|---|---|
2 3 4 5 6 7 | 2:7 |
1.1 1.3 1.5 1.7 | 1.1:0.2:1.7 |
8 6 4 2 | 8:-2:2 |
-5 -4 -3 -2 -1 | -5:-1 |
步长不限于整数,0:0.2:1 这样的「小数步长」完全合法,画图时天天用。
指定元素个数而不是步长时,用 linspace:
>> ls = linspace(3, 15, 5)   % 3 到 15 之间均匀取 5 个点(含两端)
ls =
     3     6     9    12    15
linspace(x,y,n) 的 n 不写时默认 100 个点——画函数曲线时特别顺手。对数刻度的版本是 logspace(x,y,n),在 到 之间取 n 个点。
已有的向量还能拼接(concatenating)出新向量:
>> newvec = [nv ls]
newvec =
     1     3     5     7     9     3     6     9    12    15
2.1.2 引用与修改元素
向量的元素从 1 开始编号(不是 C 的 0!),编号叫**索引(index)**或下标(subscript)。用「变量名(索引)」访问:
>> newvec(5)          % 第 5 个元素
ans =
     9
>> b = newvec(4:6)    % 第 4~6 个元素,取出仍是向量
b =
     7     9     3
>> newvec([1 10 5])   % 索引不必连续!按 [1 10 5] 的顺序取
ans =
     1    15     9
[1 10 5] 这样的索引数组叫索引向量(index vector),可以任意乱序、重复取元素——这是 C 里要写循环才能干的事。
练一练:已知 vec = 3:3:12(即 [3 6 9 12]),下列表达式各得什么?
vec(2)→ 6vec([3 1])→[9 3](顺序按索引向量走)vec(2:3)→[6 9]vec(5)→ 报错:索引超出数组范围
从 C 语言数组过来的三个不同
- 下标从 1 开始,不是 0。
v(1)是第一个元素;v(0)直接报错。- 不检查会变报错:越界访问(如 5 个元素的向量取
v(6))在 C 里是未定义行为(可能悄悄读出垃圾值),在 MATLAB 里会明确报错「Index exceeds…」——烦人但救命。- 负数下标没有「倒数」语义:Python 的
v[-1]是最后一个元素,MATLAB 里负数下标直接报错,倒数要用end(见 2.1.5 节)。
修改元素直接赋值;甚至可以给尚不存在的索引赋值来扩展向量:
>> rv = [3 55 11];
>> rv(4) = 2
rv =
     3    55    11     2
>> rv(6) = 13         % 中间跳空的元素自动补 0
rv =
     3    55    11     2     0    13
为什么说「扩展向量」是坏习惯?
MATLAB 数组在内存中连续存放,每次加长都可能触发「重新分配内存 + 整体搬家」。在循环里反复扩展大向量,程序会明显变慢。好习惯是一次性分配好尺寸(如
zeros(1,n)),或用后面学的向量化写法。
2.1.3 创建列向量与矩阵
列向量用分号分隔元素:
>> c = [1; 2; 3; 4]
c =
     1
     2
     3
4冒号运算符造出来的是行向量,但任何行向量都能用转置运算符——单引号 '——变成列向量(行列互换):
>> r = 1:3;
>> c = r'
c =
     1
     2
     3
矩阵就是「行内用空格/逗号分隔、行间用分号分隔」:
>> mat = [4 3 1; 2 5 6]
mat =
     4     3     1
2 5 6行里也能嵌套冒号表达式;每行的元素个数必须相同,否则报错:
>> mat = [2:4; 3:5]        % 两行各 3 个元素
mat =
     2     3     4
     3     4     5
>> mat = [3 5 7; 1 2]
Error using vertcat
Dimensions of matrices being concatenated are not consistent.
随机矩阵和特殊矩阵用函数生成:
>> rand(2)              % 2×2 随机实数矩阵
>> rand(1,3)            % 1×3:先行数后列数
>> randi([5,10], 2, 3)  % 2×3 的随机整数矩阵,元素在 5~10
>> zeros(3)             % 3×3 全 0(方阵:一个参数行=列)
>> ones(2,4)            % 2×4 全 1
预分配内存的惯用法
zeros/ones除了造特殊矩阵,最重要的用途是预分配(preallocating):先造好目标尺寸的矩阵再往里填数,比一点点扩展快得多。MATLAB 只有 zeros 和 ones,没有 twos——想要全 10 的矩阵?ones(2,3)*10即可,这是下一节「标量运算」的伏笔。
2.1.4 矩阵的索引
矩阵元素用「行下标, 列下标」访问(永远行在前),这叫下标索引(subscripted indexing):
>> mat = [2:4; 3:5];
>> mat(2,3)           % 第 2 行第 3 列
ans =
     5
>> mat(1:2,2:3)       % 子块:第 1~2 行、第 2~3 列
ans =
     3     4
     4     5
>> mat(1,:)           % 第 1 行整行(: 代表"全部")
ans =
     2     3     4
>> mat(:,2)           % 第 2 列整列
ans =
     3
     4
单独一个冒号「取整行 / 整列」是日常最高频操作,务必形成肌肉记忆。
如果只给一个索引,MATLAB 会按列优先顺序(column major order)把矩阵拉直——先数完第 1 列再数第 2 列,这叫线性索引(linear indexing):
>> intmat = [100 77; 28 14]
intmat =
   100    77
    28    14
>> intmat(1)      % 第 1 列第 1 个
ans =
   100
>> intmat(2)      % 第 1 列第 2 个
ans =
    28
>> intmat(3)      % 第 1 列数完,才轮到第 2 列第 1 个
ans =
    77
为什么是列优先?因为 MATLAB 内部就是按列连续存储矩阵的(这继承自老牌数值计算语言 Fortran,而 C 是按行存)。知道这一点,你就明白为什么 sum、max 这些函数也默认按列处理——语言的设计一以贯之。
能用,但可读性差、易出错,实际写代码请坚持用行列下标。
修改与扩展:
>> mat(1,2) = 11        % 改单个元素
>> mat(2,:) = 5:7       % 整行替换(长度必须匹配)
>> m(2:3,3:5) = 3       % 标量可以"广播"到任意子块
>> mat(:,4) = [9 2]'    % 追加一整列 → 矩阵变宽
>> mat(4,:) = 2:2:8 % 追加一整行,中间跳空的行补 0注意:矩阵不能只加单个元素(行会不齐),只能整行整列地加。
2.1.5 尺寸:length、size、numel 与 end
| 函数 | 返回 |
|---|---|
length(v) | 向量元素个数;矩阵则取行数与列数中较大者 |
size(mat) | [行数 列数];可用两个变量分别接住 |
numel(mat) | 元素总数(行 × 列) |
>> vec = -2:1;
>> length(vec)
ans =
     4
>> mat = [1:3; 5:7]';   % 转置成 3×2
>> [r, c] = size(mat)   % 一次返回两个值,用"变量向量"接住!
r =
     3
c =
     2
>> numel(mat)
ans =
     6
[r, c] = size(mat) 展示了 MATLAB 两个独门绝技:函数可以一次返回多个值,赋值号左边可以放变量列表。C 语言里要靠指针参数才能做到的事,这里一行搞定。
想造一个「和 mat 同尺寸的全零矩阵」?把函数嵌起来:zeros(size(mat))——size 的返回值直接喂给 zeros,不用中间变量。这种**嵌套调用(nesting calls)**是 MATLAB 的常见风格:函数返回的值可以直接当另一个函数的参数。
关键字 end 指代「最后一个」索引,免去查询尺寸:
>> mat = [1 4; 2 5; 3 6];
>> mat(end,1)     % 最后一行第 1 列 → 3
>> mat(2,end)     % 第 2 行最后一列 → 5
>> vec = 9:-2:1;
>> vec(end)       % 向量的最后一个元素 → 1
end 还能参与算术:vec(end-1) 是倒数第二个元素。注意 end 只能当下标用,出现在别处会报错。
练一练:对 mat = [1 2 3; 4 5 6](2×3),以下各取到什么?
mat(2,3)→ 6mat(1,:)→[1 2 3](整个第 1 行)mat(:,end)→[3; 6](整个最后一列)mat(3)→ 2(线性索引按列数:第 1 列是 1、4,第 2 列开头是 2)numel(mat)→ 6
常见坑:别把尺寸写死
初学者爱写
vec(10)、循环for i = 1:10。一旦数据变成 20 个元素就全崩。通用写法:向量长度用length(vec)或numel(vec),矩阵用[r,c] = size(mat),末尾元素用end。让代码对任意尺寸都成立,是编程风格指南反复强调的原则。
2.1.6 改变形状:reshape / flip / rot90 / repmat
这组函数只改变「元素的摆放方式」,不改变元素本身:
>> mat = randi(100, 3, 4)   % 3×4,共 12 个元素
>> reshape(mat, 2, 6)       % 变成 2×6,按列优先重排
>> fliplr(mat)              % 左右翻转(列序颠倒)
>> flipud(mat)              % 上下翻转(行序颠倒)
>> rot90(mat)               % 逆时针旋转 90°
>> rot90(mat, 2)            % 旋转 180°(第二个参数是 90° 的倍数)
>> rot90(mat, -1)           % 负数 = 顺时针
reshape 按列优先顺序重排:原第 1 列的元素先填进新矩阵,再填第 2 列……
>> mat = randi(100, 3, 4)
mat =
    14    61     2    94
    21    28    75    47
    20    20    45    42
>> reshape(mat, 2, 6)     % 12 个元素重排成 2×6
ans =
    14    20    28     2    45    47
    21    61    20    75    94    42
对照着看:新矩阵第 1 列的 14、21 正是原矩阵第 1 列的前两个,20 被顺延——列优先顺序「流」进新形状。只要元素总数一致,3×4 可以重排成 2×6、6×2、4×3、1×12、12×1 任意形状。另外注意 reshape(mat,2,6) 不改变 mat 本身,只返回新矩阵;想保存结果要写 mat = reshape(mat,2,6)。
另外还有两个「复制粘贴」函数,注意区分:
repmat(mat, m, n):把整个 mat 当积木,平铺成 块;repelem(mat, m, n):把每个元素各自复制 遍。
>> intmat = [50 34; 96 59];
>> repmat(intmat,2,2)     % 4×4:[intmat intmat; intmat intmat]
>> repelem(intmat,2,2)    % 4×4:每个数都变成 2×2 的小方块
2.1.7 空向量:删除元素的钥匙
[] 是空向量(empty vector),长度为 0。它有个妙用——删除元素:
>> vec = 4:8;
>> vec(3) = []          % 删掉第 3 个元素
vec =
     4     5     7     8
>> vec = 3:10;
>> vec(2:4) = []        % 一次删一段
vec =
3 7 8 9 10矩阵则只能整行整列地删(mat(:,2) = [] 删第 2 列),单个元素删了行就不齐,会报错。
空向量也能从零攒出一个向量:evec = []; evec = [evec 4]; evec = [evec 11];……能跑,但效率低,能免则免。
三维矩阵是怎么回事?
MATLAB 矩阵不限于二维。把每个二维矩阵想成一「页」,三维矩阵就是一叠页,索引多一维:
mat(:,:,1) = 第一页; mat(:,:,2) = 第二页;,size会返回三个数。zeros(2,4,3)直接造 的三维矩阵。处理彩色图像(第 13 章)时 RGB 三个通道就是这么存的。
看一个真实的构建过程:先用 reshape 造两页 3×5 的矩阵,再把它们摞成一叠:
>> layerone = reshape(1:15,3,5)
layerone =
     1     4     7    10    13
     2     5     8    11    14
     3     6     9    12    15
>> layertwo = fliplr(flipud(layerone))   % 旋转 180° 作为第二页
>> mat(:,:,1) = layerone;
>> mat(:,:,2) = layertwo;
>> size(mat)
ans =
     3     5     2
三个下标依次是行、列、页。日常计算 99% 的时间在二维世界,三维矩阵知道「存在、怎么建、size 返回三个数」即可,等学到图像处理再深入。
2.2 把向量矩阵喂给函数
MATLAB 的函数天然「吃」整个数组:传进去一个向量,它对每个元素逐一处理,返回同尺寸的结果——这就是别的语言里要写循环才实现的「遍历」:
>> vec = -2:1;
>> abs(vec)          % 对每个元素取绝对值
ans =
     2     1     0     1
>> sign([0 4 -3; -1 0 2])   % 矩阵同理
ans =
     0     1    -1
-1 0 1另一类函数「压缩」整个向量成一个数:min、max、sum、prod:
>> vec1 = 1:5;
>> sum(vec1)         % 1+2+3+4+5
ans =
    15
>> prod([3 5 8 2])   % 3×5×8×2
ans =
   240
>> min([3 5 8 2])    % 最小值 → 3
>> max([3 5 8 2]) % 最大值 → 8「累计版」cumsum / cumprod 则保留每一步的中间结果,结果和输入同长度——「running sum(滚动和)」:
>> cumsum(1:5)       % 1, 1+2, 1+2+3, ...
ans =
     1     3     6    10    15
>> cumprod(1:5)      % 1, 1×2, 1×2×3, ...
ans =
     1     2     6    24   120
cumsum 的最后一个元素永远等于 sum 的结果——这个性质可以用来互相验证。R2014b 之后这些累计函数还支持 'reverse' 选项(从尾往前累计)以及 cummin / cummax 变体。
diff 函数算相邻元素的差,结果比原向量短 1(对矩阵同样按列):
>> diff([4 7 15 32])
ans =
     3     8    17
>> diff([4 7 2 32])
ans =
     3    -5    30