这一章在干嘛?
这是本书的「工具箱章节」——把工程师日常会碰到的数学问题(统计、集合、多项式、复数、线性方程组、符号运算、积分微分)一次性铺开。学完你就能用 MATLAB 跑数据拟合、解电路节点方程、画 RC 电路响应、做数值积分,给老板/导师交差。
14.1 统计函数
工程里拿到的数据十有八九是带噪声的,「这一批数大概是什么、波动有多大、有没有异常点」就是统计函数要回答的问题。
14.1.1 一行命令看全家:`max
max 和 min 是最朴素的统计函数。它们也返回极值的索引(多个极值时返回第一个):
>> x = [9 10 10 9 8 7 3 10 9 8 5 10];
>> [maxval, maxind] = max(x)
maxval = 10
maxind = 2                % 第一个 10 的位置,不是最后一个
矩阵按列操作,要按行请加第二个参数(dim = 2):
>> mat = [8 9 3; 10 2 3; 6 10 9];
>> mean(mat)              % 默认按列:每列的均值
ans = 8.0000  7.0000  5.0000
>> mean(mat, 2)           % 按行:每行的均值
ans = 6.6667
     5.0000
     8.3333
14.1.2 均值家族
算术平均(arithmetic mean,平常说的「平均」):
>> mean([9 10 10 9 8 7 3 10 9 8 5 10])
ans = 8.1667异常点(outlier)会拉偏均值。下面这组数除了中间那个 100 都在 3~10 之间,但均值被拉到 15.23,比任何「正常」值都大:
>> xwithbig = [9 10 10 9 8 100 7 3 10 9 8 5 10];
>> mean(xwithbig)
ans = 15.2308工程里遇到这种情况,常见做法是先去掉最大最小值再求平均:
>> clean = xwithbig(xwithbig ~= min(xwithbig) & xwithbig ~= max(xwithbig));
>> mean(clean)
ans = 8.5455调和平均(harmonic mean)和几何平均(geometric mean)用得少但在特定领域很有用 —— 调和平均适合「速率平均」(比如数据下载速率),几何平均适合「增长率平均」(比如投资年化收益):
>> x = [9 10 10 9 8 7 3 10 9 8 5 10];
>> harmhand = @(x) length(x) / sum(1./x);
>> harmhand(x)
ans = 7.2310
>> geomhand = @(x) nthroot(prod(x), length(x));
>> geomhand(x)
ans = 7.7775
14.1.3 方差与标准差:数据「散」到什么程度
方差(variance)刻画数据围绕均值的离散程度:
>> x = [8 7 5 4 6];
>> var(x)
ans = 2.5000
标准差(standard deviation)就是方差的平方根:
>> std(x)
ans = 1.5811 % = sqrt(2.5)下面两组数据均值相同(都是 9.5)但离散度天差地别:
>> x1 = [9 10 9.4 9.6]; std(x1)            % 紧凑数据
ans = 0.4163
>> x2 = [2 17 -1.5 20.5]; std(x2)          % 跳跃数据
ans = 10.8704
工程实战:质量控制
如果你是产线工程师,两台设备测得同一直径 16 mm 工件,第一台 std = 0.02 mm(精度高),第二台 std = 0.5 mm(精度差)——只看均值无法判断设备好坏,必须配合标准差看离散度。
14.1.4 众数与中位数
众数(mode)= 出现次数最多的值;多个并列时取最小的那个:
>> mode([9 10 10 9 8 7 3 10 9 8 5 10])
ans = 10 % 出现了 4 次中位数(median)= 排序后中间那个值(奇数长)或中间两个的平均(偶数长):
>> median([1 4 5 9 12])    % 5 个数中间 = 第 3 个
ans = 5
>> median([1 4 5 9 12 33]) % 6 个数中间 = 第 3、4 个的平均 = (5+9)/2
ans = 7
常见坑:均值 vs 中位数在偏态分布上的差异
数据有异常值时,中位数比均值鲁棒得多。例:「大多数员工月薪 1 万,老板月薪 100 万,公司平均月薪 ≈ 9 万」——这种时候报中位数比报均值更反映「真实」水平。
14.2 集合运算
把两个向量当作两个集合做运算 —— 工程师常常要回答「两组传感器的告警 ID 里哪些是共同的」「A 班和 B 班的零件编号有哪些不同」这类问题。
>> v1 = 6:-1:2            % v1 = [6 5 4 3 2]
>> v2 = 1:2:7 % v2 = [1 3 5 7]| 函数 | 含义 | 例子 |
|---|---|---|
union(a, b) | 并并 | [1 2 3 4 5 6 7] |
intersect(a, b) | 交并 | [3 5] |
setdiff(a, b) | 差并(a 中去掉 b) | [2 4 6] |
setxor(a, b) | 对称差(只在 a 或只在 b) | [1 2 4 6 7] |
unique(v) | 去重 | [1 2 3 4 5 6] |
ismember(a, b) | 逻辑向量,a 的每个元素是否在 b 中 | [0 1 0 1 0] |
issorted(v) | 是否升序排列 | 0 或 1 |
R2013a 之前返回结果默认升序;之后用 'stable' 保留原始顺序:
>> union(v1, v2, 'stable')
ans = 6  5  4  3  2  1  7   % 先按 v1 的顺序,最后是 v2 中独有的
intersect 还支持返回索引向量,索引回原向量能拿到原始值:
>> [out, i1, i2] = intersect(v1, v2);
>> v1(i1)               % 与 v2 共同的元素在 v1 中的位置
ans = 3  5
用法建议
想做「A 班学生集合有没有完全包含 B 班」这种判定,组合两个
ismember比手写循环干净得多:all(ismember(B, A)) % B 中所有元素都在 A 中吗?
14.3 多项式、曲线拟合与插值
「数据是采样得到的散点,但我想知道任意时刻的值是多少」—— 这是工程里最常见的数学问题。多项式拟合 + 插值就是答案。
14.3.1 多项式表示法
MATLAB 用系数向量(按降幂排列)表示多项式:
>> p = [1 2 -4 3] % 代表 x^3 + 2x^2 - 4x + 3两个核心函数:
roots(p):求多项式等于 0 的根polyval(p, x):把多项式在 x 处求值
>> roots([4 -2 -8 3])        % 解 4x^3 - 2x^2 - 8x + 3 = 0
ans =
   -1.3660
    1.5000
    0.3660
>> polyval([-2 1 4], 3)      % 求 -2x^2 + x + 4 在 x=3 的值
ans = -11                    % = -2*9 + 3 + 4
常见坑:缺失项要补 0
没有 项和 项,要写成
[2 0 -1 0 5]。少一个 0,阶数就错了。
14.3.2 曲线拟合:polyfit + polyval
温度采样案例(工程实例):一个下午每整点测一次温度,5 个采样点用直线(1阶)来拟合,效果是几乎平的横线 —— 因为这条线代表「下午整体趋势」,没有反映 4 点钟的高温:
>> x = 2:6;                             % 2~6 点钟
>> y = [65 67 72 71 63];                % 对应温度
>> polyfit(x, y, 1)                     % 拟合 1 阶(直线)
ans = 0.0000  67.6000                  % y ≈ 67.6 的水平线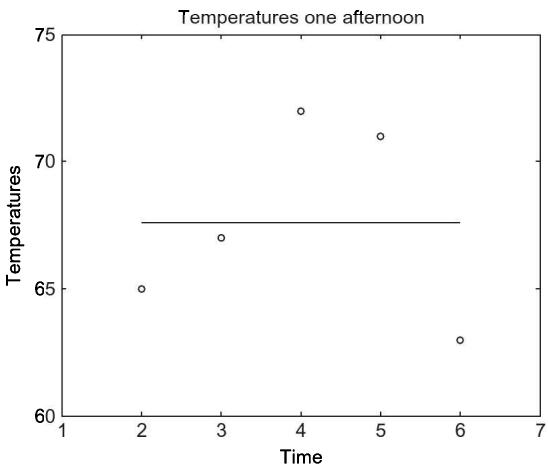
换成 2 阶(二次曲线)效果立刻好了:
>> coeffs = polyfit(x, y, 2)            % 拟合 2 阶(抛物线)
coeffs = -1.8571  14.8571  41.6000
>> curve = polyval(coeffs, x);          % 在每个 x 处求拟合曲线值
>> plot(x, y, 'ro', x, curve); xlabel('Time'); ylabel('Temp');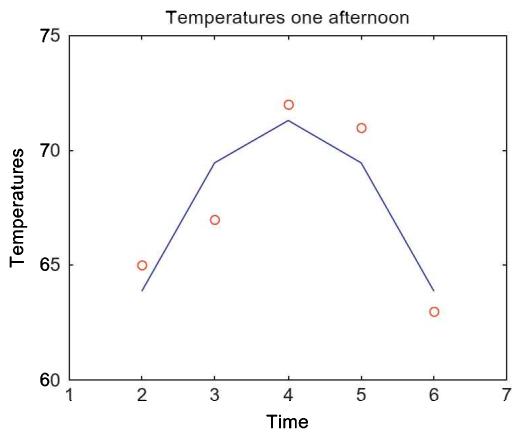
工程版(画得更密更平滑):拿一个含 100 点的细网格 linspace(2,6,100) 来画曲线,数据点保持原来的 5 个:
% polytemp.m
x  = 2:6;
y  = [65 67 72 71 63];
coefs = polyfit(x, y, 2);
morex = linspace(min(x), max(x), 100);   % 100 个密集采样点画曲线
plot(x, y, 'ro', morex, polyval(coefs, morex));
xlabel('Time'); ylabel('Temp'); axis([1 7 60 75]);
title('Temperatures one afternoon');
14.3.3 阶数对比:欠拟合、过拟合与「刚刚好」
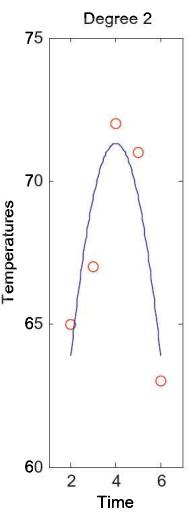
阶数太低 → 模型太朴素(欠拟合);阶数太高 → 模型把噪声也学进去了(过拟合)。下面把 1、2、3 阶并列画出来,对比就一目了然:
% polytempsubplot.m
x = 2:6;
y = [65 67 72 71 63];
morex = linspace(min(x), max(x));
for pd = 1:3
    coefs = polyfit(x, y, pd);
    curve = polyval(coefs, morex);
    subplot(1,3,pd);
    plot(x, y, 'ro', morex, curve);
    title(sprintf('Degree %d', pd));
    axis([1 7 60 75]);
end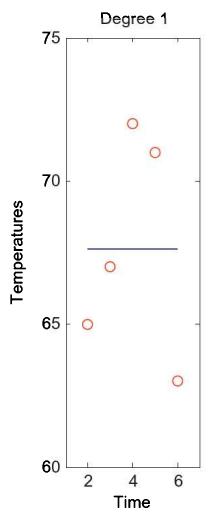
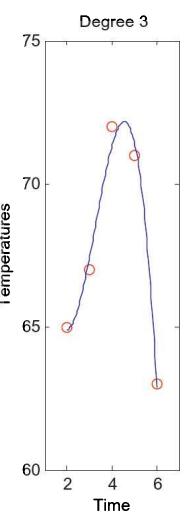
14.3.4 插值与外推
插值(interpolation):求采样点之间的值。外推(extrapolation):求采样点之外的值。
>> polyval(coeffs, 2.5)       % 插值:2:30 时的温度
ans = 67.1357
>> polyval(coeffs, 1.0)       % 外推:1:00 时的温度
ans = 54.6000                 % ⚠️ 外推不可靠,离样本越远越不准
常见坑:外推危险
用一个二次曲线去预测「明天的温度」,相当于让模型在完全没有数据约束的区域发疯。永远把外推视为「仅供参考」,真要做预测用线性回归 + 置信区间或时间序列模型。
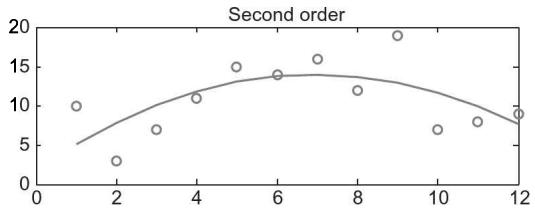
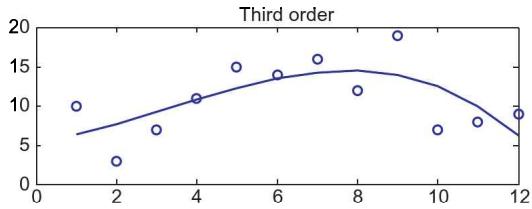
14.3.5 工程实例:噪声数据的二次/三次拟合对比
下面两个图是 12 个随机采样点的二阶和三阶拟合曲线对比。点数多时,二阶已经能很好地反映整体趋势;三阶开始把噪声也拟合进去。
14.4 复数
电子工程师绕不开复数 —— 交流电路里的阻抗、信号处理里的频域、控制理论里的传递函数,全都是复数。MATLAB 里 i 和 j 都是内置的 。
常见坑:循环变量
i覆盖虚数单位>> for i = 1:5; end >> 3*i % 这时 i=6,结果是 18,不再是复数永远用
1i或1j(永远返回复数 0+1.0000i),不要图省事只用i/j。
14.4.1 复数创建与基本运算
>> z1 = 4 + 2i              % 标准写法
>> z2 = sqrt(-5)            % MATLAB 自动返回纯虚数
z2 = 0.0000 + 2.2361i
>> z3 = complex(3, -3)      % 用函数构造
>> z4 = 2 + 3j              % 工程习惯写法,结果与 2+3i 相同
实部、虚部、共轭、模长:
>> real(z1), imag(z1)       % 实部、虚部
ans = 4
ans = 2
>> conj(z1)                 % 共轭:a - bi
ans = 4.0000 - 2.0000i
>> abs(z1)                  % 模长:sqrt(a^2 + b^2)
ans = 4.4721打印陷阱:fprintf('%f\n', z1) 默认只打实部,不会出错但丢一半信息。要打完整得:
>> fprintf('%f + %fi\n', real(z1), imag(z1))
4.000000 + 2.000000i