 图 1:第 9 章章首插图
这一篇在干嘛?
前一章讲了内核自己怎么分配内存,这一章讲内核怎么给用户态进程分配内存。核心思路是”能拖就拖”:进程要内存时先只给它一段线性地址区间(内存区域),真正的物理页框等到访问那一刻发生缺页异常了才分配。理解这套机制,你才能看懂 malloc、mmap、fork 到底做了什么,以及”段错误”是怎么被内核判定的。
引言:进程地址空间 | 内存描述符 | 内存区域 | 数据结构与访问权限 | 查找与分配线性地址区间 | 释放线性地址区间 | 缺页异常处理程序 | 请求调页与写时复制 | 地址空间的创建销毁与堆管理
引言:进程地址空间
先对比一下内核和用户态分配内存的处境有多不同。
内核函数要动态内存很直接:__get_free_pages()、kmalloc()、vmalloc() 要多少给多少。这行得通有两个原因:内核是系统中优先级最高的组件,它请求内存一定有充分理由,没必要推迟;内核信任自己,假定所有内核函数都没有编程错误,不需要防着谁。
用户态进程就完全两码事了:
- 进程申请内存不紧急。程序被加载时不代表马上要用到所有代码页;调用
malloc()也不代表马上会访问拿到的全部内存。所以内核的总原则是:尽量推迟给用户进程分配动态内存。 - 用户程序不可信任。内核必须能捕获用户态进程造成的所有寻址错误。
内核靠什么实现”推迟”?答案是引入一种新资源:当用户态进程申请动态内存时,它得到的不是页框,而是使用一段新线性地址区间的权利——这段区间成为进程地址空间的一部分,被称为”内存区域”(memory region)。等进程真正访问这段地址、触发缺页异常时,内核才把物理页框补上(也就是第 2 章提过的请求调页思想)。
进程的地址空间(address space)就是该进程允许使用的全部线性地址的集合。每个进程看到的线性地址互不相干,内核还可以随时往地址空间里增删地址区间。典型情况下,进程在以下时机获得新的内存区域:
- 在控制台敲一条命令,shell 创建新进程执行它,新进程得到一整套全新的地址空间;
- 运行中的进程调用
execve装载完全不同的程序:进程 ID 不变,但旧内存区域全部释放,换上新的一套; - 进程对文件做”内存映射”(
mmap),内核给它一个新内存区域来映射该文件; - 进程不断往用户态栈压数据,把栈对应的内存区域用满了,内核可能扩大这个区域;
- 进程创建 IPC 共享内存区与其他进程共享数据;
- 进程通过
malloc()扩充堆(heap),内核可能扩大堆对应的内存区域。
与之相关的系统调用汇总如下:
| 系统调用 | 说明 |
|---|---|
brk() | 改变进程堆的大小 |
execve() | 装载新的可执行文件,从而改变进程地址空间 |
_exit() | 终止当前进程并销毁其地址空间 |
fork() | 创建新进程,因而创建新地址空间 |
mmap(), mmap2() | 为文件创建内存映射,扩大进程地址空间 |
mremap() | 扩大或缩小一个内存区域 |
remap_file_pages() | 为文件创建非线性映射 |
munmap() | 销毁文件的内存映射,收缩进程地址空间 |
shmat() | 挂接共享内存区 |
shmdt() | 分离共享内存区 |
为什么内核必须精确掌握进程拥有哪些内存区域?因为缺页异常处理程序要靠它区分两类引发异常的地址:
- 编程错误造成的非法地址——比如野指针,要给进程发 SIGSEGV;
- 缺页造成的地址——地址确实属于进程地址空间,只是对应页框还没分配。这类”缺页”在进程看来完全合法,内核补上页框让进程继续跑即可,这正是请求调页(demand paging)的实现基础。
内存区域有两个硬性约定:起始地址和长度都必须是 4096 的倍数,这样区域标识的数据恰好填满分配给它的页框。
内存描述符
进程地址空间的全部信息都装在一个 mm_struct 类型的对象里,叫内存描述符,由进程描述符的 mm 字段引用。主要字段如下:
| 类型 | 字段 | 说明 |
|---|---|---|
vm_area_struct * | mmap | 内存区域对象链表的头指针 |
struct rb_root | mm_rb | 内存区域对象红黑树的根 |
vm_area_struct * | mmap_cache | 最后一次引用的内存区域对象 |
unsigned long (*)( ) | get_unmapped_area | 在地址空间中查找空闲线性地址区间的方法 |
void (*)( ) | unmap_area | 释放线性地址区间时调用的方法 |
unsigned long | mmap_base | 第一个分配的匿名内存区域或文件映射的线性地址 |
unsigned long | free_area_cache | 内核查找空闲地址区间的起始搜索地址 |
pgd_t * | pgd | 指向页全局目录 |
atomic_t | mm_users | 次使用计数器 |
atomic_t | mm_count | 主使用计数器 |
int | map_count | 内存区域的数目 |
rw_semaphore | mmap_sem | 内存区域的读/写信号量 |
spinlock_t | page_table_lock | 保护内存区域和页表的自旋锁 |
struct list_head | mmlist | 内存描述符链表中相邻元素的指针 |
unsigned long | start_code / end_code | 可执行代码的起始/结束地址 |
unsigned long | start_data / end_data | 初始化数据的起始/结束地址 |
unsigned long | start_brk / brk | 堆的起始/当前结束地址 |
unsigned long | start_stack | 用户态栈的起始地址 |
unsigned long | arg_start / arg_end | 命令行参数的起始/结束地址 |
unsigned long | env_start / env_end | 环境变量的起始/结束地址 |
unsigned long | total_vm / locked_vm / rss | 区域总页数/锁定页数/驻留内存页数 |
所有内存描述符挂在一个双向链表上(mmlist 字段),链表首元素是进程 0(init_mm)的 mmlist 字段,多处理器系统上由 mmlist_lock 自旋锁保护。
两个计数器的区别是本节最容易混淆的地方:
mm_users:统计共享该内存描述符的轻量级进程数;mm_count:内存描述符的主使用计数,所有mm_users里的”用户”合计只算 1 个单位。mm_count减到 0 时描述符才被释放。
举例:两个轻量级进程共享一个内存描述符,mm_users 为 2,mm_count 为 1。如果这个描述符暂时借给内核线程用,内核递增的是 mm_count——这样即使两个轻量级进程都死了(mm_users 归零),描述符也不会被释放,因为 mm_count 还大于 0。反过来,如果内核想在一段较长操作中确保描述符不被释放,就递增 mm_users(比如第 17 章的 try_to_unuse()),效果一样但语义不同。
获取新内存描述符用 mm_alloc():因为描述符放在 slab 分配器高速缓存里,它调用 kmem_cache_alloc(),初始化后把 mm_count 和 mm_users 都置 1。释放路径则分两级:mmput() 递减 mm_users,减到 0 时释放局部描述符表、内存区域描述符和页表,再调 mmdrop();mmdrop() 递减 mm_count,减到 0 才真正释放 mm_struct。
内核线程怎么办?
内核线程只在内核态运行,从不访问低于 TASK_SIZE(即 PAGE_OFFSET,通常 0xc0000000)的线性地址,所以它不需要内存区域,内存描述符的大多数字段对它毫无意义。
但页表中 TASK_SIZE 以上(内核空间)的映射对所有进程都应该一致,内核线程用哪套页表其实无所谓。为了避免无谓的 TLB 和高速缓存刷新,Linux 让内核线程直接沿用上一个普通进程的页表。为此每个进程描述符有两个指针:
mm:指向进程拥有的内存描述符;active_mm:进程运行时实际使用的内存描述符。
普通进程两者相同;内核线程的 mm 永远是 NULL,被调度执行时其 active_mm 被初始化为上一个运行进程的 active_mm。
还有一个小麻烦:内核态修改了高地址(TASK_SIZE 以上)的页表项(典型如 vmalloc()),理论上应同步到全系统所有进程的页表里。逐个改太贵,Linux 采取延迟策略:只更新以 swapper_pg_dir 为主页全局目录的”规范”页表集(存在 init_mm 变量里),等某个进程真正访问对应地址缺页时,再由缺页处理程序把规范页表项抄过去(见缺页异常处理程序一节的 vmalloc_fault 分支,背景见第 8 章)。
内存区域
Linux 用 vm_area_struct 对象实现一个内存区域,字段如下:
| 类型 | 字段 | 说明 |
|---|---|---|
struct mm_struct * | vm_mm | 指向拥有该区域的内存描述符 |
unsigned long | vm_start | 区域内的第一个线性地址 |
unsigned long | vm_end | 区域外的第一个线性地址 |
struct vm_area_struct * | vm_next | 进程区域链表中的下一个区域 |
pgprot_t | vm_page_prot | 区域页框的访问权限 |
unsigned long | vm_flags | 区域的标志 |
struct rb_node | vm_rb | 红黑树的数据(颜色、父子指针) |
union | shared | 用于反向映射的数据结构链 |
struct list_head | anon_vma_node | 匿名内存区域链表的指针 |
struct anon_vma * | anon_vma | 指向 anon_vma 结构 |
struct vm_operations_struct* | vm_ops | 内存区域的方法 |
unsigned long | vm_pgoff | 被映射文件中的偏移 |
struct file * | vm_file | 被映射文件的文件对象,匿名区为 NULL |
void * | vm_private_data | 区域的私有数据 |
unsigned long | vm_truncate_count | 非线性文件映射中释放地址区间时使用 |
vm_end – vm_start 就是区域长度。同一进程的内存区域永不重叠;新区域紧挨着旧区域且访问权限相同时,内核会尽量合并它们。
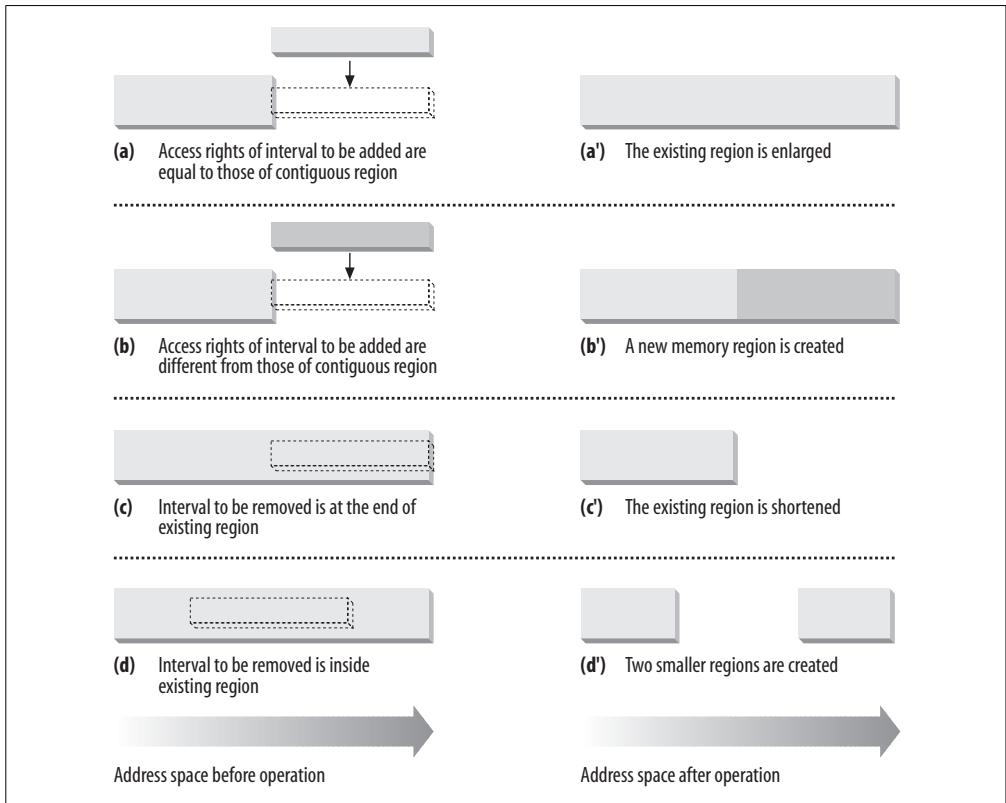 图 2:向进程地址空间添加或删除一个线性地址区间(原书图 9-1)
如图 2 所示,往地址空间加入一段新地址时,内核先看能否扩大既有区域(情形 a),不行才新建区域(情形 b);删除一段地址时,内核调整受影响区域的大小(情形 c),必要时一个区域会被分裂成两个小区域(情形 d)。
vm_ops 字段指向 vm_operations_struct,存放内存区域的方法。对 UMA 系统只有四个方法:
| 方法 | 说明 |
|---|---|
open | 内存区域被加入进程的区域集合时调用 |
close | 内存区域被移出进程的区域集合时调用 |
nopage | 进程访问的页不在 RAM 但地址属于该区域时,由缺页异常处理程序调用 |
populate | 为区域的线性地址预填页表项(prefaulting),主要用于非线性文件映射 |
数据结构与访问权限
链表 + 红黑树:一对搭档
一个进程的所有内存区域按地址升序串成单链表(vm_next 串联),头是内存描述符的 mmap 字段。相邻区域之间可以有未使用的地址空洞。map_count 记录区域数,默认上限 65536 个,管理员可通过 /proc/sys/vm/max_map_count 调整。
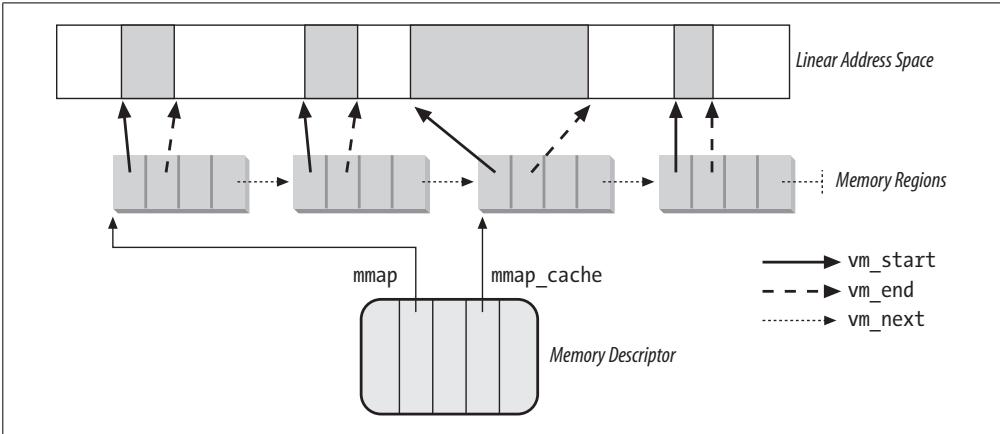 图 3:与进程地址空间相关的各描述符之间的关系(原书图 9-2)
只用链表有个问题:查找、插入、删除的耗时都与链表长度成正比。绝大多数进程的区域不多(几十个以内),无所谓;但面向对象数据库、malloc 调试器这类应用可能持有成百上千个区域,链表性能会崩掉。
所以 Linux 2.6 同时把区域放进红黑树(首树根是 mm_rb 字段,每个区域的红黑树数据在 vm_rb 字段)。红黑树里每个节点最多两个孩子,节点按键值排序:左子树的所有元素都小于 N,右子树都大于 N(图 4a)。此外还必须满足四条规则:
- 每个节点要么红色要么黑色;
- 树根必须是黑色;
- 红节点的孩子必须是黑色;
- 从任一节点到其后代叶子的每条路径,包含的黑节点数必须相同(空指针也算黑节点)。
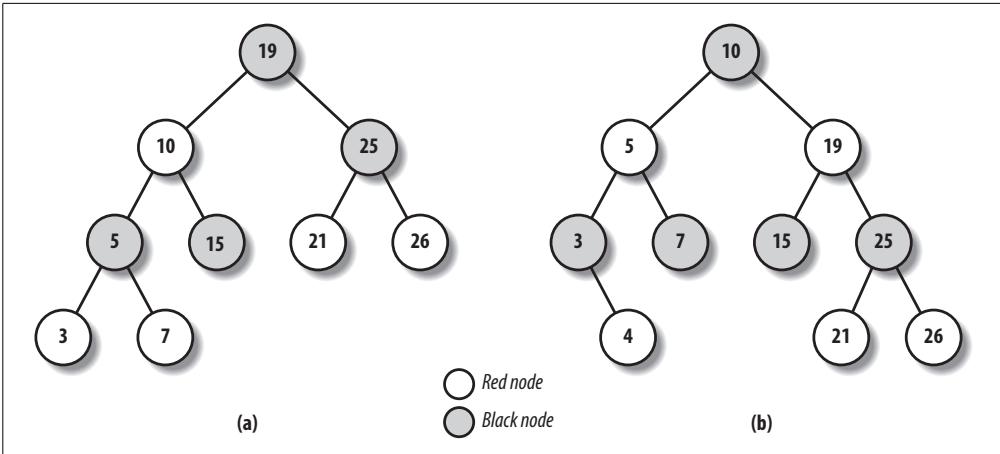 图 4:红黑树示例(原书图 9-3)
这四条规则保证 n 个内部节点的红黑树高度最多约 2×log(n)+1,查找、插入、删除的耗时都与树大小的对数成正比——区域数翻倍只多一次迭代。插入新节点时先作为红色叶子插入,若破坏规则就调整颜色或”旋转”子树(如图 4 中插入 4 的过程:先改 3、4、7 的颜色,再对以 19 为根的子树旋转)。
于是两个结构各司其职:红黑树用于”定位包含某地址的区域”,链表用于”遍历全部区域”。插入/删除时内核通过红黑树找到前驱后继,再顺手更新链表,无需扫描。
三类页标志与访问权限
一个内存区域由若干页号连续的页组成。到目前为止我们见过两类页相关的标志:
- 页表项里的硬件标志(Read/Write、Present、User/Supervisor 等),由 80×86 分页单元硬件直接检查(见第 2 章);
- 页描述符 flags 字段里的标志,供内核内部使用(见第 8 章)。
现在引入第三类:内存区域的标志,存放在 vm_flags 字段里:
| 标志 | 说明 |
|---|---|
VM_READ | 页可读 |
VM_WRITE | 页可写 |
VM_EXEC | 页可执行 |
VM_SHARED | 页可被多个进程共享 |
VM_MAYREAD / VM_MAYWRITE / VM_MAYEXEC / VM_MAYSHARE | 允许设置对应 VM_ 标志 |
VM_GROWSDOWN | 区域可向低地址扩展 |
VM_GROWSUP | 区域可向高地址扩展 |
VM_SHM | 区域用于 IPC 共享内存 |
VM_DENYWRITE | 区域映射的文件不允许为写而打开 |
VM_EXECUTABLE | 区域映射了可执行文件 |
VM_LOCKED | 区域的页被锁定,不能换出 |
VM_IO | 区域映射设备的 I/O 地址空间 |
VM_SEQ_READ | 应用程序顺序访问页 |
VM_RAND_READ | 应用程序真正随机地访问页 |
VM_DONTCOPY | fork 新进程时不复制该区域 |
VM_DONTEXPAND | 禁止通过 mremap() 扩展区域 |
VM_RESERVED | 特殊区域,其页不得换出 |
VM_ACCOUNT | 创建 IPC 共享内存时检查空闲内存是否充足 |
VM_HUGETLB | 通过扩展分页机制处理区域中的页 |
VM_NONLINEAR | 区域实现文件的非线性映射 |
区域的读写执行权限可以任意组合(比如”可读不可执行”)。要让硬件直接执行权限检查,这些权限必须复制到所有对应页表项里。初始权限值存在 vm_page_prot 字段,新增页时内核按它设置页表项。
难点在于把区域权限翻译成页保护位并不直接,原因有三:
- 有些情况下,即使
vm_flags允许某访问,也要故意让它触发缺页。典型例子:写时复制(COW)中,两个进程各有一份内容相同、可写但私有的页(VM_SHARED清除),内核把它们放在同一个页框里,任何一方写它时都要先触发异常; - 80×86 的页表只有两个保护位(R/W 和 U/S),而 U/S 位对用户态区域必须恒置 1;
- 支持 PAE 的 Pentium 4 的 64 位页表项多一个 NX(不可执行)位。
于是 Linux 定了如下降级规则(无 PAE 时):
- 读权限 ⇔ 执行权限(互为充要);
- 写权限蕴含读权限。
有 NX 时改为:
- 执行权限蕴含读权限;
- 写权限蕴含读权限。
另外,为配合 COW,非共享的页框一律写保护。16 种读写执行共享的组合按下面规则缩水后存进 protection_map 数组(16 个元素):
- 页有 Write 和 Share 权限 → 置 R/W 位;
- 页有 Read 或 Exec 但既无 Write 也无 Share → 清 R/W 位;
- 支持 NX 且页无 Exec 权限 → 置 NX 位;
- 页无任何权限 → 清 Present 位使每次访问都缺页;但为了和真正的”页不存在”区分,Linux 同时把页尺寸位置 1。
查找与分配线性地址区间
本节是一组底层辅助函数,为 do_mmap() 和 do_munmap() 服务。
find_vma():找最近的区域
find_vma(mm, addr) 找第一个 vm_end 大于 addr 的区域并返回其描述符;找不到返回 NULL。注意:返回的区域不一定包含 addr——addr 可能落在空洞里。
为了提速,每个内存描述符有 mmap_cache 字段缓存”上次引用的区域”。程序的地址访问具有局部性:上次访问落在某区域,下次大概率还在该区域。所以函数先检查缓存:
vma = mm->mmap_cache;
if (vma && vma->vm_end > addr && vma->vm_start <= addr)
    return vma;
缓存不命中才走红黑树查找:
rb_node = mm->mm_rb.rb_node;
vma = NULL;
while (rb_node) {
    vma_tmp = rb_entry(rb_node, struct vm_area_struct, vm_rb);
    if (vma_tmp->vm_end > addr) {
        vma = vma_tmp;
        if (vma_tmp->vm_start <= addr)
            break;
        rb_node = rb_node->rb_left;
    } else
        rb_node = rb_node->rb_right;
}
if (vma)
    mm->mmap_cache = vma;
return vma;
rb_entry 宏负责从红黑树节点指针反推出内存区域描述符的地址。逻辑是:候选节点 vm_end > addr 就先记为 vma;若其 vm_start <= addr 则地址确实落在区域内,成功返回;否则往左子树继续找更小的”结束地址”;vm_end <= addr 则往右子树找。
配套的还有:find_vma_prev() 额外通过 pprev 参数返回所选区域的前一个区域;find_vma_prepare() 则用于插入前定位——返回新叶子应放的位置及前驱区域和父节点。
find_vma_intersection():找与区间重叠的区域
vma = find_vma(mm, start_addr);
if (vma && end_addr <= vma->vm_start)
    vma = NULL;
return vma;
逻辑很巧:先用 find_vma() 找到第一个结束地址大于 start_addr 的区域,如果它的起始地址又超过了区间终点(end_addr <= vma->vm_start),说明中间隔着空洞、没有重叠,返回 NULL。
get_unmapped_area():找空闲区间
get_unmapped_area() 在进程地址空间里找一段可用的线性地址区间,len 指定长度,addr 非空时指定搜索起点,成功返回区间首地址,失败返回 -ENOMEM。
文件映射场景会走文件操作的 get_unmapped_area 方法(见第 16 章);匿名映射走内存描述符的方法,具体实现依进程布局而定,可能是 arch_get_unmapped_area()(从低往高分)或 arch_get_unmapped_area_topdown()(从高往低分)。前者等价于:
if (len > TASK_SIZE)
    return -ENOMEM;
addr = (addr + 0xffff) & 0xffffff000;
if (addr && addr + len <= TASK_SIZE) {
    vma = find_vma(current->mm, addr);
    if (!vma || addr + len <= vma->vm_start)
        return addr;
}
start_addr = addr = mm->free_area_cache;
for (vma = find_vma(current->mm, addr); ; vma = vma->vm_next) {
    if (addr + len > TASK_SIZE) {
        if (start_addr == (TASK_SIZE/3+0xffff)&0xffffff000)
            return -ENOMEM;
        start_addr = addr = (TASK_SIZE/3+0xffff)&0xffffff000;
        vma = find_vma(current->mm, addr);
    }
    if (!vma || addr + len <= vma->vm_start) {
        mm->free_area_cache = addr + len;
        return addr;
    }
    addr = vma->vm_end;
}
要点:
- 先确认长度不超过用户态地址上限
TASK_SIZE(通常 3GB),addr 向上取整到页边界; - 搜索起点通常取
mm->free_area_cache(上次分配区域的末尾之后),初始为用户态地址空间的三分之一(通常 1GB 处)——因为低地址的三分之一预留给有固定起始地址的区域(可执行文件的正文段、数据段、bss 段,见第 20 章); - 从起点开始逐个区域扫描:还没扫到顶就放不下 → 回到 1/3 处重扫一遍,仍失败返回
-ENOMEM;某区域后面的空洞够大 → 更新free_area_cache并返回该地址;空洞不够 → 跳到该区域末尾继续。
insert_vm_struct() 与删除辅助
insert_vm_struct(mm, vma) 把一个初始化好 vm_start/vm_end 的新区域插进链表和红黑树:先用 find_vma_prepare() 定位,再由 vma_link() 完成——①插进 mm->mmap 链表;②插进 mm->mm_rb 红黑树;③匿名区域还要挂进对应 anon_vma 的链表(见第 17 章的反向映射);④递增 mm->map_count。
__vma_unlink(mm, vma, prev) 负责把 vma 从链表和红黑树中摘除,若 mmap_cache 正指向被删区域则一并清掉。
释放线性地址区间
do_mmap():分配线性地址区间
do_mmap() 为当前进程创建并初始化一个新内存区域,参数包括:file/offset(映射文件时的文件对象和偏移)、addr(搜索起点)、len(区间长度)、prot(访问权限:PROT_READ/PROT_WRITE/PROT_EXEC/PROT_NONE)、flag(其余标志)。
常用 flag:
MAP_SHARED/MAP_PRIVATE:区域页可否在多进程间共享,对应VM_SHARED;MAP_FIXED:区间首地址必须严格等于 addr;MAP_ANONYMOUS:区域不关联任何文件(匿名映射);MAP_GROWSDOWN、MAP_LOCKED、MAP_DENYWRITE、MAP_EXECUTABLE:与表 9-5 的 VM_ 标志同名同义;MAP_NORESERVE:不做空闲页框数量的预检查;MAP_POPULATE:预分配映射所需的全部页框;MAP_NONBLOCK:配合 MAP_POPULATE,预分配时不得阻塞。
do_mmap() 对 offset 做些检查后转手给 do_mmap_pgoff()。以匿名区域为例,后者流程如下:
- 参数合法性检查:区间长度为零或越界(超过
TASK_SIZE);区域数超过map_count上限;要求锁定页但进程无权或超过RLIMIT_MEMLOCK限制——任一成立即返回负错误码。 - 调
get_unmapped_area()找空闲区间。 - 组合 prot/flags 计算新区域的 vm_flags:
vm_flags = calc_vm_prot_bits(prot, flags) |
    calc_vm_flag_bits(prot, flags) |
    mm->def_flags | VM_MAYREAD | VM_MAYWRITE | VM_MAYEXEC;
if (flags & MAP_SHARED)
vm_flags |= VM_SHARED | VM_MAYSHARE;- 调
find_vma_prepare()定位插入点;若发现已有区域与新区间重叠(返回的区域起始地址早于新区间终点),就调do_munmap()删掉重叠区间再重来:
for (;;) {
    vma = find_vma_prepare(mm, addr, &prev, &rb_link, &rb_parent);
    if (!vma || vma->vm_start >= addr + len)
        break;
    if (do_munmap(mm, addr, len))
        return -ENOMEM;
}- 检查加入新区域后进程地址空间总大小
(mm->total_vm << PAGE_SHIFT) + len是否超过RLIMIT_AS限制,超了返回-ENOMEM。(这个检查放在第 4 步之后做,因为第 4 步可能删掉了一些区域。) - 若未设置
MAP_NORESERVE且新区间含私有可写页,用security_vm_enough_memory()检查系统空闲页框是否足够,不足返回-ENOMEM。 - 私有匿名区间先尝试
vma_merge():若前一区域标志完全相同,直接扩展它覆盖新区间(若新区间恰好填满两个同标志区域之间的空洞,还能三合一);成功则跳到第 12 步。 - 用
kmem_cache_alloc()从 slab 分配一个新的vm_area_struct。 - 初始化新区域对象:
vma->vm_mm = mm;
vma->vm_start = addr;
vma->vm_end = addr + len;
vma->vm_flags = vm_flags;
vma->vm_page_prot = protection_map[vm_flags & 0x0f];
vma->vm_ops = NULL;
vma->vm_pgoff = pgoff;
vma->vm_file = NULL;
vma->vm_private_data = NULL;
vma->vm_next = NULL;
INIT_LIST_HEAD(&vma->shared);- 若设置
MAP_SHARED且是匿名区域,调shmem_zero_setup()初始化共享匿名区域(主要用于进程间通信,见第 19 章)。 - 调
vma_link()把新区域插入链表和红黑树。 - 递增内存描述符的
total_vm。 - 若设置
VM_LOCKED,调make_pages_present()依次分配区域内所有页并锁定在 RAM 中——底层是get_user_pages()遍历每个页的起始地址,先follow_page()查页表,缺页就调handle_mm_fault()补页框。 - 返回新区域的线性地址。
do_munmap():释放线性地址区间
要删除的区间通常并不正好是一个内存区域——可能只占某区域的一部分,也可能横跨多个区域。do_munmap(mm, start, len) 分两个阶段:第一阶段(16 步)扫描并”脱链”,第二阶段(712 步)更新页表并真正删除。
- 参数检查:区间越界、start 不是 4096 的倍数、长度为零 → 返回
-EINVAL。 mpnt = find_vma_prev(mm, start, &prev)找第一个结束地址大于 start 的区域。- 没找到、或该区域与区间无重叠(
mpnt->vm_start >= end)→ 无事可做,返回 0。 - 若区间起点落在 mpnt 内部(
start > mpnt->vm_start),调split_vma()把 mpnt 一分为二:区域外保留、区域内待删。同时把 prev 更新为 mpnt(即待删区段之前的那个区域)。 - 若区间终点落在某区域内部,再调一次
split_vma()把最后一个重叠区域拆成”待删 + 区外保留”。 - 把 mpnt 指向区间内的第一个区域:
mpnt = prev ? prev->vm_next : mm->mmap; detach_vmas_to_be_unmapped()把区间内的所有区域从链表和红黑树中摘下来串成一个临时列表:
vma = mpnt;
insertion_point = (prev ? &prev->vm_next : &mm->mmap);
do {
    rb_erase(&vma->vm_rb, &mm->mm_rb);
    mm->map_count--;
    tail_vma = vma;
    vma = vma->next;
} while (vma && vma->start < end);
*insertion_point = vma;
tail_vma->vm_next = NULL;
mm->map_cache = NULL;- 获取
mm->page_table_lock自旋锁。 - 调
unmap_region()清空覆盖该区间的页表项并释放页框。 - 释放自旋锁。
- 逐个释放第 7 步收集的区域描述符(
unmap_vma():更新total_vm/locked_vm、执行unmap_area方法更新free_area_cache、调用区域的 close 方法、匿名区域摘出 anon_vma 链表、kmem_cache_free()释放描述符)。 - 返回 0。
split_vma() 与 unmap_region()
split_vma(mm, vma, addr, new_below) 把与区间相交的区域拆成两个:
kmem_cache_alloc()再拿一个vm_area_struct,失败返回-ENOMEM;- 新描述符各字段照抄 vma;
new_below为 0(区间起点在区域内):把new->vm_start和vma->vm_end都设为 addr,新区域排在 vma 后面;new_below为 1(区间终点在区域内):把new->vm_end和vma->vm_start都设为 addr,新区域排在 vma 前面;- 有 open 方法就执行它;
- 把新区域挂进链表和红黑树,并调整红黑树以适应 vma 的新尺寸;
- 返回 0。
unmap_region(mm, vma, prev, start, end) 负责释放区间内页框:
- 调
lru_add_drain(); - 调
tlb_gather_mmu()初始化每 CPU 变量mmu_gathers(80×86 上只是把 mm 指针存进本地 CPU 的 mmu_gathers); - 调
unmap_vmas()扫描区间内所有页表项:单 CPU 时反复调free_swap_and_cache()释放页;多 CPU 时把页描述符指针收集进 mmu_gathers; - 调
free_pgtables()回收上一步清空了的页表; - 调
tlb_finish_mmu()收尾:先flush_tlb_mm()刷新 TLB,多处理器系统再调free_pages_and_swap_cache()释放收集到的页框。
缺页异常处理程序
缺页异常处理程序的核心任务:区分”编程错误”和”合法但尚未分配的页”。80×86 上的中断服务例程是 do_page_fault(),它拿引发异常的线性地址与当前进程的内存区域对比,按下面的总体方案处理:
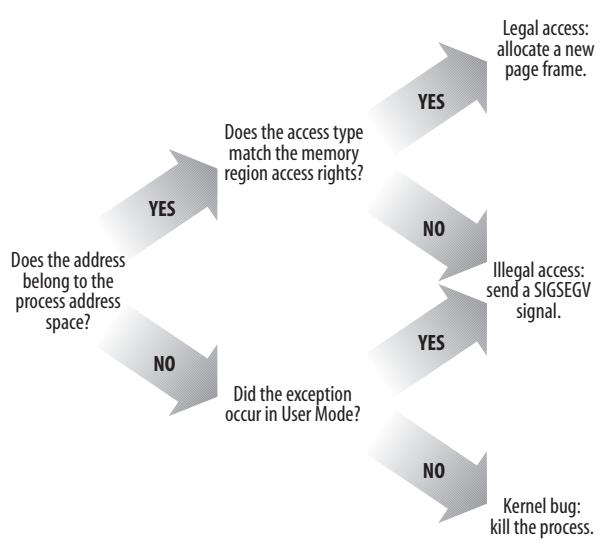 图 5:缺页处理程序总体方案(原书图 9-4)
实际代码远比这张草图复杂——处理程序要识别好几种 awkward 的子情况。完整流程图如下(vmalloc_fault、good_area、bad_area、no_context 是 do_page_fault() 里的标号):
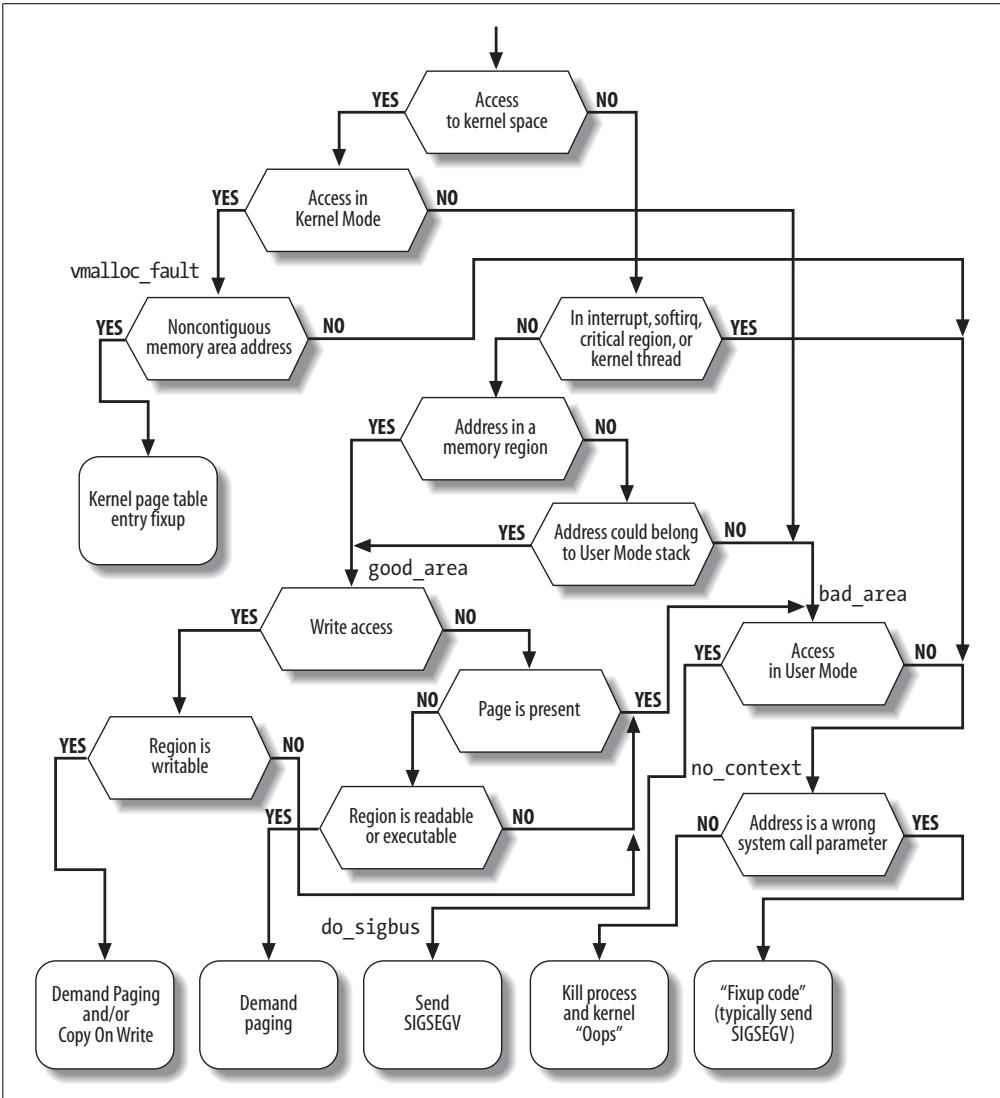 图 6:缺页处理程序流程图(原书图 9-5)
入口参数
regs:指向 pt_regs 结构,保存异常发生时的处理器寄存器;error_code:异常发生时控制单元压栈的 3 位错误码:- 位 0 为 0:访问的页不存在(页表项 Present 标志为 0);为 1:访问权限非法;
- 位 1 为 0:读/执行访问;为 1:写访问;
- 位 2 为 0:内核态发生;为 1:用户态发生。
第一步从 cr2 控制寄存器读出引发异常的线性地址:
asm("movl %%cr2,%0":"=r" (address));
if (regs->eflags & 0x00020200)
    local_irq_enable();
tsk = current;
分支一:地址在第四个 GB(内核空间)
info.si_code = SEGV_MAPERR;
if (address >= TASK_SIZE) {
    if (!(error_code & 0x101))
        goto vmalloc_fault;
    goto bad_area_nosemaphore;
}
如果是内核态访问了不存在的页框(错误码位 0 和位 2 都为 0),跳到 vmalloc_fault——多半是访问了非连续内存区(vmalloc 区),见本节末尾;否则直接判为非法地址,走 bad_area_nosemaphore。
分支二:中断、临界区、内核线程
if (in_atomic() || !tsk->mm)
    goto bad_area_nosemaphore;
in_atomic() 为 1 的两种情况:正在执行中断处理程序或可延迟函数;正在执行禁用了内核抢占的临界区。内核线程的 mm 恒为 NULL。这些场景下都不允许把缺页地址与 current 的内存区域做对比(内核线程根本不用低地址;中断上下文访问低地址可能阻塞当前进程)——统统当非法处理。
分支三:正常进程,先拿信号量
if (!down_read_trylock(&tsk->mm->mmap_sem)) {
    if ((error_code & 4) == 0 &&
        !search_exception_table(regs->eip))
        goto bad_area_nosemaphore;
    down_read(&tsk->mm->mmap_sem);
}
为什么用 down_read_trylock() 而不是 down_read()?防止死锁。如果信号量已被(本进程或别的路径)拿去写且一直不释放,这里就不能傻等。若获取失败且异常发生在内核态,处理程序用 search_exception_table() 判断:异常指令是否在访问系统调用参数里的用户态地址?是的话说明信号量肯定被别的进程持有(系统调用服务例程访问用户地址空间前都会小心地不持写锁),放心阻塞等待即可;否则就是内核 bug 或硬件故障,走 bad_area_nosemaphore。
分支四:查找内存区域 + 栈自动扩展
vma = find_vma(tsk->mm, address);
if (!vma)
    goto bad_area;
if (vma->vm_start <= address)
    goto good_area;
vma 为 NULL:没有任何区域结束在 address 之后,地址必然非法。返回的区域包含 address:跳 good_area。都不满足:地址落在空洞里,但还有一次机会——它可能来自对用户态栈的 push 指令!
栈区域的特别之处:它带 VM_GROWSDOWN 标志,向低地址扩展,vm_end 固定而 vm_start 只能减小、永不增大。区域边界只是”粗略”包住栈,原因有二:区域大小必须是 4KB 的倍数而栈大小任意;分配给区域的页框在区域删除前从不回收,即使进程连续执行 pop 指令,区域大小也不变。所以当进程把栈顶页框用满后再 push,访问的地址就落在区域之外——但这不是编程错误,必须单独处理: