这一篇在干嘛?
全书路线图:DSP 技术都用在哪儿、FPGA 与 ASIC/GDSP 的本质区别、Altera FPGA 的内部结构,以及一个贯穿全书的频率合成器设计实例。 原书代码为 VHDL,本篇所有代码已改写为 Verilog。
- 第1章
- 绪论
- 1.1 数字信号处理技术概述
- 1.2 FPGA 技术
-
- 小颗粒度器件
-
- 中等颗粒度器件
-
- 大颗粒度器件
- 1.3 DSP 的技术要求
- FPGA 和可编程信号处理器
- 1.4 设计实现
- 例 1.1 VHDL 设计类型的比较
-
- 逻辑资源
-
- 额外的资源和路由
-
- 定时估算
- 例 1.2 32 位加法器的速度
-
- 功耗
-
- 设计的编译
-
- 平面布置图
-
- 仿真
-
- 性能分析
-
- 软内核
-
- 参数化内核
-
- 硬内核
-
- 知识产权内核的比较和难题
-
- 基于知识产权内核的 NCO 设计
- 1.5 练习
- 1.22 给定如下 MATLAB 指令:
自测一下
FPGA 与 ASIC 最大的区别是什么?
FPGA 通过查找表(LUT)实现逻辑,可反复烧写;ASIC 是固定掩膜电路,不可更改但量产成本更低、速度更快。FPGA 适合原型验证与小批量,ASIC 适合大规模量产。
为什么 DSP 系统中定点数比浮点数更常用?
定点运算单元面积小、速度快、功耗低,FPGA 内部大量 LUT/乘法器天然适合定点;浮点需要额外的指数对齐与规格化逻辑。只有动态范围要求极大的场合才用浮点。
Altera FPGA 的 LAB、LE、LUT 是什么关系?
LUT(查找表)是最小的逻辑单元,实现任意组合逻辑;多个 LUT+寄存器组成 LE(逻辑单元);若干 LE 成组构成 LAB(逻辑阵列块),LAB 内部走线最快。
什么是 IP 内核?为什么要用它?
IP 核是预先设计验证好的功能模块(如 FIR 滤波器、FFT)。用它可以把精力集中在系统设计上,且厂商 IP 针对其 FPGA 架构做了充分优化,比自己写的同等功能电路更快更省资源。
1.1 数字信号处理技术概述
数字信号处理(Digital Signal Processing,DSP)是指用数字电路对信号做滤波、变换、压缩等运算的技术。所谓”信号”,就是携带信息的随时间变化的物理量——比如麦克风输出的话音电压、天线收到的无线电波形。早期这些处理全靠电阻、电容、运放搭成的模拟电路完成,而 DSP 用”采样 + 计算”的思路取代了它们。
DSP 为什么能取代模拟系统?核心优势有三点:其一,数字元器件对温度变化、器件老化和元件容差不敏感——模拟电路里两个标称相同的电阻可能差 5%,运算结果就跟着漂;数字电路里 1 就是 1,很少受物理条件影响。其二,随着工艺进入亚微米尺度,模拟芯片受噪声困扰越来越严重,而数字设计在集成度上反超模拟,于是紧凑、低功耗、低成本的数字产品成为主流。
DSP 的应用面极广,可以按领域粗略分类:
- 通用领域:滤波与卷积、自适应滤波、谱估计与傅里叶变换;
- 语音/音频:编解码、回声消除、噪声消除、混音、声音合成,甚至人工耳蜗的信号处理;
- 图像:压缩解压、旋转、图像增强与识别;
- 信息系统:调制解调器、移动电话、线路均衡、加密解密、无线局域网;
- 控制与仪器:伺服控制、磁盘/发动机控制、机器人、雷达声呐、波形发生器。
DSP 发展史上有两个加速器值得记住。第一个是 1965 年 Cooley 和 Tukey 发表的快速傅里叶变换(FFT)算法——它把计算离散傅里叶变换(DFT)的运算量从 级降到约 级,让频域分析第一次变得”算得动”。第二个是 20 世纪 70 年代后期出现的可编程数字信号处理器(PDSP):它能在单个时钟周期内完成一次定点乘-累加(Multiply-Accumulate,MAC)运算,而同期基于冯·诺依曼结构的普通微处理器做同样的事要几十个周期。现代 PDSP 还集成了浮点乘法器、桶式移位器、片上存储器甚至 A/D、D/A 接口。
一个典型的 DSP 系统长什么样?请看图 1-1。模拟信号首先经过抗混叠滤波器,它的阻带从采样频率的一半()开始——根据采样定理,采样会以 为周期复制频谱,如果信号中有超过 的成分,这些”镜像频率”就会折叠到带内造成混叠失真,且混叠一旦发生便无法事后消除,所以必须在采样前用模拟滤波器拦住。接着是模数转换器(ADC),完成采样保持、量化和编码,把连续波形变成一串数字。然后由数字处理电路完成与原来模拟系统等效的运算,结果既可以直接存储(如存入 CD),也可以经数模转换器(DAC)还原成模拟输出(如音频信号)。
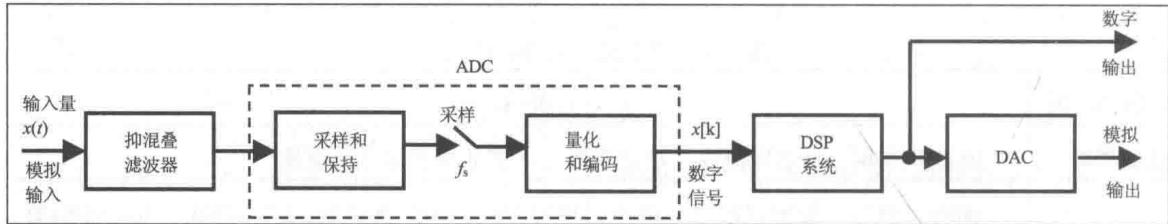 图 1-1 一个典型的 DSP 应用示例(模拟滤波 → ADC → 数字处理 → DAC)
1.2 FPGA 技术
超大规模集成(VLSI)电路可以按图 1-2 分类。其中 FPGA(现场可编程门阵列)属于现场可编程逻辑(Field-Programmable Logic,FPL)器件——FPL 的定义是:由大量可反复配置的小规模逻辑模块和互连元件构成的可编程器件。FPGA 本质上是一种专用集成电路(ASIC),但与传统 ASIC 有个关键区别:典型 ASIC 需要额外的半导体制造工序,这些工序带来性能和功耗优势,同时带来高昂的一次性工程成本(NRE)——在 40nm 工艺节点,NRE 大约是 400 万美元,只有产量足够大才摊得薄。而门阵列(由”与非门海”构成,用户用网表描述功能,最后靠金属层布线定型)属于半定制 ASIC;FPL 的设计者则完全掌控实现过程,不需要任何芯片制造设备,改一版设计只是重新下载一次配置文件,不会因流片而拖慢进度。
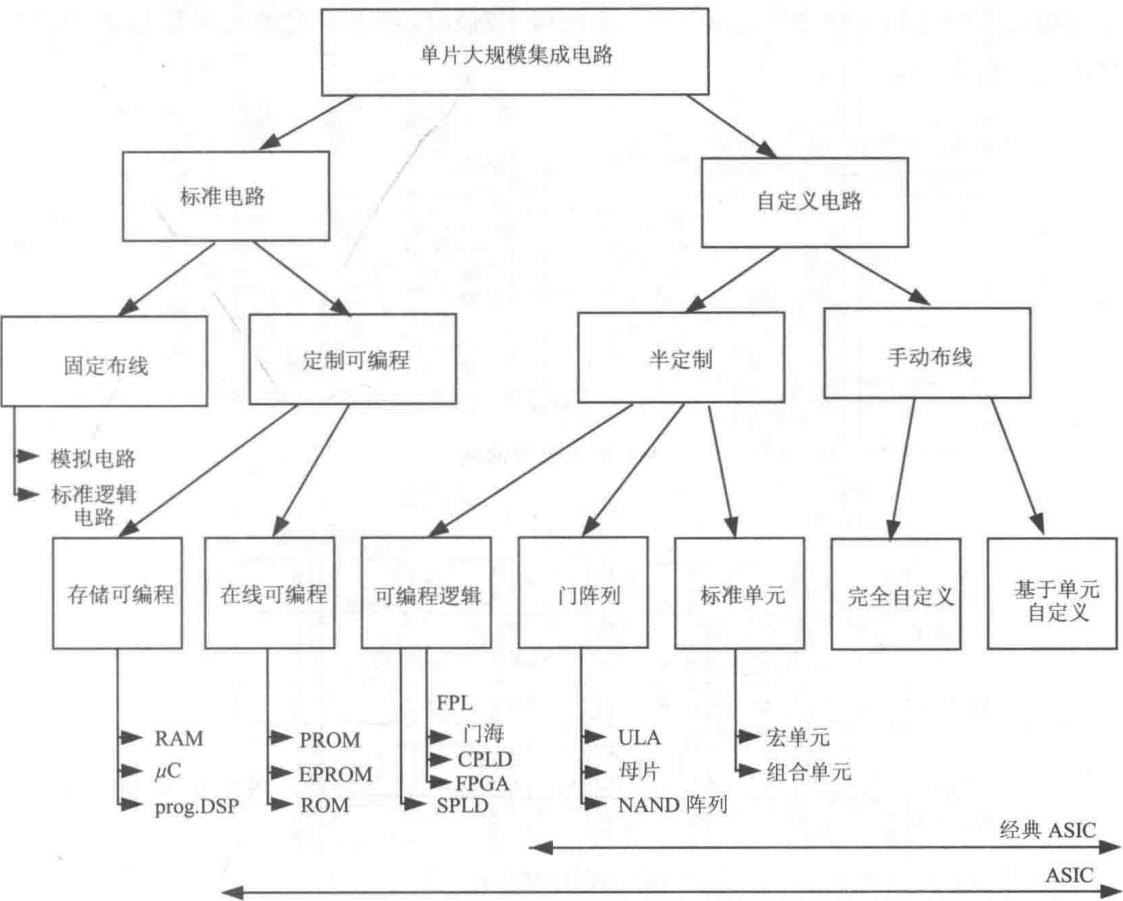 图 1-2 VLSI 电路的分类(FPGA 归属于现场可编程逻辑 FPL 一支)
1.2.1 按颗粒度分类
“颗粒度”指基本逻辑模块的大小,它决定了模块之间需要多少布线(路由)资源。通常分三类:
1. 小颗粒度器件
以 Pilkington(曾授权给 Plessey 和 Motorola)为代表,基本单元只有一个与非门加一个锁存器(图 1-3(a))。与非门被称为”通用门”——任何二进制逻辑函数都能只用与非门搭出来。但代价是布线资源消耗极大:门阵列里靠额外金属层布线没什么问题,可编程结构里布线却成了瓶颈;而且搭一个简单 DSP 单元就要海量与非门——一个高速 4 位加法器约需 130 个与非门。算一笔账:实现一个 FIR 滤波器动辄需要几十个加法器和乘法器,若每个加法器都要上百个与非门,小颗粒度结构很快就撑不住了,因此它对大多数 DSP 算法没有吸引力。
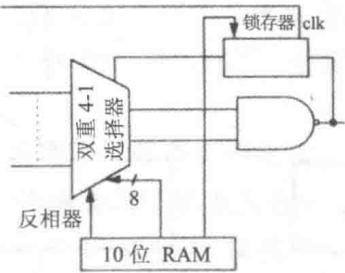 图 1-3(a) 小颗粒度器件的基本逻辑模块:一个与非门加一个锁存器
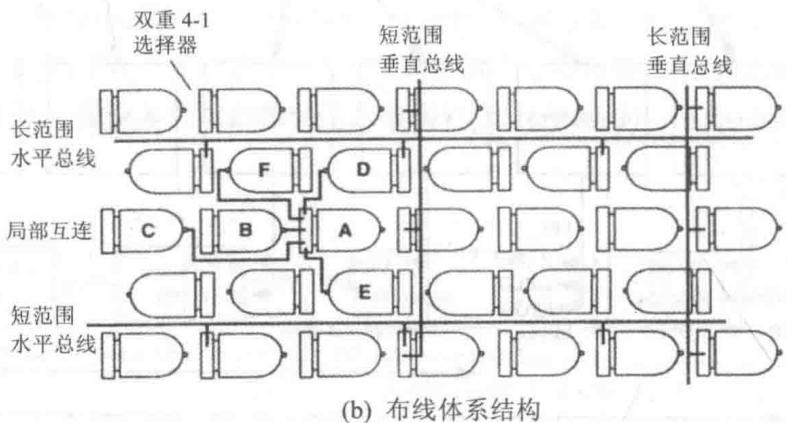 图 1-3(b) 含 10K 个与非逻辑模块的 Plessey ERA60100 体系结构(© Plessey)
2. 中等颗粒度器件
这是最常见的 FPGA 结构(图 1-4(a))。代表性基本模块是小规模查找表(LUT,典型为 45 个输入、12 个输出),或由专用多路复用器(MPX)逻辑构成(如 Actel 的 ACT-2 器件)。LUT 的原理类似”真值表硬件化”:把逻辑函数的所有输入组合对应的输出预先存进小存储器,查表即得结果,因此任意组合逻辑都能实现。布线通道有短有长,带触发器的可编程 I/O 模块贴在器件边缘。
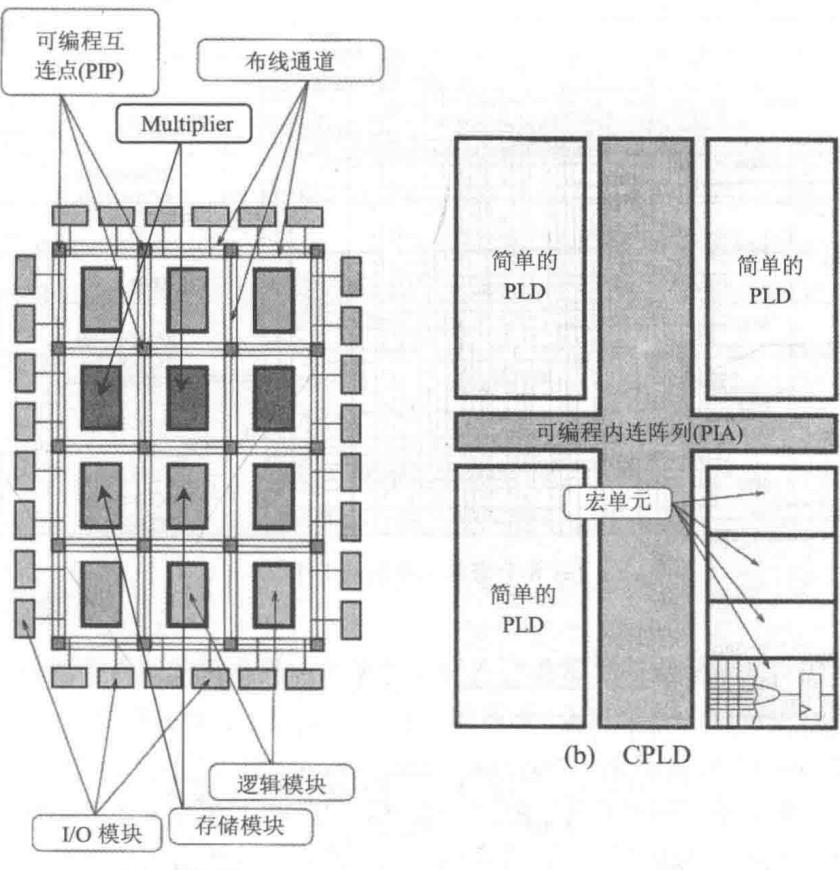 图 1-4(a) 中等颗粒度 FPGA 的体系结构:LUT 阵列 + 分层布线通道 + 边缘 I/O
3. 大颗粒度器件
代表是复杂可编程逻辑器件(CPLD),见图 1-4(b)。CPLD 可以理解为把许多简单可编程逻辑器件(SPLD)拼在一起,典型的 SPLD 就是图 1-5 所示的 GAL16V8 这类芯片:由可编程”与/或”阵列和通用 I/O 单元组成,通常有 810 个输入、34 个输出,支持约 20 个乘积项。SPLD 模块之间用宽总线互连(Altera 称之为可编程互连阵列 PIA),延时很短。宽总线加固定的 SPLD 时序,使 CPLD 的引脚到引脚延迟可以预先算准——这是 CPLD 相对 FPGA 的一个特色。
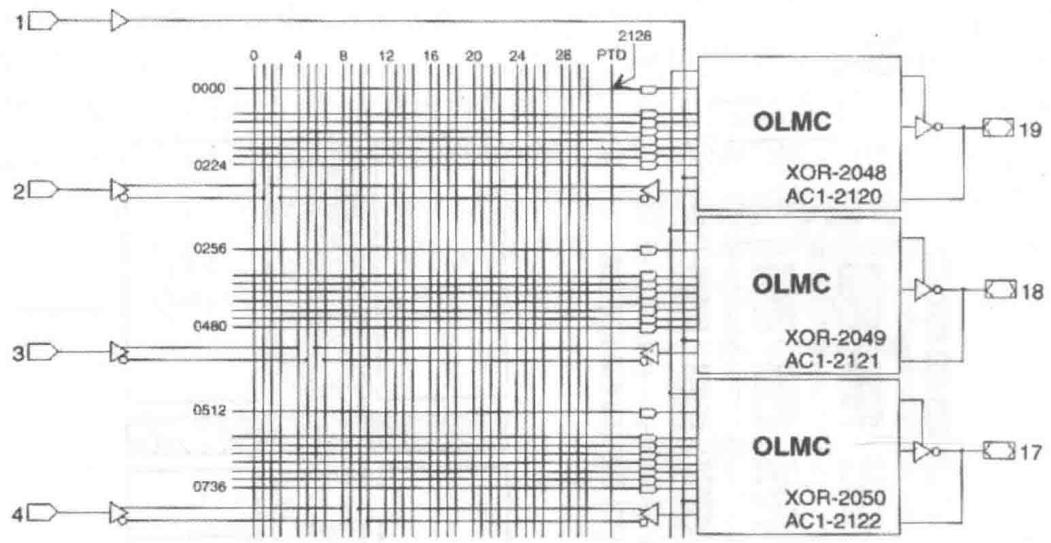 图 1-5(a) GAL16V8 的 8 个宏单元中的前 3 个(© Lattice)
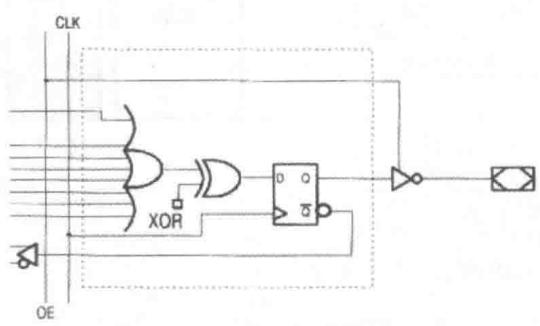 图 1-5(b) GAL16V8 的输出逻辑宏单元(OLMC)内部结构(© Lattice)
1.2.2 按技术分类
FPL 几乎用到所有存储工艺:SRAM、EPROM、PROM、反熔丝和 Flash。初学者要抓住两个维度:能否重复编程、是否易失。
- SRAM:FPGA 的主流技术,基于静态 CMOS 存储,可在系统上反复编程;但配置信息存在易失性存储器里,断电即丢,因此必须外挂一块”引导”器件在上电时加载配置。编程用单比特流,布线简单但耗时(毫秒级)。
- EPROM:需紫外线擦除,多用于一次性编程。
- PROM:电可擦写,可重复且在系统编程;配置信息不用下载,掉电不丢,还能更好地防止未授权复制。
- Flash:基于 EPROM 的新技术,单元更小、“页方式”操作,可视为系统级可重编程的 PROM 等价物。
- 反熔丝:一次性编程,不可逆,但抗辐射、可靠性高。
一句话总结各工艺的取舍:SRAM 灵活但易失,非易失工艺(EPROM/PROM/Flash/反熔丝)省掉了配置芯片但灵活性或密度各有短板;产品示例方面,Xilinx 的 Spartan、Altera 的 Cyclone 是 SRAM 型代表,Actel 的 ACT 系列用反熔丝。
1.2.3 FPL 的基准
怎么客观比较不同厂商的 FPL?Xilinx、Altera 和 Actel 共同建立了可编程电子产品性能协议(PREP)组织,制定了 9 种基准电路(表 1-3):数据通道、定时器/计数器、小型与大型状态机、算法电路(4 位×4 位无符号乘法器 + 8 位累加器)、16 位累加器、16 位计数器、16 位同步降值计数器、存储器映射器。测法是:让每个厂商用自家器件和工具,把同一个基准模块在指定器件里尽可能多地塞进去,同时尽量提高速度;塞进去的份数叫重复率(repetition rate)。对 DSP 而言,第 5、6 项(乘法器-累加器、累加器)最相关。
图 1-6 按相对频率给出 Altera 与 Xilinx 典型大学开发板器件的重复率。结论是:Xilinx 的速度看起来更高,Altera 的 FPGA 重复数更大;而无论如何,现代 FPGA 系列在 DSP 的复杂度和速度上都胜过 CPLD。关键原因是现代 FPGA 提供了快速进位逻辑(每比特传播延迟小于 0.1ns),多位宽快速加法不再需要昂贵的”超前进位”译码器。
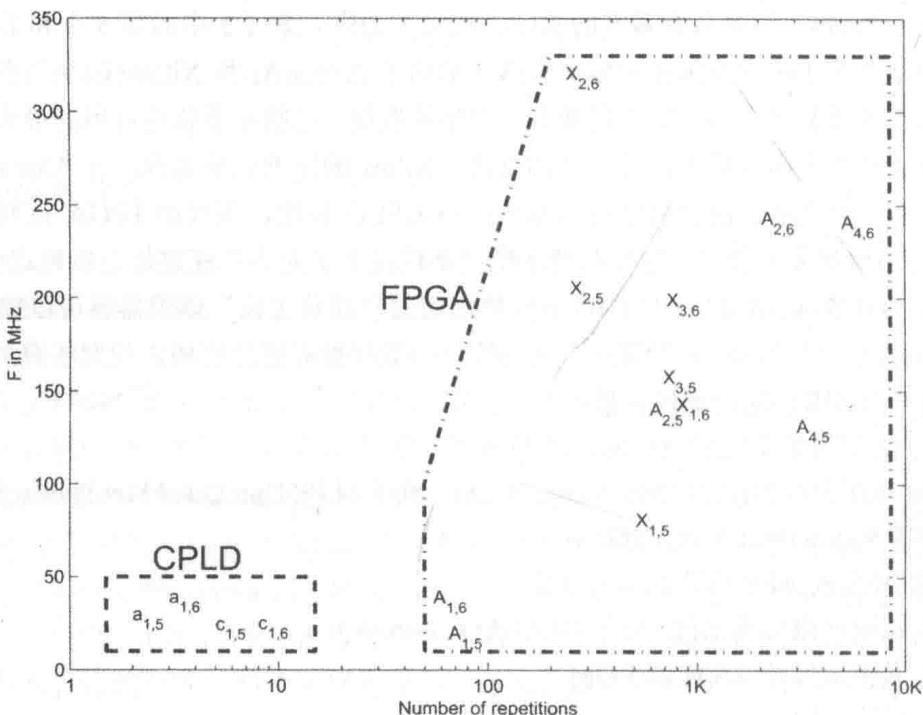 图 1-6 Altera 与 Xilinx 系列 FPGA/CPLD 器件的 PREP 重复率相对频率比较
但 PREP 基准只回答”等效门数和速度”,做具体 DSP 设计时还要看这些属性:嵌入式阵列乘法器(18×18、18×25 等)、封装形式(BGA、TQFP、PGA)、DES/AES 数据流加密、嵌入式硬件微处理器(如 32 位 ARM Cortex-A9)、片上大块 RAM/ROM、片上快速 ADC、外部存储器支持(ZBT、DDR、QDR、SDRAM)、引脚间延迟、内部三态总线、读回/边界扫描、I/O 电压与压摆率可编程性、功耗,以及 ×1/×2/×4 总线标准的 IP 硬核等。
两家厂商的系列分工可以这么记:Xilinx 的 Virtex 主打性能、Kintex 面向 DSP 且价格较低、Artix 最便宜(接替 Spartan),另有内嵌 ARM 的 ZYNQ;多数器件配 18Kbit 或 36Kbit 存储块,第 6 代 Virtex 首次带 10 位 0.2MSPS 片上 ADC,第 7 代升级为 12 位 1MSPS 双通道 ADC,约 17 个片上传感器(温度、供电等)可供读取(图 1-7(b))。Altera 的 Stratix 性能最高、Arria 中等、Cyclone 成本/功耗/密度/性能都最低;逻辑模块从 4 输入 LUT 演进到最多 8 输入的 ALM(自适应逻辑模块,图 1-7(a)),使 3 输入加法器几乎能以 2 输入加法器的速度搭建——ALM 内含两个触发器、两个全加器、两个 4 输入 LUT、4 个 3 输入 LUT 和多个多路复用器。嵌入式乘法器规格从 9×9、18×18 到 27×27(第 5 代起把 3 个 9 位模块拼成一个快速 27×27 乘法器)。存储块覆盖 M512、M4K、M9K、M10K、M144K 等规格。注意软件限制:Quartus II 网络版 12.1 只有 Cyclone 系列可用,Arria/Stratix 需订购版;Xilinx 网络版只有 Spartan 可用。
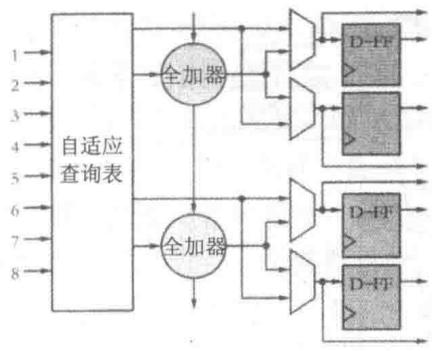 图 1-7(a) Altera 的 ALM 模块:含 2 个触发器、2 个全加器和多个 LUT/多路复用器
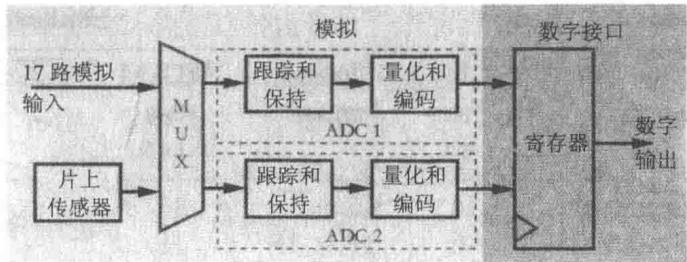 图 1-7(b) Xilinx 第 7 代器件的高速片上 ADC 及传感器接入
功耗也是关键指标,移动应用尤其如此:CPLD 的”备用”功耗通常较高;FPGA 在高频应用下功耗会明显上升,1.4.2 节会给出具体的功耗分析示例。
1.3 DSP 的技术要求
从市场看(图 1-8),PLD 自 20 世纪 80 年代初问世以来曾长期保持约每年 20% 的增长,比 ASIC 高出 10 个百分点以上;2001 年微电子业整体衰退曾拖慢两者,2003 年起两大厂商又恢复约每年 10% 的增长。FPL 能胜过 ASIC,是因为它拿到了 ASIC 的大部分优点——尺寸、重量、功耗下降,吞吐量更高,可禁止未授权复制,器件与开发成本、电路板测试成本更低——同时避开了 ASIC 的两大痛点:
- 开发时间缩短 3~4 倍(可快速做原型),且支持在线重复编程;
- 小批量更省钱:少于 1000 片时 NRE 摊不薄,FPL 经济性碾压;真正的大批量(多于 1000 片)才轮到标准单元(CBIC)ASIC 出场——同样小片面积下它的门数是 FPL 的 10 倍以上。
中间地带的方案是”硬布线 FPGA”:把已验证的 FPGA 设计固化到门阵列上(Altera 叫 HardCopy ASIC,Xilinx 叫 EasyPath FPGA),兼顾性能与产量。
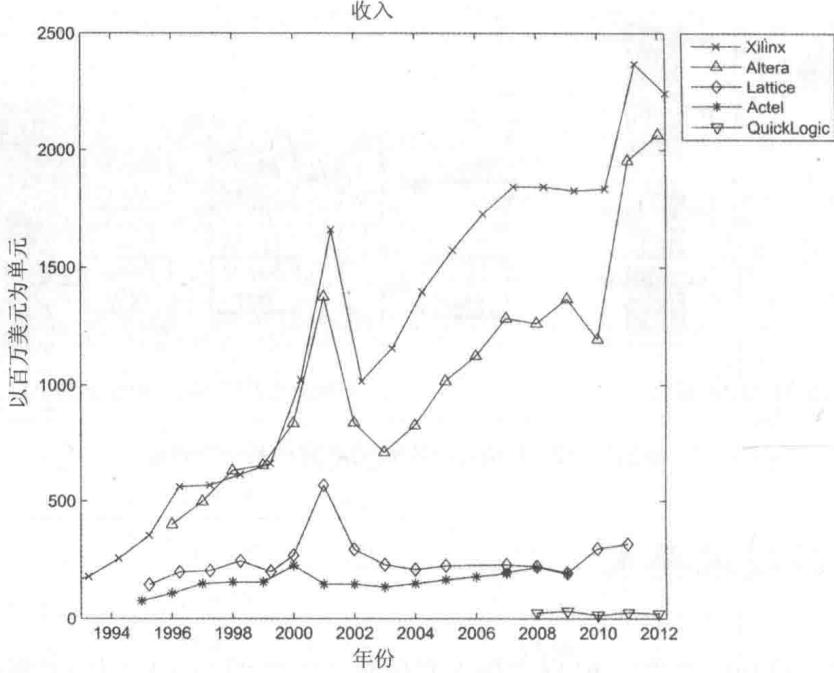 图 1-8 5 家主要厂商在 PLD/FPGA/CPLD 市场的收入走势
FPGA 和可编程信号处理器
PDSP 基于 RISC 思想,核心是”一个快速阵列乘法器(16×16 到 24×24 位定点或 32 位浮点)+ 加宽字长的累加器”,靠多级流水线让 MAC 速度只受乘法器限制。信号处理算法中 MAC 运算出现得极频繁,这正是 PDSP 的甜蜜点。那 FPGA 凭什么竞争?靠并行:一个 PDSP 芯片通常只有一两个 MAC 单元,而 FPGA 可以在一颗芯片上摆下多级 MAC 单元,在无线电、多媒体、卫星传输这类高带宽场合提供 PDSP 给不了的吞吐量;CORDIC、数论变换(NTT)、差错校正等算法上 FPL 也更有效率。业界的共识是:复杂算法(大量 if-then-else 分支)的应用归 PDSP,前端(传感器侧)的 FIR 滤波、CORDIC、FFT 归 FPGA——后者正是本书的主旨。
浮点性能方面,FPGA 也已给出有说服力的答卷。看表 1-6 的对比:任务是做尽可能多的千兆浮点乘-累加(GFPMACS)。一块 Stratix IV FPGA(DE4 开发板,大学项目价约 $1000,商业价 $3000)即可胜任;而最快的浮点 PDSP 是 TI 的 TMS320C6727B-350,主频 350MHz、提供 700MMAC(兆次乘加/秒)。需要多少片呢?代入数字:
即 62 片 PDSP 才追平单块 FPGA 的 43.5 GFPMACS(Stratix IV 单次浮点 MAC 约需 475 个 ALM 加 4 个嵌入式 9×9 乘法器)。成本上,62 片 × $29.03 ≈ $1799,而单块 FPGA 方案 $871——总成本改善超过 100%,电路板面积和功耗的节省更是显而易见。
1.4 设计实现
VLSI 设计可以在多个抽象层次进行(表 1-7):系统层讲性能说明,芯片层讲算法,寄存器层讲数据流(寄存器、ALU、计数器、多路复用器),门层讲布尔方程(与/或/异或/触发器),线路层讲微分方程(晶体管、R/L/C),最底层是几何版图。FPGA 的物理结构可编程但固定,不存在 ASIC 那样的全定制布局布线,因此在门/寄存器层次用寄存器转换级(RTL)硬件描述语言描述最能用足器件。现代 FPGA 复杂度激增,于是设计方法转向知识产权宏单元(IP 核/mega-core):IP 核提供预定义功能(如微处理器、UART),设计者只指定精度等参数,“合成器”自动生成最终代码或原理图。
FPGA 设计流程(图 1-9)按序走一遍:设计入口(图形或文本 HDL)→ 格式检查(语法错误、悬空导线等)→ 抽取功能网表,做 RTL 级功能仿真(用测试平台 testbench 提供激励数据),并生成 RTL 视图帮助理解电路结构。功能仿真不通过就回设计入口改。通过后进入设计实现(综合、布局布线,编译时间长得多),完成后布线确定,得到精确的资源占用数据,可执行带完整时序延迟信息的时序仿真和性能测试。全部达标就生成编程文件下载到开发板,否则回到设计入口。调试阶段还能借 JTAG 接口”透视”FPGA 内部:只读 I/O 单元叫边界扫描,能读回所有内部触发器叫完全扫描。选图形环境还是文本环境看个人:图形方式适合强调规则数据流的 DSP 算法,文本(HDL)方式更适合算法控制类设计,且能更精确地表达行为特性——本书采用文本方式。
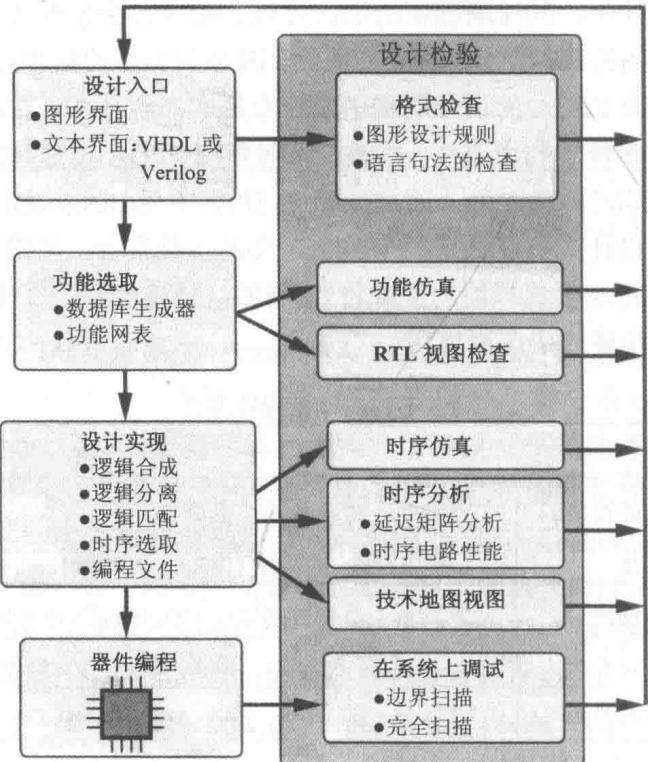 图 1-9 CAD 设计周期:设计入口 → 功能仿真 → 设计实现 → 时序仿真 → 编程下载
例 1.1 三种 HDL 设计风格的比较(原书 VHDL 改写为 Verilog)
原书用 VHDL 演示了三种设计策略:结构化(组件实例化,类似图形网表)、数据流(并发语句)、行为/顺序(PROCESS 块)。下面的 Verilog 代码与原逻辑完全等价——模块名与端口语义保持一致,即:输入 8 位信号 a、b、op1 和时钟 clk、异步复位 reset;sum 输出 op1 + b 的寄存结果;c 输出 a + b(有符号整数);d 在每个时钟沿输出 s,而 s 逐拍累加 a 与 b。
// 原书 VHDL 改写为 Verilog:结构化 + 数据流 + 行为三种风格并存
module example #(
    parameter WIDTH = 8                          // 位宽(对应 GENERIC)
)(
    input  wire                clk,              // 系统时钟
    input  wire                reset,            // 异步复位
    input  wire [WIDTH-1:0]    a, b, op1,        // 逻辑向量输入
    output reg  [WIDTH-1:0]    sum,              // 逻辑向量输出
    output reg  signed [7:0]   c, d              // 整数输出(对应 S8: -128~127)
);

    // ---------- 1. 结构化风格:实例化库元件(对应 COMPONENT) ----------
    wire [WIDTH-1:0] op2 = b;                    // 类型转换
    wire [WIDTH-1:0] op3;

    lib_add_sub #(.WIDTH(WIDTH)) add1 (          // 加法器
        .dataa (op1),
        .datab (op2),
        .result(op3)
    );
    lib_ff #(.WIDTH(WIDTH)) reg1 (               // 寄存器
        .clock (clk),
        .data  (op3),
        .q     (sum)
    );

    // ---------- 2. 数据流风格:并发赋值(语句顺序无关紧要) ----------
    wire signed [7:0] a_i = a;                   // 有符号类型转换
    wire signed [7:0] b_i = b;
    assign c = a_i + b_i;

    // ---------- 3. 行为/顺序风格:PROCESS 对应 always 块 ----------
    reg signed [7:0] s;
    always @(posedge clk or posedge reset) begin
        if (reset) begin                         // 异步清零
            s <= 8'sd0;
            d <= 8'sd0;
        end else begin
            s = s + a_i;      // 阻塞赋值:立即生效,等价于 VHDL 的 VARIABLE
            s = s + b_i;      // 这两条语句的顺序会改变结果!
            d <= s;           // 非阻塞赋值:d 得到两次累加之后的 s
        end
    end
endmodule

// 被实例化的两个简单元件(实际设计通常由综合器自动推断)
module lib_add_sub #(parameter WIDTH=8)
   (input  wire [WIDTH-1:0] dataa, datab,
    output wire [WIDTH-1:0] result);
    assign result = dataa + datab;               // 简化模型:仅演示加法
endmodule

module lib_ff #(parameter WIDTH=8)
   (input  wire                clock,
    input  wire [WIDTH-1:0]    data,
    output reg  [WIDTH-1:0]    q);
    always @(posedge clock) q <= data;
endmodule
初学者最容易在这里犯糊涂的是 VHDL”信号 vs 变量”的区别,对应到 Verilog 就是”非阻塞 vs 阻塞赋值”。Verilog 中 assign 与 wire 类似 VHDL 的并发 SIGNAL 语句——语句先后顺序无所谓,c = a_i + b_i 与 a_i、b_i 的定义谁前谁后都不影响结果。而在 always(相当于 PROCESS)内部:阻塞赋值(=)像普通 C 程序一样逐条立即生效,所以 s 先加 a_i、再加 b_i,d 最后拿到的是两次累加后的 s;如果写成非阻塞赋值(<=),三条语句同时取”旧值”,d 就拿不到 b_i 那一步的结果。这正复现了原书 VHDL 注释强调的顺序陷阱。另外注意类型:VHDL 是强类型语言,INTEGER 与 STD_LOGIC_VECTOR 之间必须显式调用转换函数;Verilog 里用 signed 修饰即可直接做有符号运算。
代码编译、仿真通过后,最终得到编程文件下载到原型开发板。Altera 的 DE2-115 开发板(图 1-10(a),基于 Cyclone IV)是教学性价比之选:双通道音频 CODEC、大容量外部存储,以及 USB、VGA、PS/2、以太网、7 段 LED、LCD、开关、按键等丰富外设。Xilinx 几乎不直接卖板子,第三方板很便宜,如 Digilent 的 Atlys(图 1-10(b),学术价 $199):Spartan-6 XC6SLX45 芯片、16MB 闪存、128MB 内存、8 个 LED、8 个开关、5 个按钮,音频 AC-97 CODEC 和 4 个 HDMI 端口适合 DSP 与视频实验。
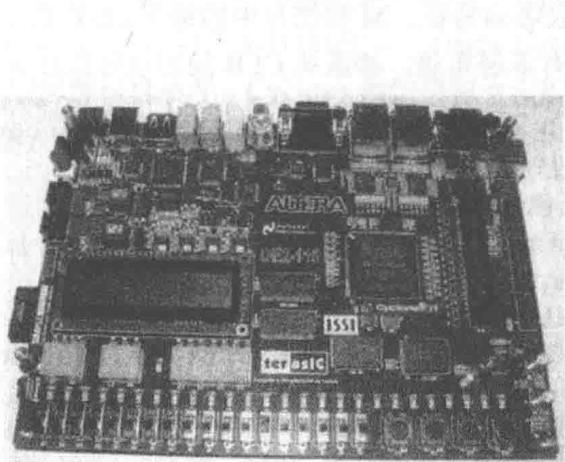 图 1-10(a) Altera DE2-115 开发板(Cyclone IV 系列)
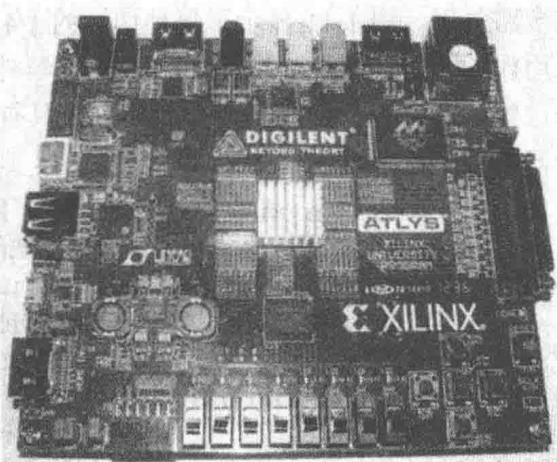 图 1-10(b) Xilinx Atlys 开发板:带 ADC/DAC 音频编码解码器
1.4.1 FPGA 的结构
21 世纪初的 FPGA 已具备实现 DSP 的关键硬件:快速进位逻辑(32 位非流水线加法器可跑 300MHz 以上)、嵌入式 18×18 乘法器和大容量存储器。两大厂商的脉络:Xilinx 由 XC4000 派生出 Spartan(低成本)和 Virtex(高性能);Altera 由 FLEX 10K 派生出 Stratix(高性能)和 Cyclone(低成本)。布线哲学不同:Xilinx 采用 FPGA 典型的分层布线,Altera 则沿袭 CPLD 的宽总线结构——但两者基本模块都已是 FPGA 式的中等颗粒度 LUT,而不是 CPLD 的大 PLA。Altera 把 LUT 称为逻辑元件(LE),若干 LE 组成逻辑阵列模块(LAB),每个 LAB 的 LE 数随代际增多:FLEX10K 每 LAB 8 个 LE,APEX20K 10 个,Cyclone II 16 个。
以 Xilinx Spartan-6 的 XC6SLX45(Atlys 板上的芯片)为例。它的基本单元叫切片(slice),分 M、L、X 三型(图 1-11):两个切片组成一个可配置逻辑模块(CLB),共 8 个 6输入LUT(或 16 个 5输入LUT)和 16 个触发器。三型的差别要记牢:约 25% 是 M 型,功能全(LUT 可当 64×1 的 RAM/ROM 用、支持 256 位分布式 RAM、128 位移位寄存器);25% 是 L 型,没有存储/移位寄存器功能;50% 是 X 型,连移位寄存器、算术进位和宽多路复用都没有。为什么这样”缺斤短两”?——省面积省成本,综合工具会按需分配。Spartan-6 还有大块存储器(每块 18432 位,不含奇偶校验位时 16384 位),可配成 、、…、:地址位每加一位,数据位宽减半,总量不变。DSP 亮点是嵌入式快速 18×18 位有符号阵列乘法器(也可做 17×17 无符号),以及 4 个完整时钟网络(DCM),让同一芯片里多个时钟域低偏斜并行运转。
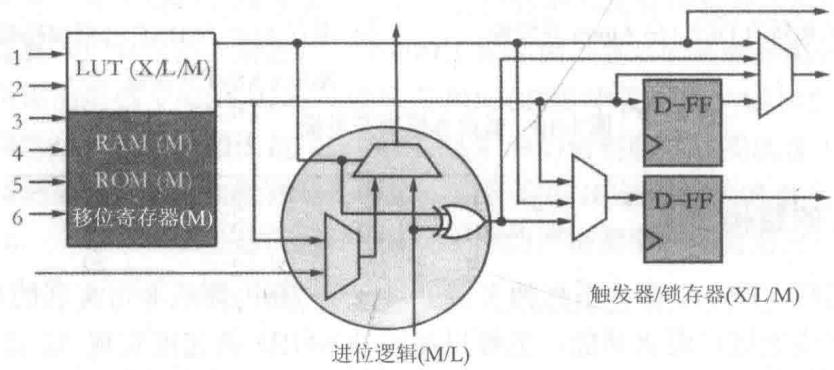 图 1-11 Spartan-6 的 1/4切片:X 型只有 LUT 与两个触发器,L 型增加快速进位逻辑,M 型具备全部特征(© Xilinx)
再看 Altera Cyclone IV 的 EP4CE115(DE2-115 板上的芯片)。其基本模块是逻辑元件(LE):一个 4 输入 1 输出 LUT(或一个 3 输入 LUT)加一个触发器,外加快速进位或”与/非”乘积项扩展电路(图 1-12)。LE 有两种模式:正常模式下当 4 输入 LUT;算法(算术)模式下当带快速进位链的 3 输入 LUT——这正是快速加法器的基础。16 个 LE 组成一个 LAB;每行至少配一个 18×18 乘法器和一个 M9K 存储块。18×18 乘法器可拆成两个 9×9 有符号乘法器用;M9K 可配置成 、、…、 的 RAM/ROM,每字节还附 1 位奇偶校验(如 256×36 配置)用于数据完整性检查。M9K 和 LAB 之间用高速宽总线连接(图 1-13),片内多个 PLL 产生低偏斜的多个时钟域。
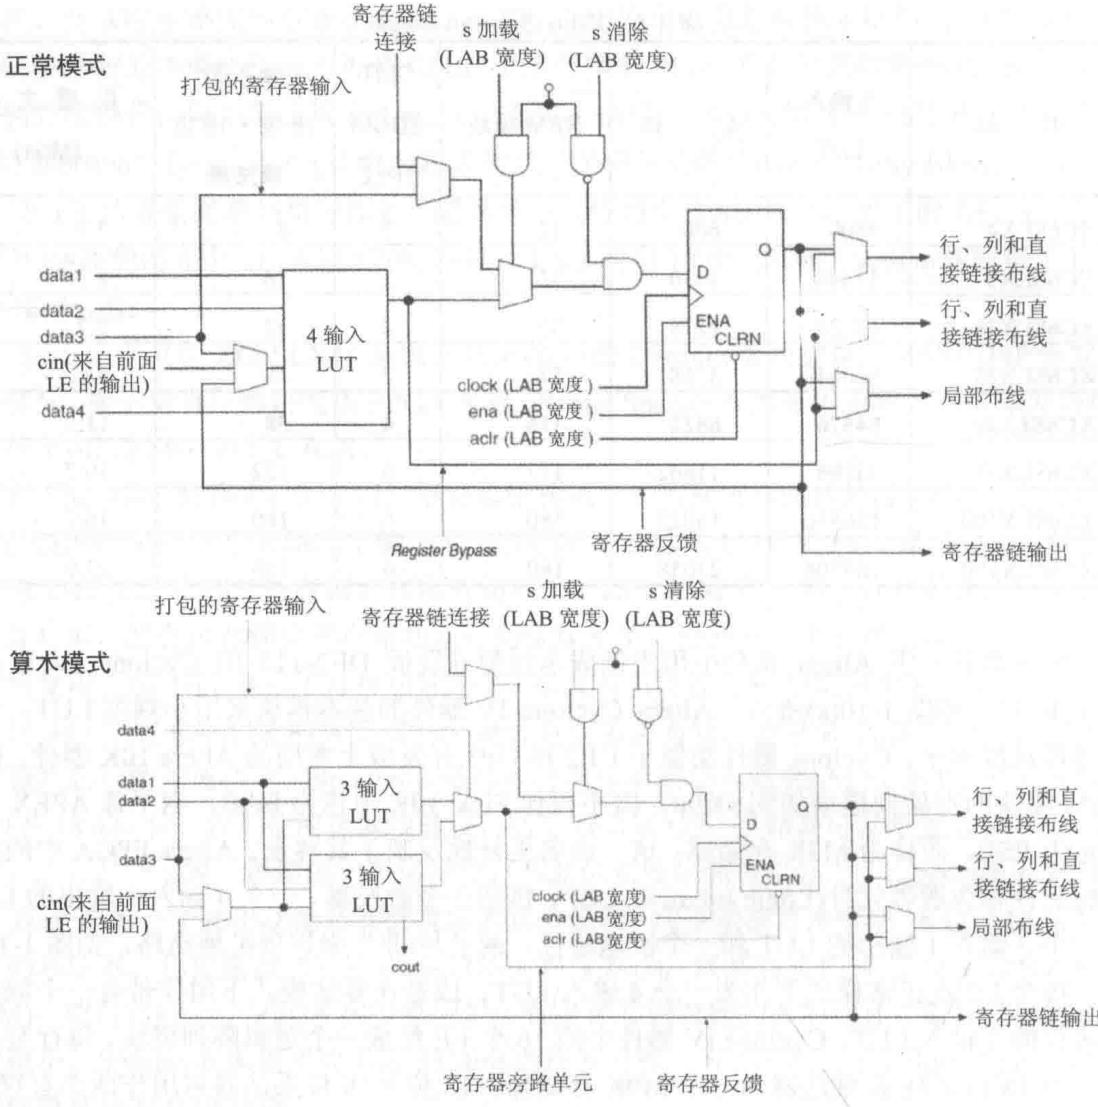 图 1-12 Cyclone IV 的逻辑单元(LE):LUT + 触发器 + 快速进位链(© Altera)
两种布线策略各有道理,值得对比记忆:Xilinx 多用局部布线、少用全局布线——这恰好契合 DSP,因为信号处理算法的数据大多是”局部流动”的(乘累加就在相邻单元间发生);Altera 的宽总线也有价值,因为 DSP 的典型操作不是逐位的”位切片”,而是把 16~32 位宽的数据矢量整体搬到下一个 DSP 模块。
1.4.2 Altera EP4CE115F29C7
本书全程使用的器件是 DE2-115 开发板上的 EP4CE115F29C7,属于 Cyclone IV E 系列。型号名不是乱码,逐段拆解:
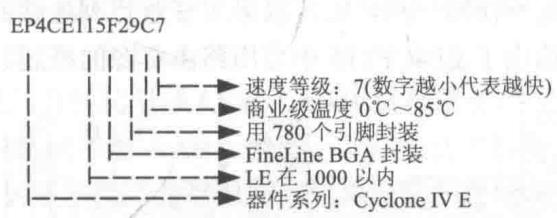 图 1-14 EP4CE115F29C7 器件命名法逐段解读(EP4 = Cyclone IV E;115 = 约 115K 逻辑单元;F29 = 29mm FBGA 封装;C7 = 商用级速度等级 7)(© Altera)
配套软件是 Altera 的 Quartus II(可从 www.altera.com 免费下载 Web 版),集成 HDL 编辑器、定时估算和位流发生器;Web 版的局限是部分器件引脚选项受限。本书所有示例在 VHDL 和 Verilog 下都可行,因此用 Xilinx ISE 编译器加 ISIM 仿真器同样能编译,其他版本的 Quartus II 可用配套的 qvhdl.tcl / qv.tcl 脚本一键编译所有实例。
1. 逻辑资源
EP4CE115 的逻辑密度约 115000 个 LE,表 1-9 给出精确数字:114480 个 LE——这也是它最多能实现的全加器数目。由这些数字可以算出几个有用的量:
- LAB 数量:16 个 LE 组成一个 LAB,故 个 LAB。注意它不等于行列乘积——器件左侧中部有 JTAG 接口区占用了 个 LAB 的位置,所以总布局不是规则矩形。
- M9K 存储块数量:器件含 6 列 M9K 存储器,列宽恰为一个 LAB,每列 72 块,故总数为 块。换算成总容量: 的片上存储。
- 嵌入式乘法器:266 个 18×18 位快速阵列乘法器;若按 9×9 使用,数量翻倍到 532 个(图 1-15)。对 DSP 来说这 266 个乘法器才是”硬通货”——它们让 266 路乘-累加可以真正并行。
2. 额外的资源和路由
数据表里不再像 FLEX10K 时代那样明确列出水平/垂直总线数目,但可以从 Quartus 的 Compiler Report(Fitter → Resource Section → Logic and Routing Section)读出整体路由资源(表 1-10)。路由分层从近到远:局部互连与直接链路(一个 LE 可驱动多达 48 个 LE)→ R4/C4 快速行列连接(到达 ±4 个 LAB 范围,或 3 个 LAB 加一个乘法器/M9K)→ R24/C16 长线(分别跨 24 行、16 列 LAB,接近横跨整片),源与目的 LAB 不同行又不同列时可组合任意行列连接;另有覆盖全片的全局时钟网络。EP4CE115 有 4 个 PLL、20 个时钟网络保证短时钟偏移;每个 PLL 有 5 个输出计数器,可产生不同频率或相位偏移——例如 DE2 板的 DRAM 需要 0 和 −3ns 的时钟偏移,就由一个 PLL 直接生成。
控制信号方面要注意一个限制:同一 LAB 内 16 个 LE 共享相同的同步清零/置载信号,以及两个异步清零、两个时钟、两个使能。DSP 设计常用宽总线,一个 LAB 往往装不下一条完整总线,控制信号的自由度因此受限,这是综合工具布局时必须权衡的。LAB 本地互联可由行/列总线或本 LAB 的 LE 驱动,邻近的 LAB、PLL、存储块、乘法器也能驱动它。不同层级连接的延迟差异很大,综合工具会尽量把关联逻辑摆放得彼此靠近以压低互连延迟——例如一个 32 位加法器最好落在上下相邻两行的两个 LAB 里。
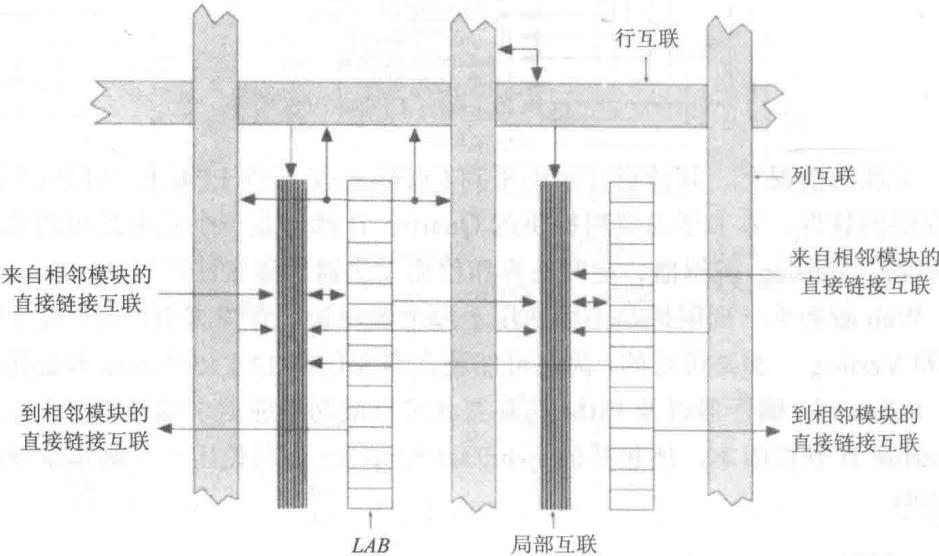 图 1-13 Cyclone IV 逻辑阵列模块(LAB)及其路由资源(© Altera)
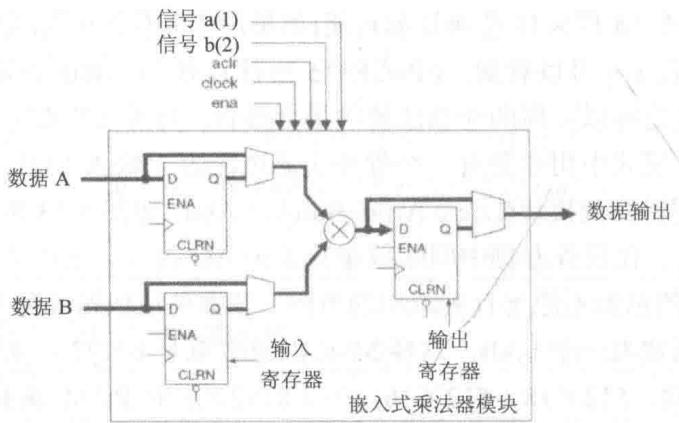 图 1-15 嵌入式乘法器的体系结构:一个 18×18 乘法器可拆分为两个 9×9(© Altera)
3. 定时估算
早期的 Quartus II 与 ISE 只有两个优化目标:面积或速度。但如今器件密度大增、片上系统带多时钟域、I/O 有多种时钟模式还有分频器,单纯”面积或速度”的二选一不再够用。Altera 改用基于概要设计约束(SDC)文件的时序规范,更接近 ASIC 的设计风格。流程是:综合工具先满足时序约束,再优化面积。同一个电路,工具可以选用不同库元素(脉动进位、进位保存、超前进位加法器等)来达标。一个实用技巧是”过约束/欠约束”:若不给 SDC 文件而假定 1GHz 的目标性能,设计会被过度约束——工具会拼命提速;若只想压面积,就设一个较低的目标时钟。本书的设计示例只关心速度,用默认设置(无 SDC 文件)按 1GHz 过约束运行即可;编译报告里会报”定时未满足”的警告,这是可预见的,不必理会。动手之前对设计规模做大致评估、再决定优化方向,是值得养成的习惯。
例 1.2:一个 32 位加法器到底能跑多快
为什么要在动手之前先估算速度
在 FPGA 里做数字信号处理,最先碰到的现实问题往往不是”功能对不对”,而是”速度够不够”。加法器是几乎所有 DSP 电路的基本零件,所以教材用”32 位加法器”这个最简单的例子,示范如何在写代码之前就粗略估计出电路的最高工作频率。学会这种”纸面估算”,你就能在设计初期判断方案是否可行,而不用等到编译完才发现跑不到目标频率。
从进位链说起:理想情况的上限
FPGA 里的加法器不是拿零散的逻辑门拼出来的。以 Altera Cyclone IV 为例,一个 LAB(Logic Array Block,逻辑阵列块,就是一小组排在一起的逻辑单元)内部有一条”快速进位链”——一条专供进位信号高速横向传递的硬连线。32 位加法器大约占用两个 LAB,进位信号要从一个 LAB 串到另一个 LAB。
进位链上”进位输入到进位输出”这一段的延迟,对 Cyclone IV 第 7 速度等级(C7)的芯片约为 66ps(皮秒,1ps = 10⁻¹² 秒)。如果只看这段,理论上限是:
这是”只算进位链”的理想值。实际电路里,数据从寄存器出发、穿过加法器、再被下一个寄存器捕获,途中还有好几段额外延迟,任何一段都不能省。
把整条路径的延迟一段段加起来
一次完整的”寄存器到寄存器”加法,要经过这些环节:
- (寄存器时钟到输出延迟)= 232ps:时钟沿到来后,源寄存器把数据送出来所需的时间。
- (互连延迟)= 501ps:数据从源寄存器经过布线到达第一个全加器的时间。
- (第一次进位生成)= 414ps:最低位产生第一个进位所需的时间——它比后续的 66ps 慢,因为要经过 LUT 计算而不是走专用进位链。
- 中间 30 位的进位传递 :注意是 30 次而不是 32 次,因为第一位由 负责。
- (末位求和)= 536ps:最高位的进位到达后,还要通过 LUT 算出完整的和位。
- (目标寄存器建立时间)= 87ps:数据必须在下一个时钟沿之前提前这么久稳定下来,才能被可靠捕获。
再考虑可能出现的时钟偏移(clock skew,即时钟信号到达不同寄存器的时间差异),额外加 82ps,总延迟估算为:
资源方面,加法器本身大约需要 32 个 LE(Logic Element,逻辑单元,FPGA 最基本的可编程单元);如果要把输入数据先寄存起来,还要额外 个 LE(请参阅练习 1.7)。